


解决Python读取图片报错:UnidentifiedImageError与路径问题
深入剖析 Python 读取图片时最常见的 UnidentifiedImageError 与路径问题的根本原因,结合文件系统机制与 Pillow 内部探测流程,提供跨平台路径规范、Magic Bytes 嗅探与工业级健壮加载方案。
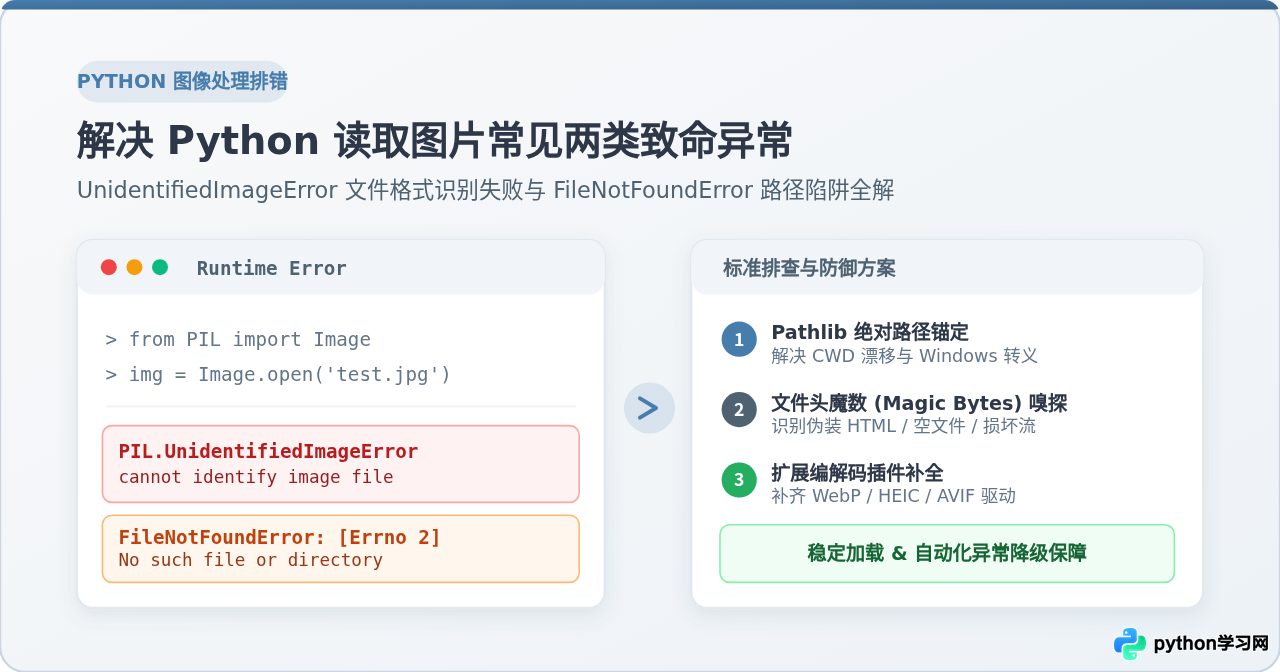
在 Python 中读取和处理图片时,初学者和工程师最常遭遇的往往不是复杂的图像算法错误,而是程序刚启动就直接终止的两类基础异常:FileNotFoundError: [Errno 2] No such file or directory 与 PIL.UnidentifiedImageError: cannot identify image file。前者源于文件系统工作目录与路径书写的脱节,后者则源于 Pillow 探测不到有效的图片二进制文件头。要彻底根治这两个问题,不需要反复试探或随意修改扩展名,只需建立清晰的物理路径锚定与文件头验证机制。
一、路径问题根源与标准跨平台解析方案
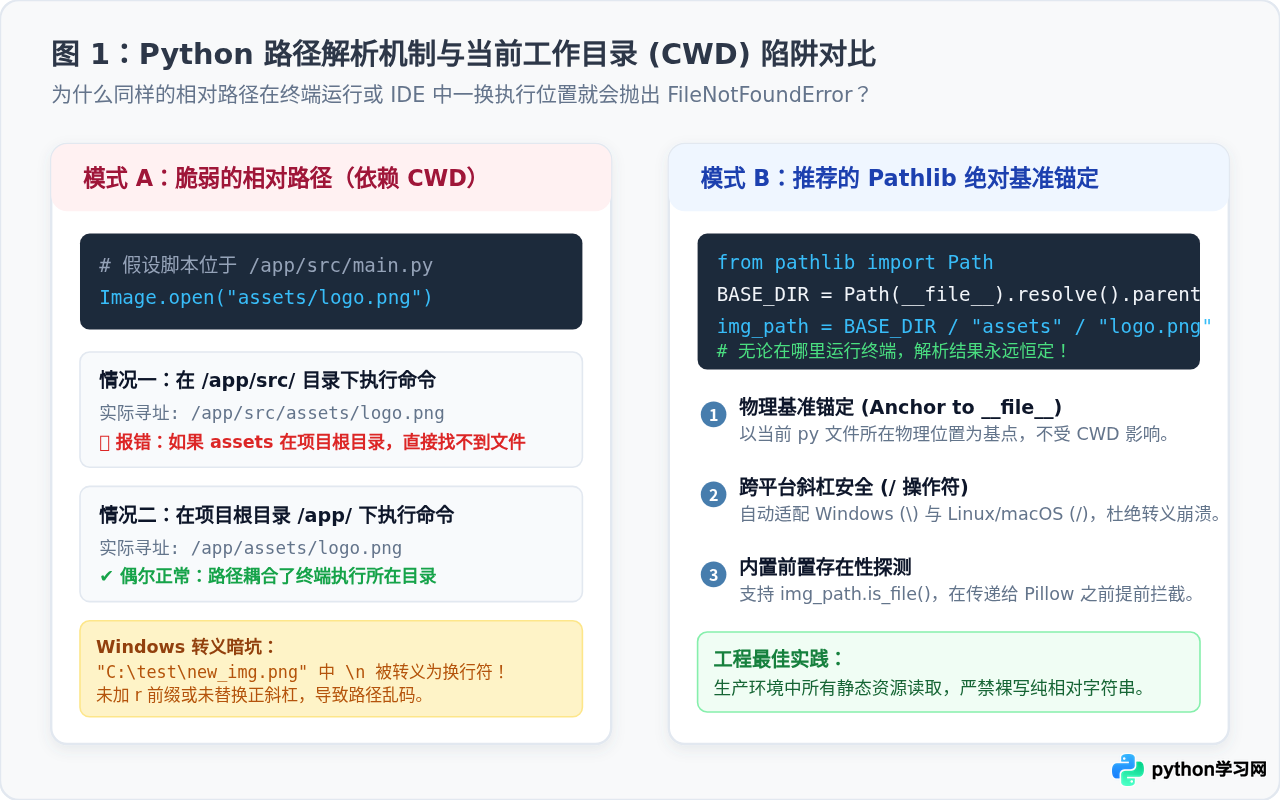
很多开发者在代码中使用类似 Image.open("images/sample.jpg") 的相对路径,本地调试时一切正常,一旦放在命令行其他目录执行、写成自动化定时任务或部署到服务器容器中,就会立刻崩溃抛出 FileNotFoundError。这类问题的根本原因在于当前工作目录(CWD, Current Working Directory)的漂移,以及 Windows 与 POSIX 系统在反斜杠转义上的天然差异。
1. 当前工作目录(os.getcwd)与脚本文件位置的脱节
当 Python 解析纯相对路径时,其基准点不是当前 .py 代码文件所在的目录,而是启动该 Python 进程时终端所在的目录。例如脚本位于 /project/src/run.py,图片位于 /project/images/test.jpg。如果你在 /project/src 目录下输入 python run.py,相对路径 images/test.jpg 会被解析为 /project/src/images/test.jpg,自然会触发文件不存在异常。
2. Windows 路径反斜杠转义灾难
在 Windows 环境下,直接复制文件管理器路径如 "C: rain
ew_dataset\images.jpg" 时,字符串内的
会被 Python 解释器隐式转义为换行符, 会被转义为制表符,导致传递给底层 C 语言文件系统的实际路径变成非法字符串,同样表现为 FileNotFoundError 或系统底层 I/O 错误。
3. 标准化修复:使用 pathlib.Path 绝对锚定
解决路径问题的工业界标准实践是:永远不要依赖终端当前工作目录,始终以 __file__ 为物理坐标系锚定绝对路径,并使用 Python 3 标准库 pathlib 统一跨平台斜杠。
from pathlib import Path
from PIL import Image

# 1. 获取当前脚本所在的绝对物理目录
CURRENT_DIR = Path(__file__).resolve().parent

# 2. 向上或向同级定位资源路径(使用 / 操作符,Windows与Linux全兼容)
IMAGE_PATH = CURRENT_DIR / "assets" / "sample.jpg"

# 3. 前置防御断言
if not IMAGE_PATH.is_file():
    raise FileNotFoundError(f"未找到目标图片文件,实际解析路径为: {IMAGE_PATH}")

# 4. 安全读取
with Image.open(IMAGE_PATH) as img:
print(f"成功打开图片: {img.format}, 尺寸: {img.size}, 模式: {img.mode}")Image.open() 前显式打印 print(IMAGE_PATH.resolve()) 与 print(IMAGE_PATH.exists()),可以在 1 秒钟内验证文件系统物理层是否存在该文件。
二、深入剖析 UnidentifiedImageError:Pillow 是如何识别图片的?
当路径确认百分之百无误,却收到了 PIL.UnidentifiedImageError: cannot identify image file 时,很多人的第一反应是怀疑文件名后缀写错了,甚至尝试把 .png 改成 .jpg。然而,Pillow 从来不根据文件后缀名来识别图片格式,修改后缀无法解决任何实质问题。
1. 延迟加载与魔数(Magic Bytes)匹配机制
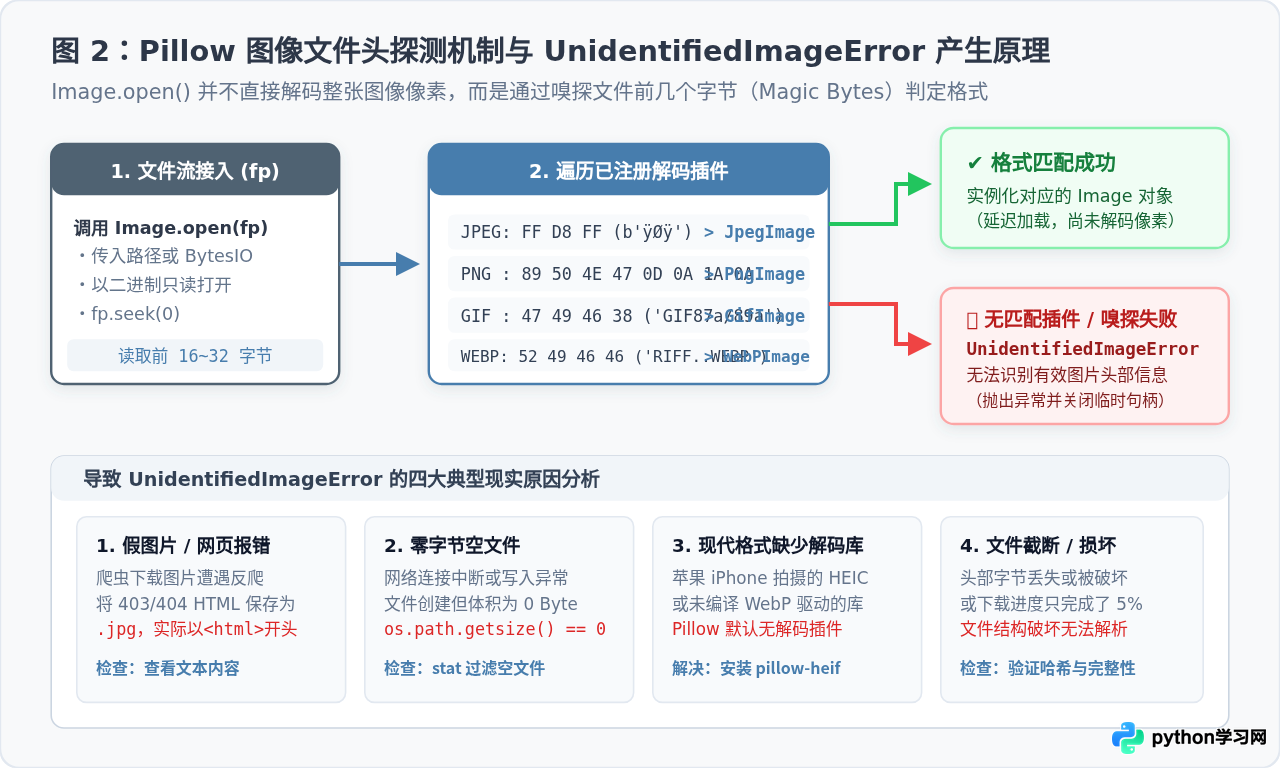
Pillow 在执行 Image.open(fp) 时并不会一次性把全部图像数据解压缩到内存中(这是为了节省内存的惰性延迟加载设计)。它所做的事情非常明确:
- 打开文件流,将文件指针定位到起始位置
fp.seek(0); - 读取文件的前 16 到 32 个字节(即所谓的文件头特征码或魔数 Magic Bytes);
- 遍历 Pillow 内部注册的图像插件列表(如 JpegImagePlugin、PngImagePlugin、GifImagePlugin 等),逐一比对特征头;
- 如果匹配到对应格式,则实例化该格式的图像对象并返回;若遍历完所有支持的插件都无法匹配,立即抛出
UnidentifiedImageError。
2. 引发 UnidentifiedImageError 的四大现实根源
① 伪装成图片的 HTML 文本
爬虫或脚本自动下载图片时,目标服务器返回了 403 Forbidden、404 Not Found 或验证码页面。代码将返回内容直接写入了 test.jpg,但其实文件内容以 <!DOCTYPE html> 开头,Pillow 无法识别。
② 零字节空文件 (0 Byte)
程序在上一步创建了文件句柄或网络传输中断,创建了空文件。空文件无法读出任何字节,Pillow 嗅探不到任何魔数,必然报错。
③ 现代图像格式缺少编解码插件
iOS 设备拍摄的 HEIC/HEIF 格式,或者极简 Docker 环境中缺少动态链接库的 WebP、AVIF 格式。Pillow 核心未注册对应解码器,导致无法认出合法图片。
④ 文件头损坏或严重截断
网络流只下载了部分数据便强行关闭,或者磁盘坏道损坏了起始的数十个关键字节,破坏了图像签名结构。
三、快速诊断实操:三行代码揪出坏图本质
当遇到 UnidentifiedImageError 时,不要盲目猜测,可以通过 Python 原生代码直接读取文件的前 32 个字节并打印十六进制与文本表征,真凶立刻无所遁形:
from pathlib import Path

file_path = Path("problem_image.jpg")

# 1. 检查文件物理大小
file_size = file_path.stat().st_size
print(f"文件大小: {file_size} 字节")

# 2. 读取前 32 个字节特征码
with open(file_path, "rb") as f:
    header = f.read(32)

print(f"十六进制 Header: {header.hex(' ')}")
print(f"ASCII/文本 表征: {header}")- 如果
file_size == 0:属于典型的下载中断或保存空对象,需排查数据生成端逻辑; - 如果输出包含
b'<!DOCTYPE'或b'<html':属于爬虫未携带 Cookie/User-Agent 导致的拦截页面; - 如果输出以
b'ÿØÿ'开头:说明这是标准 JPEG 格式;若依然报错,可能是后续标记块严重损坏; - 如果输出以
b'ftypheic'或b'ftypmif1'开头:说明这是 HEIC 格式,需要补齐解码库。
四、工程级健壮图片加载五步排查流水线
为了在生产批量数据处理(如机器学习数据集加载、相册批处理服务)中兼顾健壮性与排错效率,推荐采用分层防御流水线。
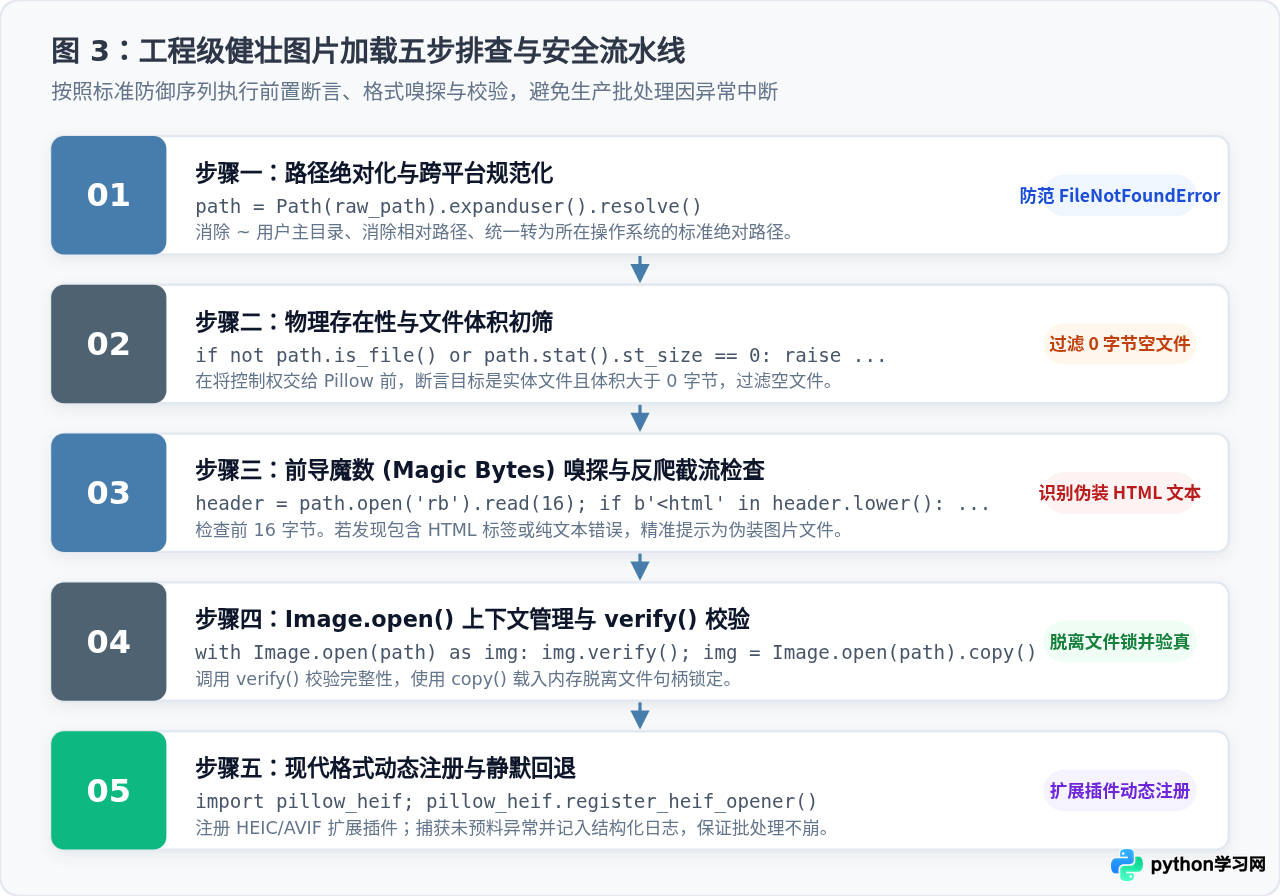
五步流水线实现代码
from pathlib import Path
from PIL import Image, ImageFile
import logging

# 配置日志
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("ImageLoader")

# 可选:允许加载轻微截断但仍可渲染的破损图片(按需开启)
# ImageFile.LOAD_TRUNCATED_IMAGES = True

def safe_load_image(raw_path: str | Path) -> Image.Image | None:
    """
    工业级健壮图片读取函数:
    1. 跨平台绝对路径规范化
    2. 物理文件与非空初筛
    3. 假图片文本头嗅探
    4. 惰性加载与 verify 校验
    5. 安全隔离与返回
    """
    # 步骤一:规范化绝对路径
    path = Path(raw_path).expanduser().resolve()

    # 步骤二:存在性与体积过滤
    if not path.exists():
        logger.error(f"[FileNotFound] 文件不存在: {path}")
        return None
    if not path.is_file():
        logger.error(f"[NotAFile] 目标并非实体文件: {path}")
        return None
    if path.stat().st_size == 0:
        logger.error(f"[EmptyFile] 图片文件体积为 0 字节: {path}")
        return None

    # 步骤三:前置魔数嗅探
    try:
        with open(path, "rb") as f:
            header = f.read(16)
            if b"<html" in header.lower() or b"<!doctype" in header.lower():
                logger.error(f"[FakeImage] 文件内容实际为 HTML 页面: {path}")
                return None
    except Exception as e:
        logger.error(f"[IOError] 读取文件头失败: {e}")
        return None

    # 步骤四与五:安全调用 Pillow 与校验
    try:
        # 先以上下文管理器打开并验证
        with Image.open(path) as img:
            # 校验图片文件头与结构是否有效
            img.verify()

        # 注意:verify() 之后必须重新 open 才能正常操作像素
        # 使用 copy() 将图像载入内存,彻底关闭文件句柄,避免占用系统资源
        with Image.open(path) as img:
            loaded_img = img.copy()
            return loaded_img

    except Image.UnidentifiedImageError:
        logger.error(f"[UnidentifiedImageError] Pillow 无法识别图片格式: {path}")
        return None
    except OSError as e:
        logger.error(f"[CorruptedImage] 图片数据损坏或截断: {path}, 详细: {e}")
        return None
五、特殊现代格式支持:解决 HEIC 与 WebP 的缺失
如果业务中包含 iPhone 拍摄的素材,Pillow 默认会抛出 UnidentifiedImageError。不需要自己编写复杂的转换脚本,只需通过官方推荐的外部扩展库注册解码器即可:
# 终端安装扩展包
# pip install pillow-heif

import pillow_heif
from PIL import Image

# 全局注册 HEIF / HEIC 解码插件到 Pillow
pillow_heif.register_heif_opener()

# 随后 Image.open 便可原生无缝读取 .heic 文件!
img = Image.open("IMG_2026.HEIC")
print(f"成功读取 HEIC: 尺寸 {img.size}, 格式 {img.format}")
六、报错诊断与决策速查总结
面对图片读取相关的各种异常表现,可以通过下方的排查矩阵快速对照定位,采取对应的永久修复手段:
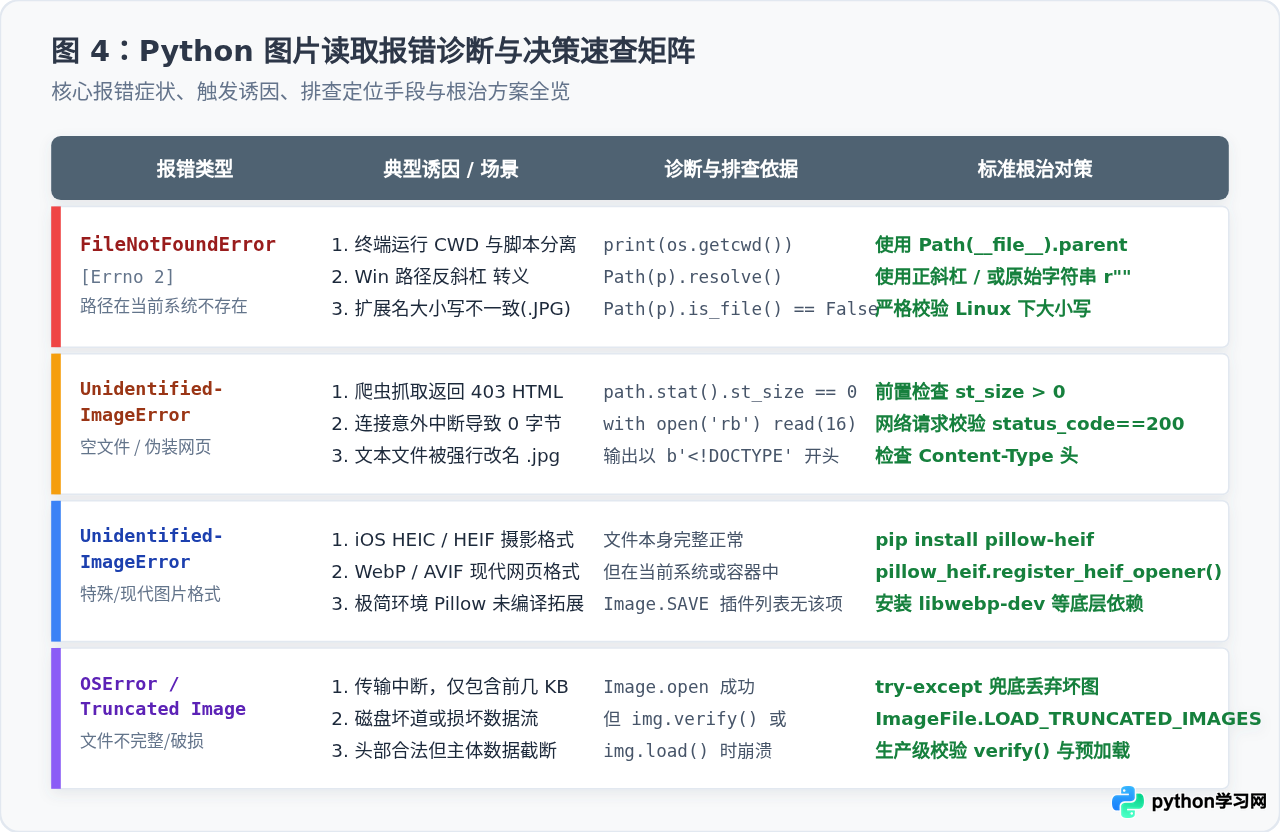
总结而言,排查 Python 图片读取报错时,首先用 Path(__file__).resolve().parent 消除当前工作目录带来的路径飘忽问题;当遭遇 UnidentifiedImageError 时,核心是查验文件的物理大小和前导字节,鉴别出 0 字节空文件与伪装 HTML 报错页;最后针对 HEIC/WebP 补齐解码插件,配合 img.verify() 规避截断数据。遵循这一规范,即可彻底摆脱图片读取中断的困扰,保障数据流水线的稳定高效运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















