


Python怎么指定Excel某列为Key生成嵌套字典
详细介绍Python将Excel指定列作为外层Key生成嵌套字典的完整方法,包含pandas的set_index与to_dict(orient='index')配合用法、openpyxl原生按行构建方案,以及重复Key、多层嵌套和空值NaN的处理方法。
在Python中把Excel的指定列作为外层字典的Key、其余列作为内层字典的键值对,最直接的做法是使用pandas库:先用df.set_index('指定列名')将该列设为行索引,再调用to_dict(orient='index')即可一步得到{外层Key: {列名: 值}}结构的嵌套字典。如果不希望引入pandas,或者需要自定义多层嵌套与重复Key合并逻辑,则可以使用openpyxl按行遍历表头与数据来组装字典。下面按具体操作步骤、重复值处理和边界细节依次展开说明。
一、转换前后的数据对应关系与示例准备
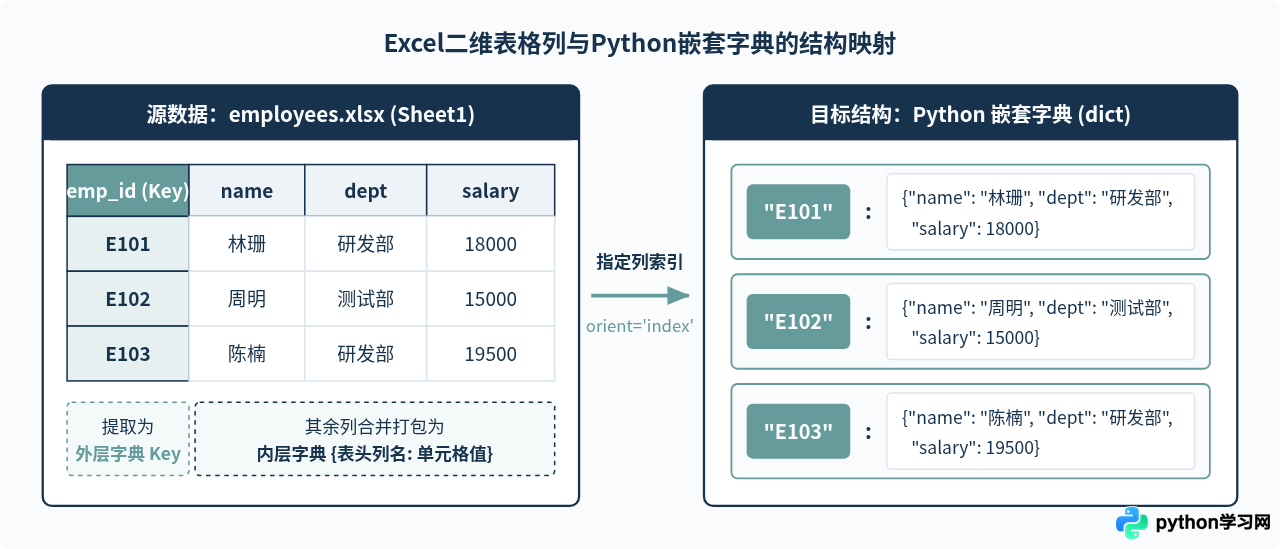
生成嵌套字典的核心逻辑,是将Excel的“二维行表结构”转换为可以通过唯一标识直接检索的“键值映射结构”。假设当前工作目录下有一个名为employees.xlsx的Excel文件,其中的工作表Sheet1包含以下4列数据:
| emp_id | name | dept | salary |
|---|---|---|---|
| E101 | 林珊 | 研发部 | 18000 |
| E102 | 周明 | 测试部 | 15000 |
| E103 | 陈楠 | 研发部 | 19500 |
当我们指定emp_id列作为外层字典的Key时,每一行的emp_id单元格值(如"E101")都会提取为顶层键,而同一行剩余的name、dept、salary三列则自动组成一个内层字典作为对应的Value。具体映射结构如下图所示:
二、使用 pandas 指定列生成嵌套字典(标准做法)
在日常数据处理中,pandas提供了最简洁的转换链路。执行代码前,需要确保Python环境中已经安装了pandas以及用于读取.xlsx格式文件的openpyxl引擎。可以在终端或命令行中执行以下命令完成安装:
pip install pandas openpyxl1. 核心实现步骤与完整代码
用pandas把某列变成外层Key,关键在于先将该列设为DataFrame的行索引(Index),然后按“行索引方向(orient='index')”导出字典。新建一个Python脚本(例如excel_to_nested_dict.py),与employees.xlsx放在同一目录下:
import pandas as pd
from pprint import pprint

# 1. 读取 Excel 文件,指定 emp_id 列按字符串类型读取,防止工号或编号前导零丢失
df = pd.read_excel("employees.xlsx", sheet_name="Sheet1", dtype={"emp_id": str})

# 2. 将指定列 emp_id 设为行索引,并按 index 模式导出为嵌套字典
nested_dict = df.set_index("emp_id").to_dict(orient="index")

# 3. 打印结果并按键查询测试
pprint(nested_dict)
print("查询 E102 的部门:", nested_dict["E102"]["dept"])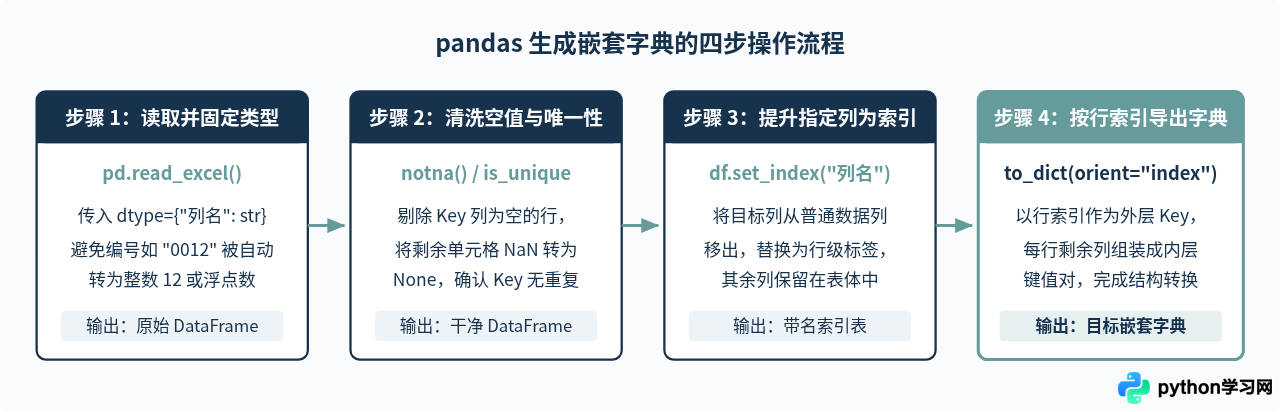
2. 为什么要写 orient="index" 而不是默认参数?
初次使用to_dict()时,一个非常容易踩的坑是不传任何参数。df.to_dict()的默认参数是orient="dict",它会把列名作为外层字典的Key、把行索引作为内层字典的Key,生成的结构正好与我们的需求相反(例如变成{'name': {'E101': '林珊', 'E102': '周明'}, ...})。只有明确传入orient="index",pandas才会以每一行的索引值作为外层Key。
默认情况下,
df.set_index("emp_id")会把emp_id列移作行索引,因此内层字典里不再包含"emp_id"这个字段。如果下游接口要求内层字典也同时保留"emp_id": "E101",只需在set_index中加上drop=False参数,即:df.set_index("emp_id", drop=False).to_dict(orient="index")。
三、使用 openpyxl 原生构建嵌套字典(不依赖 pandas)
如果编写的是轻量脚本、打包体积受限,或者只需要读取Excel而不需要做统计分析,可以直接使用openpyxl库。通过遍历表头行找到目标Key列的下标位置,再逐行构建字典,同样非常清晰。
如果尚未安装openpyxl,可执行pip install openpyxl。以下是完整的实现代码:
from openpyxl import load_workbook
from pprint import pprint


def excel_col_to_nested_dict(file_path, sheet_name, key_col_name, keep_key_in_inner=False):
    # read_only=True 适合大文件读取;data_only=True 读取公式计算后的值而非公式字符串
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    ws = wb[sheet_name]

    rows = ws.iter_rows(values_only=True)
    # 1. 提取第一行表头
    headers = next(rows, None)
    if not headers or key_col_name not in headers:
        wb.close()
        raise ValueError(f"表头中未找到指定的列: {key_col_name}")

    key_idx = headers.index(key_col_name)
    result = {}

    # 2. 逐行遍历数据并组装嵌套字典
    for row in rows:
        # 跳过整行全为空的空白行
        if row is None or all(cell is None for cell in row):
            continue

        outer_key = row[key_idx]
        if outer_key is None:
            continue

        # 统一转为字符串作为外层 Key(也可按需保留原类型)
        outer_key = str(outer_key).strip()

        inner_dict = {}
        for col_idx, col_name in enumerate(headers):
            if col_name is None:
                continue
            if not keep_key_in_inner and col_idx == key_idx:
                continue
            inner_dict[col_name] = row[col_idx]

        result[outer_key] = inner_dict

    wb.close()
    return result


if __name__ == "__main__":
    data = excel_col_to_nested_dict("employees.xlsx", "Sheet1", key_col_name="emp_id")
pprint(data)在这段代码中,load_workbook(..., data_only=True)是一个很关键的参数。如果Excel表格中的某列(比如薪资合计)是由公式=SUM(C2:D2)计算得出的,不加data_only=True时读出来的值会是字符串"=SUM(C2:D2)",加上之后才会读取Excel上次保存时缓存的计算结果数值。
四、进阶场景:Key列存在重复值、多层嵌套与空值处理
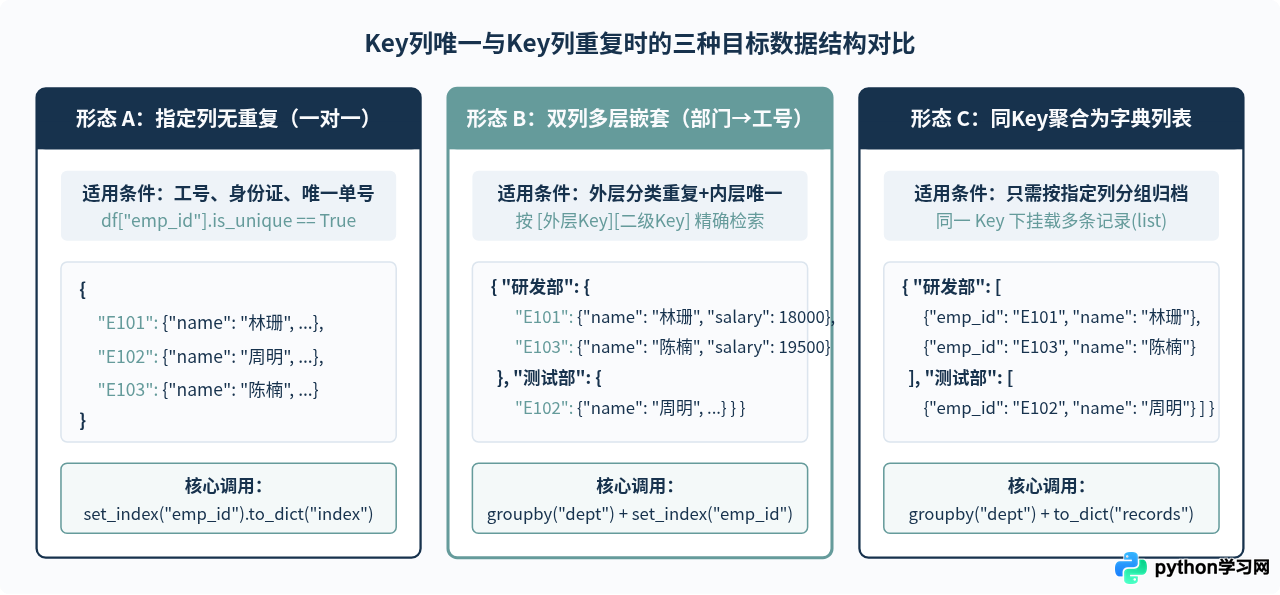
前面的示例默认指定列(如工号emp_id)在表中每一行都是唯一的。但实际业务里,我们经常会指定“部门(dept)”“城市”或“订单日期”这类存在重复值的列作为外层Key。此时如果直接调用df.set_index("dept").to_dict(orient="index"),pandas会直接抛出报错:
报错的原因很简单:Python字典的同一个Key在同一层只能对应一个Value。如果多行数据的dept都是"研发部",直接映射必然发生覆盖冲突。针对这种情况,通常有两种合理的解决结构,如下图所示:
1. 方案一:指定两列生成双层嵌套字典(外层分组Key + 内层唯一Key)
如果我们希望以dept(部门)作为第一层Key,再以emp_id(工号)作为第二层Key,生成{部门: {工号: {其余列: 值}}}的三级嵌套结构,可以先用groupby按外层列分组,再对每个分组子表调用set_index().to_dict("index"):
import pandas as pd
from pprint import pprint

df = pd.read_excel("employees.xlsx", sheet_name="Sheet1", dtype={"emp_id": str})

# 先按 dept 分组,再把每个分组内的 emp_id 设为二级 Key(drop(columns="dept") 用于去掉内层冗余的部门列)
multi_nested_dict = {
    dept: group.drop(columns="dept").set_index("emp_id").to_dict(orient="index")
    for dept, group in df.groupby("dept", sort=False)
}

pprint(multi_nested_dict)
print("研发部 E103 的薪资:", multi_nested_dict["研发部"]["E103"]["salary"])2. 方案二:重复Key仅保留首条/末条,或聚合为字典列表
如果表格中的重复Key属于录入重复,只需要保留第一条或最后一条记录,可以在set_index之前先调用drop_duplicates去重:
# 情况 A:重复 Key 仅保留最后出现的一行(keep='first' 则保留第一行)
dedup_dict = (
    df.drop_duplicates(subset=["dept"], keep="last")
    .set_index("dept")
    .to_dict(orient="index")
)

# 情况 B:将同一个 dept 下的多行打包为内层字典列表 (orient='records')
grouped_list_dict = {
    dept: group.drop(columns="dept").to_dict(orient="records")
    for dept, group in df.groupby("dept", sort=False)
}
3. 处理 Excel 空白单元格产生的 NaN
用pandas读取Excel时,表格里的空白单元格会被默认转换成浮点数nan(float('nan'))。如果生成的嵌套字典后续要通过json.dumps()序列化为标准JSON,或者写入数据库,nan经常会导致解析报错或异常。此外,如果作为Key的那一列本身存在空行,还会产生以nan为Key的脏数据。建议在转换前加上两行清洗代码:
import pandas as pd

df = pd.read_excel("employees.xlsx", sheet_name="Sheet1", dtype={"emp_id": str})

# 1. 过滤掉指定 Key 列为空的行
df = df.dropna(subset=["emp_id"])

# 2. 将其余列中的 NaN 统一替换为 Python 的 None(也可替换为 "" 空字符串)
df = df.astype(object).where(df.notna(), None)

# 3. 生成干净的嵌套字典
clean_dict = df.set_index("emp_id").to_dict(orient="index")注意上面第2步先调用了df.astype(object)再执行where(df.notna(), None)。这是因为在部分pandas版本中,数值列(如float64)直接替换None仍会被自动转回NaN,先转为object类型可以确保空单元格真正变成Python的None对象。
五、实现方案选型与关键细节总结
在实际项目中选择哪种方式将Excel指定列转为嵌套字典,可以根据数据特征、Key列是否唯一以及运行环境依赖直接对照下表和总结图进行决策:
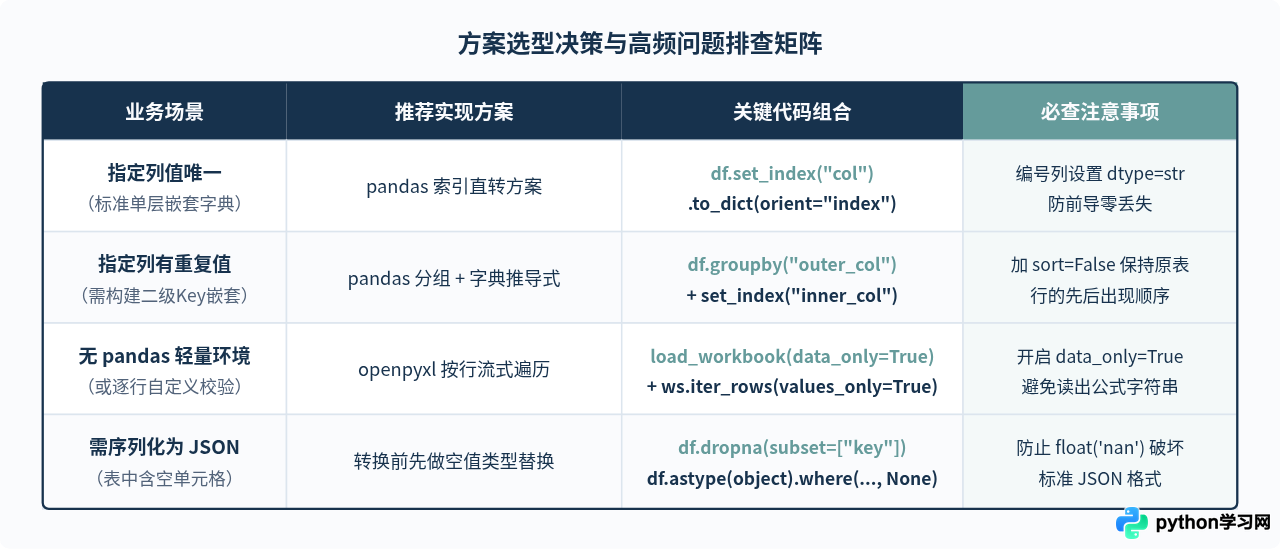
最后,如果Excel表格中包含日期列(如入职日期),pandas默认会将其解析为Timestamp对象,转换成字典后值会显示为Timestamp('2025-03-15 00:00:00')。若希望字典中直接保存"2025-03-15"这样的字符串,只需在调用set_index之前,先对该列执行df["入职日期"] = pd.to_datetime(df["入职日期"]).dt.strftime("%Y-%m-%d")格式化,生成的嵌套字典就能直接用于接口传输或文件存储。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















