


怎么构建Python基础知识体系?核心概念图解与逻辑梳理
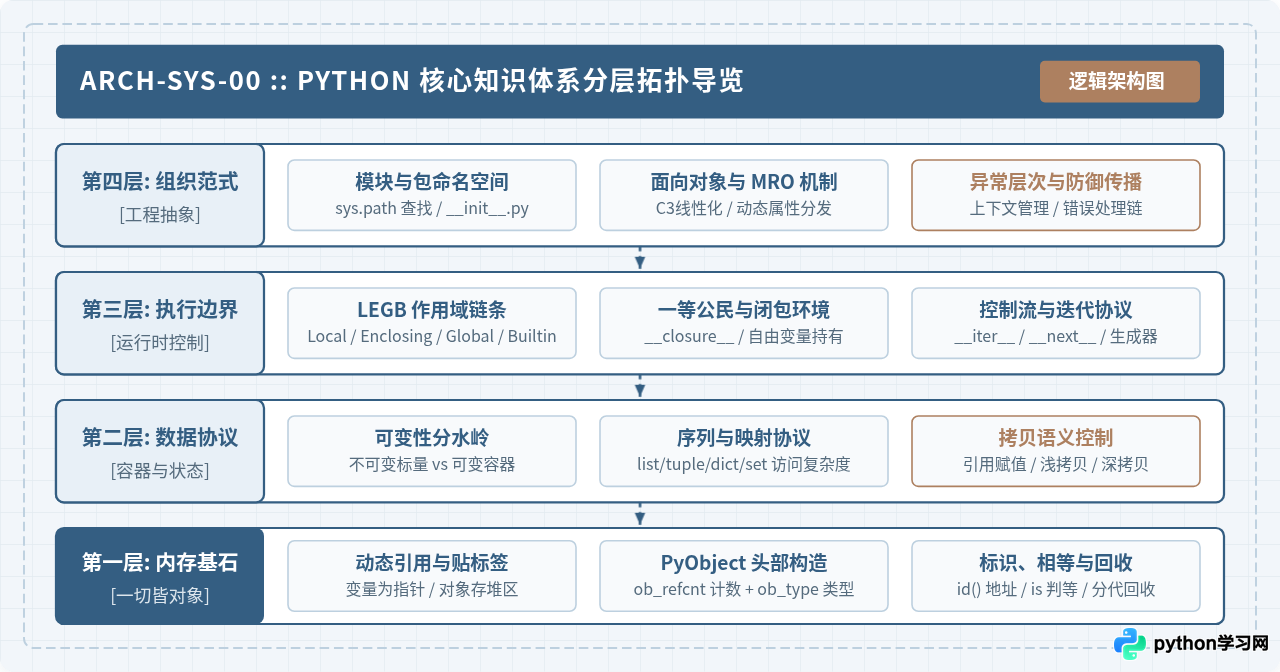
本文系统梳理构建Python基础知识体系的内在逻辑与方法,通过动态引用模型、数据协议分类、LEGB作用域以及模块工程四层递进结构,配合工程图解与可验证代码,帮助学习者建立自洽稳定的Python心智模型。
构建Python基础知识体系的核心,不是孤立记忆语法规则和内置函数,而是沿着语言底层的运行机制建立逻辑骨架。Python在运行时的底层模型具有高度的一致性:以“一切皆对象与动态引用”为基石,通过“数据模型与协议”界定状态边界,借助“LEGB作用域”管理执行上下文,最终通过“模块与类机制”完成高阶抽象。读者只需沿着“内存引用—数据分类—执行边界—工程组织”四个连续层级推进,并用可观测的代码现象逐一验证,就能摆脱零碎记语法的困境,形成逻辑自洽的知识体系。
一、体系基石:理解“一切皆对象”与动态引用模型
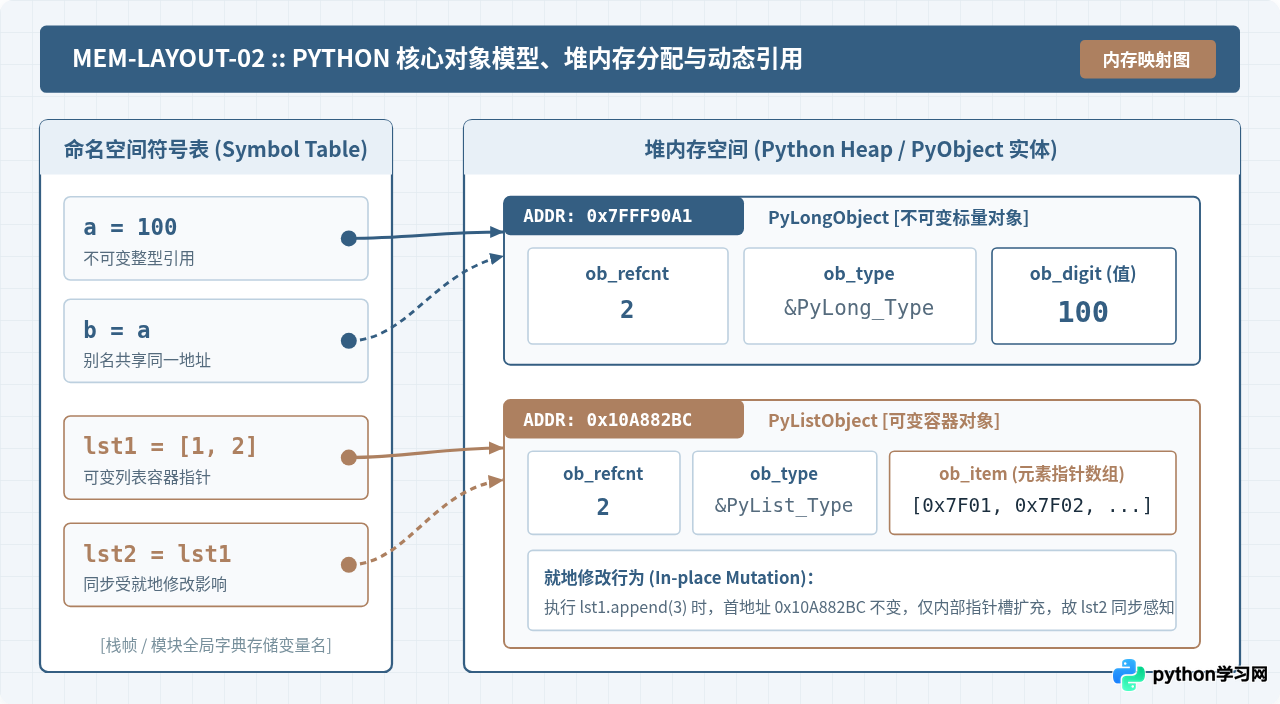
许多初学者将变量理解为“存放数据的盒子”,这种源自C语言的观念在Python中会导致许多逻辑断层。在Python的世界里,变量是贴在对象上的标签,实质是指向堆内存中对象的引用指针。当执行 x = 100 时,Python解释器会在堆内存中开辟空间创建一个 PyLongObject(整型对象),然后在当前命名空间符号表中记录名字 x,并将 x 指向该对象的内存地址。
在CPython底层,每一个对象都由统一的 PyObject 结构体定义,其头部至少包含两个核心字段:
- ob_refcnt(引用计数):记录当前有多少个变量或容器正指向该对象。当计数降为0时,内存由垃圾回收机制回收。
- ob_type(类型指针):指向该对象的具体类型描述符(如
PyLong_Type、PyList_Type),类型信息挂载在对象自身而非变量名上。这就是Python“动态强类型”的本质。
理解动态引用模型后,许多基础概念的逻辑便迎刃而解:
1. 变量赋值与别名共享
执行 b = a 时,并没有在内存中复制对象,而是在符号表中增加了名字 b,并使其指向 a 当前指向的同一对象。此时该对象的引用计数加1。
# 验证引用地址相同
a = [10, 20, 30]
b = a
print(id(a) == id(b))  # 输出示例: True
print(a is b)           # 输出示例: True
2. 判等操作符的逻辑分界(is 与 ==)
体系中必须严格区分两个判定操作:is 判定两个变量指向的内存地址是否相同(即比较 id(x) == id(y));而 == 调用对象的 __eq__ 魔术方法,比较内部持有的数据内容是否等价。
[-5, 256])是解释器实现的内部优化细节,不应作为通用逻辑依赖。在工程代码中,除了判定单例对象 None 时必须使用 is None,其余数值与内容比较必须统一使用 ==。
二、数据分类:根据内存特征与协议划分类型边界
掌握了对象与引用后,知识体系的第二层是归纳内置数据类型的分类逻辑。不要按“数字、字符串、列表、字典”平铺记忆,而应依据“可变性(Mutability)”与“访问协议”两个核心维度构建坐标系。
| 分类维度 | 典型类型 | 内存修改特征 | 哈希支持(__hash__) | 常见应用与约束 |
|---|---|---|---|---|
| 不可变标量/序列 | int, float, bool, str, tuple | 内容不可更改,修改产生新对象 | 支持(tuple需元素均可哈希) | 可安全充当字典键或集合元素 |
| 可变容器(序列) | list, bytearray | 支持就地修改(In-place),地址不变 | 不支持(TypeError: unhashable) | 高效动态增删,存在别名共享副作用 |
| 可变容器(映射/集合) | dict, set | 基于哈希表实现,键/元素动态维护 | 不支持可变容器自身哈希 | 查找时间复杂度为 O(1),空间换时间 |
1. 就地修改的传播效应
不可变对象在发生运算时,始终重新开辟内存分配新对象;而可变对象调用方法(如 append、extend)时,对象首地址保持恒定,仅内部槽位指针发生变化。所有指向该对象的别名变量都会立即观察到此项变更。
# 可变对象的就地修改
x = [1, 2]
y = x
x.append(3)
print(y)  # 输出示例: [1, 2, 3],y 与 x 共享同一块堆内存

# 不可变对象的重新绑定
m = 10
n = m
m += 1
print(n)  # 输出示例: 10,m 指向了新对象 11,n 仍然指向 10
2. 浅拷贝与深拷贝的边界
为了规避别名共享导致的意外副作用,必须掌握对象的复制语义:
- 切片与浅拷贝(
copy.copy):创建顶层新容器,但容器内的子元素依然是指向旧对象引用的指针。 - 深拷贝(
copy.deepcopy):递归遍历源对象的所有嵌套层级,并在内存中完全复刻一份拓扑结构,彻底切断所有引用关联。
三、执行流与边界:作用域 LEGB 与闭包机制
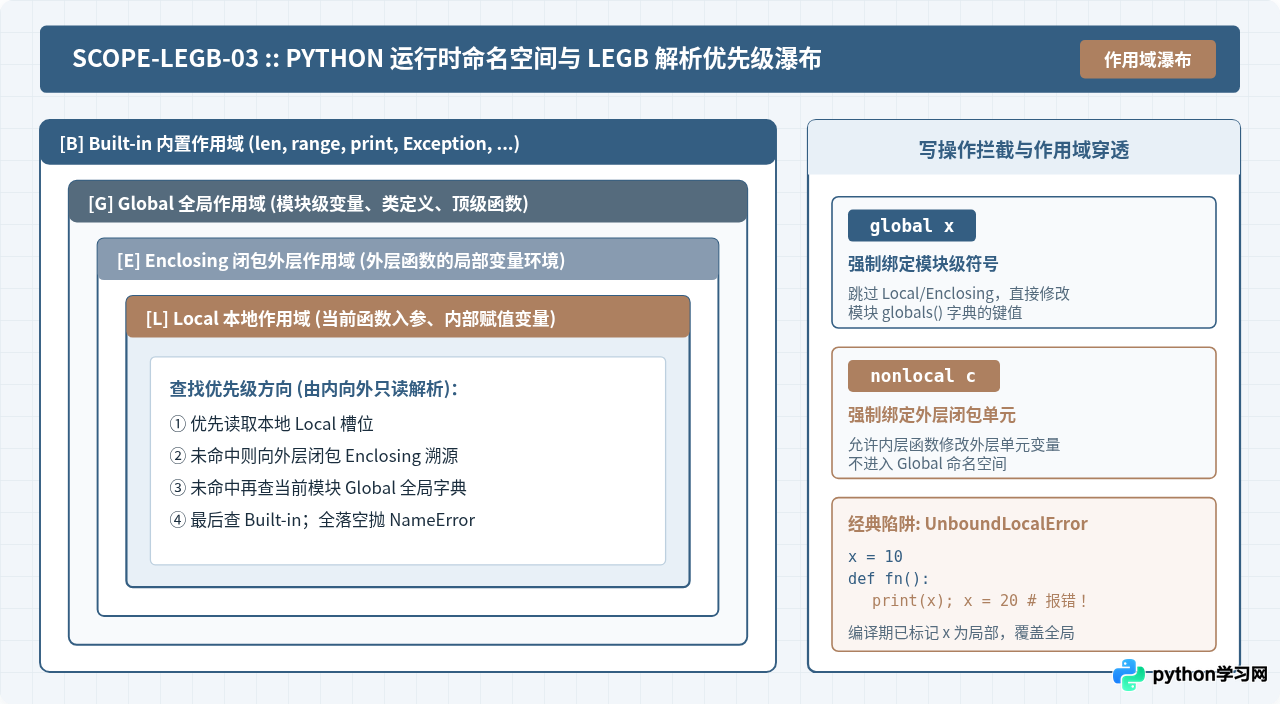
在理解了数据在内存中的静态布局后,体系的第三层是梳理代码在执行时的命名解析流程。Python在遇到一个未经修饰的标识符时,遵循严格的 LEGB 规则 逐层向外查找:
1. LEGB 查找次序与范围界定
- Local(局部作用域):当前函数或 lambda 表达式内部声明的入参与局部变量。
- Enclosing(闭包外层作用域):若存在嵌套函数,位于外层包裹函数内部的局部变量环境。
- Global(全局作用域):当前模块文件顶级声明的变量,在模块内通过
globals()字典维护。 - Built-in(内置作用域):Python运行环境预设的符号,如
len,range,ValueError等。
2. 变量绑定决策与 UnboundLocalError 机制
Python的作用域决议是在编译期(生成字节码阶段)而非执行期静态判定的。若函数体内部任意位置存在对某个变量名的赋值操作(如 x = ...),编译器会预先将该符号打上局部变量(Local)标签。
如果在赋值语句执行前先尝试读取该符号,解释器不会回退到全局作用域寻找同名变量,而是直接抛出 UnboundLocalError。
# 典型作用域陷阱
count = 10

def update_counter():
    # 尝试直接累加全局变量会报错
    # count = count + 1  # 抛出: UnboundLocalError: local variable 'count' referenced before assignment
    global count
    count += 1
    return count

print(update_counter())  # 输出示例: 11
3. 函数作为“一等公民”与闭包封装
在Python中,函数本身也是一个普通的 PyFunctionObject 实例,可以作为变量赋值、作为入参传递,或作为另一函数的返回值。当内层函数引用了外层函数的变量并被返回时,便构成了闭包(Closure)。
外层函数的局部命名空间即使在执行结束后也不会被完全销毁,而是通过 __closure__ 属性中的 cell 对象持久化持有状态。当需要修改外层闭包变量时,必须使用 nonlocal 显式声明。
def make_accumulator(initial_value):
    total = initial_value  # 自由变量,被内部函数捕获
    def add(delta):
        nonlocal total     # 穿透到 Enclosing 层级进行绑定修改
        total += delta
        return total
    return add

acc = make_accumulator(100)
print(acc(20))  # 输出示例: 120
print(acc(30))  # 输出示例: 150
四、结构抽象:模块边界、面向对象与异常传播
知识体系的第四层是代码的工程化组织范式。单文件内的函数与变量需要通过模块、面向对象机制以及健壮的异常链组合为稳固的系统。
1. 模块的单例加载机制
Python中每一个 .py 文件就是一个独立的模块命名空间。当首次执行 import my_module 时,解释器会检索 sys.path 中的路径,加载并执行该文件,然后将生成的模块对象缓存在 sys.modules 字典中。后续在任何其他文件中再次导入同一模块,均直接复用该缓存对象。这一机制保证了模块级状态在整个进程生命周期内的单例性。
2. 面向对象:属性分发与 MRO(方法解析顺序)
Python类通过 __dict__ 字典维护自身属性与方法。当通过实例访问 obj.attr 时,属性查找的优先级为:
- 首先检查实例对象自身的
obj.__dict__; - 若未命中,顺着实例所属类的继承拓扑向上查找;
- 多继承场景下,Python采用 C3 线性化算法 确定唯一的 MRO 顺序(可通过
ClassName.__mro__查看),杜绝了经典菱形继承的二义性冲突。
3. 异常树结构与防御分层
异常不是简单的报错字符串,而是组织为树状继承体系的类层次结构。顶级基类为 BaseException,常规业务异常均派生自 Exception。构建知识体系时,捕获逻辑必须遵循“从具体到通用”的先后次序,避免滥用 except: 截断 KeyboardInterrupt 或 SystemExit 等系统级控制信号。
五、实施方法:构建知识体系的四步递进路径与验证闭环
建立自洽的Python知识体系不需要漫无目的地刷题,而应遵循可验证的工程实施路径。按照以下四步逐级推进,每一步都必须产出对应的检验成果:
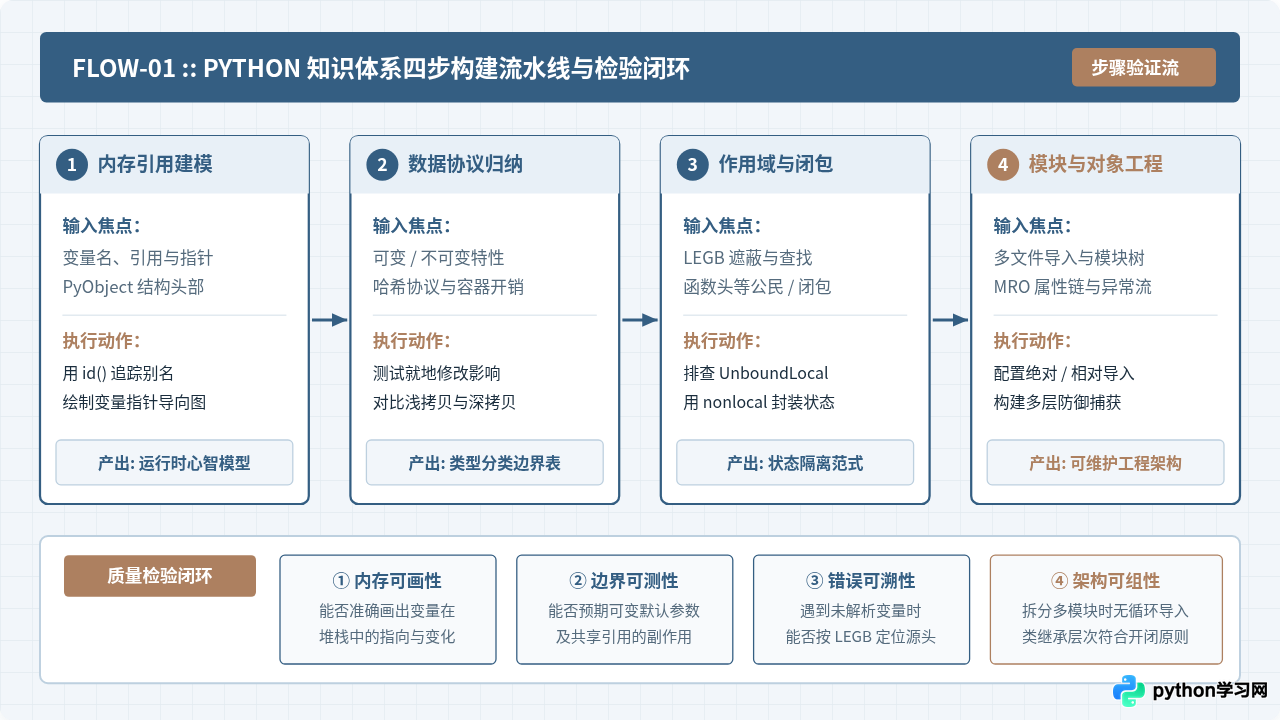
第一步:内存引用建模(建立直观心智模型)
做法:面对任何基础语法,首先在纸上或画板上画出“符号表”与“堆内存对象”两列,标明指针指向与 ob_refcnt 计数。
检验标准:能够正确预判并在终端中使用 id() 验证任意复合赋值后各变量的指向状态。
第二步:数据协议归纳(梳理可变性与时间复杂度)
做法:将所有内置容器按“可变/不可变”、“标量/容器”、“有序/无序”进行横纵切分,针对可变对象进行切片与修改实验。
检验标准:能够一眼识别“默认参数陷阱”(如 def func(x=[]) 的持久化污染),并熟练运用 None 哨兵机制完成防御重构。
# 防御性默认参数写法
def append_item(val, target=None):
    if target is None:
        target = []  # 每次调用时独立开辟新列表对象
    target.append(val)
    return target
第三步:作用域与执行边界控制(打通运行逻辑)
做法:编写三层嵌套函数,分别测试只读访问、局部重新赋值、global 穿透与 nonlocal 闭包修改四种场景。
检验标准:遇到 UnboundLocalError 或变量被意外污染时,能在30秒内准确定位其在编译期的符号标记原因。
第四步:模块与工程抽象(形成架构思维)
做法:将多组函数与数据封装为具备清晰单一职责的类与包,配置 __init__.py 并测试绝对导入与相对导入。
检验标准:项目目录结构清晰,无循环导入(Circular Import)问题,类继承深度不超过3层且 MRO 顺序明晰。
六、体系全景逻辑拓扑与总结
将上述四个层级的概念进行网络化交织,即可得到完整的Python基础知识全景图。各个知识节点并非孤立存在,而是由底层的对象模型与上层的控制逻辑相互贯穿。
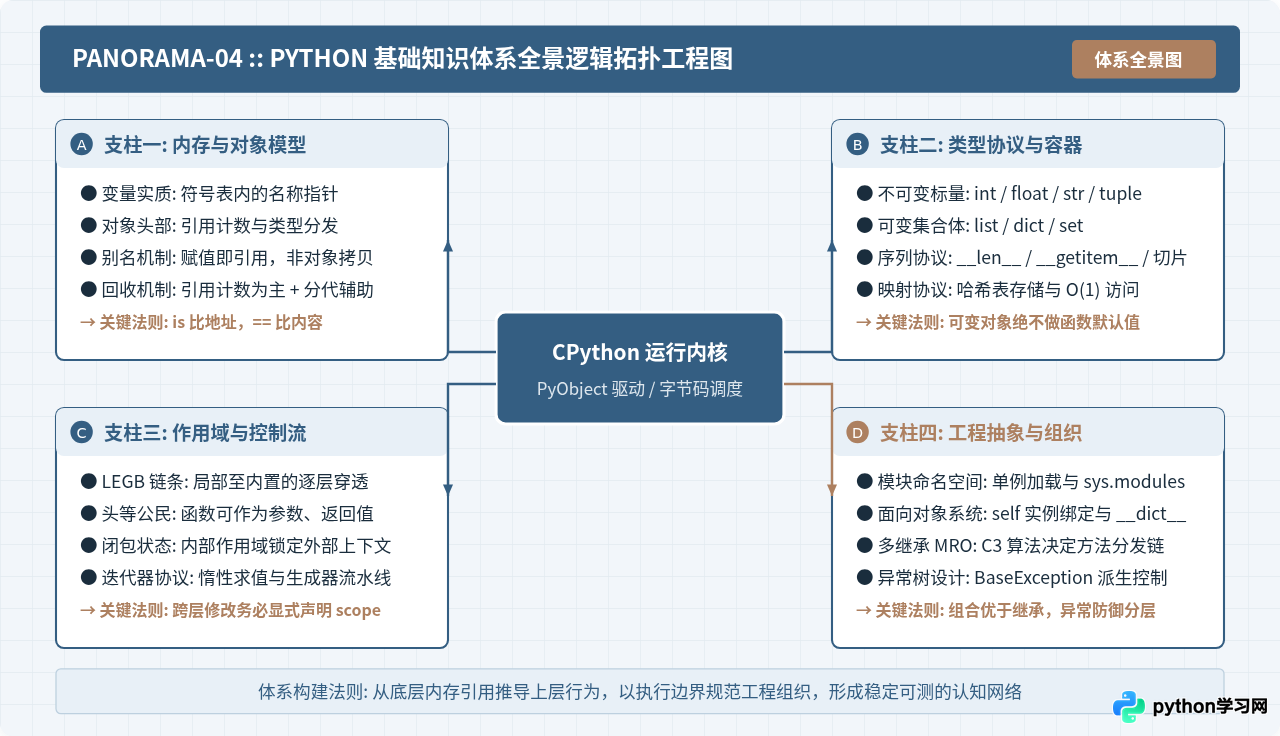
1. 底层驱动一切:在Python中,内存管理与对象模型决定了数据行为。只要记住“变量是引用指针,对象才有实体与类型”,就不会被别名修改所困扰。
2. 协议先于具体类型:Python是鸭子类型(Duck Typing)语言。判断一个对象能做什么,不是看它的名字,而是看它实现了哪些协议(如迭代器协议 __iter__、上下文管理 __enter__/__exit__)。
3. 边界保证可靠:LEGB规则与模块命名空间划定了符号的可见范围,闭包与面向对象提供了两种不同的状态封装手段,异常树构筑了系统的容错屏障。
当读者能够从底层的内存结构推导出上层的运行表现,并在遇到报错时能够从命名空间与引用链条顺藤摸瓜时,就意味着Python的基础知识体系已经在脑海中完整搭建成型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















