


Python魔术方法(__init__)的双下划线命名规范解析
深入解析Python中__init__魔术方法的双下划线命名规范、语言级保留协议、__new__与__init__的协作流程、下划线命名语义差异以及多继承下的super调用原则。
__init__ 这种在名称前后各使用两个连续下划线的写法被称为“双下划线方法”(Dunder Method,即 Double Underscore)。这并非随意约定的代码美化风格,而是 Python 语言底层专为解释器钩子保留的命名空间。本文直接解析双下划线命名的语法规范、设计动因、__init__ 在对象实例化过程中的真实定位,并梳理常见编写误区与边界。
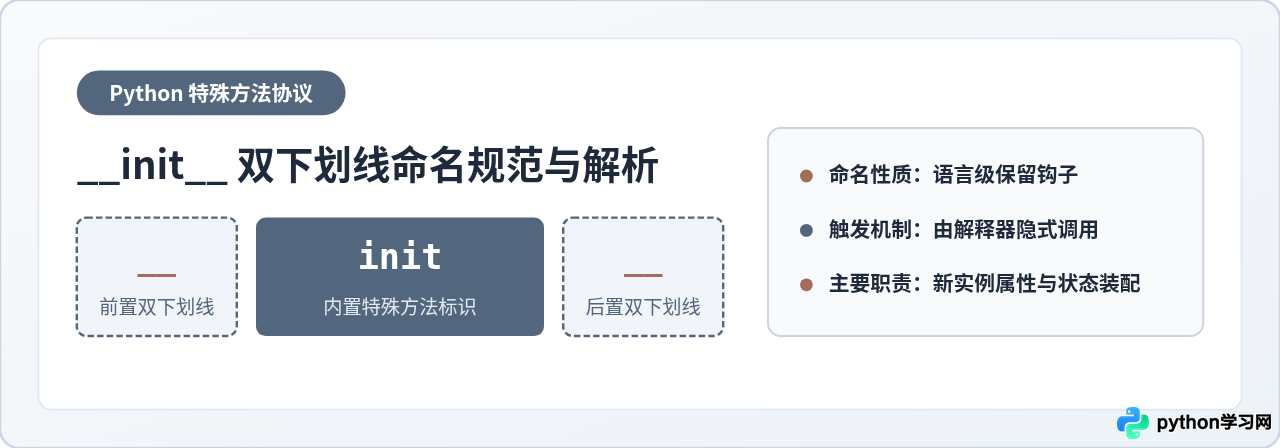
一、为什么是双下划线:Python 命名空间与语言级特殊协议
初学 Python 面向对象时,很多人常对 __init__ 的命名产生疑惑:为什么不直接像 Java、C++ 一样使用类名,或者像 JavaScript 那样使用简洁的 constructor 关键字?
答案在于 Python 的“协议导向”设计思想(Protocol-oriented Design)。在 Python 中,所有由解释器在特定事件下隐式触发的特殊行为(例如对象初始化、运算符重载、属性访问拦截、上下文管理、序列迭代等),全部统一通过名为“魔术方法”(Magic Methods 或 Special Methods)的钩子函数来实现。为了让这类方法能够安全存在于类的普通命名空间中,Python 核心规范专门保留了 __<name>__ 这种首尾各两条下划线的命名格式。
这种设计的核心优势是保持语言语法的高度一致性与命名空间的隔离性:
- 避免与常规业务方法名冲突:开发者在自定义类时,可以自由使用如
init()、start()、close()等直观的方法名,而完全不用担心意外覆盖 Python 解释器的核心机制。 - 语法与实现解耦:调用语法
p = Point()保持了极高的简洁性,而底层由解释器负责寻找并触发__init__,实现了语法糖与底层协议的精准绑定。
__my_func__)。这个命名空间是 Python 官方语言演进的专用领地。如果在自己的业务代码中擅自使用此类命名,一旦未来某一 Python 版本引入同名内建协议,现存代码将面临灾难性的冲突和静默失效。
Python 中四种下划线命名规范的对比与边界
下划线在 Python 中承担着精细的语义分工。很多开发者容易将单下划线、双前导下划线与首尾双下划线混淆,理解它们在解释器层面的真实行为对于编写严谨的代码至关重要:
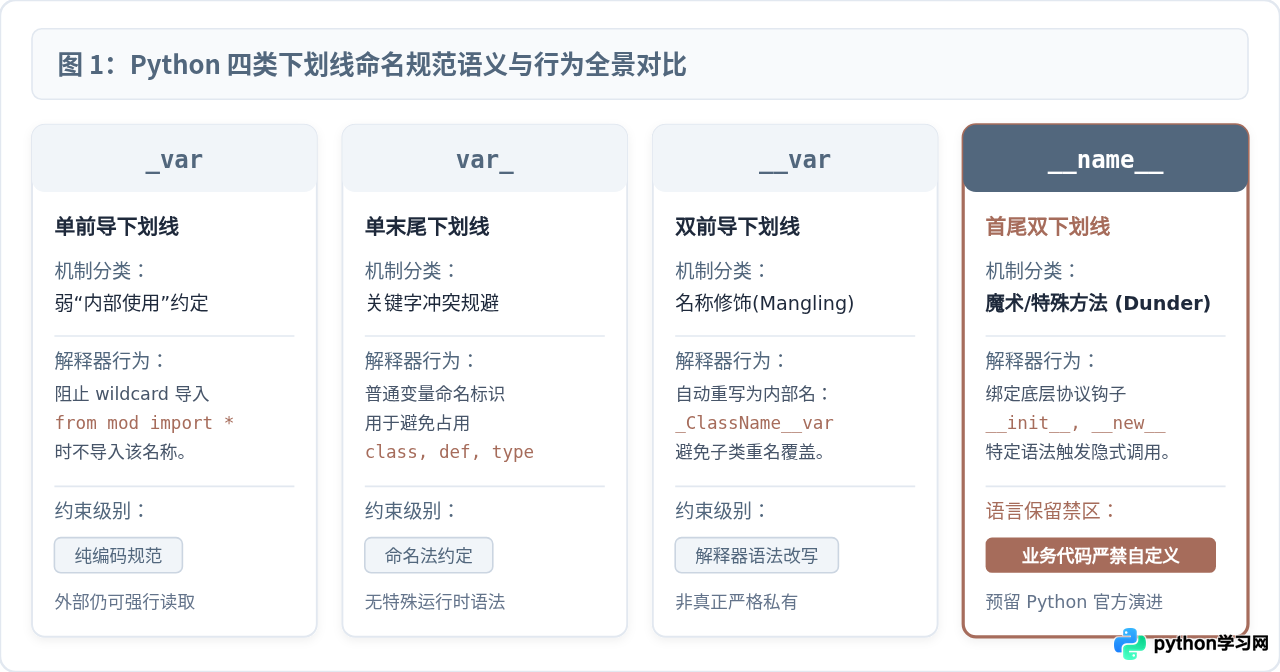
- 单前导下划线(如
_internal_val):仅代表一种弱的“内部使用”编码约定。解释器本身不会对它做任何访问权限限制,外部代码依然可以直接读写它。但它会在使用from module import *时阻止该变量被自动导出。 - 单末尾下划线(如
class_、type_):纯粹的命名避让技巧。当开发者需要使用已被 Python 关键字(如class、def、in)占用的词汇作为变量或参数名时,在末尾追加单下划线以规避语法错误。 - 双前导下划线(如
__private_val):激活解释器的“名称修饰机制”(Name Mangling)。解释器在编译字节码时,会自动将其重写为_类名__private_val。其初衷不是提供类似 Java 级别的访问安全隔离,而是防止在深层类继承体系中子类与父类的同名属性发生无意识的覆盖。 - 首尾双下划线(如
__init__、__str__):专属于 Python 语言内建协议的“魔术方法”。解释器在执行特定操作时会自动检索并调用对应的方法。
二、__init__ 的真实身份:初始化器而非构造器
在许多面向对象教程中,为了向转语言的开发者解释概念,常常将 __init__ 随口称为“构造函数”。这种称呼在严格的技术语境下是不准确的。在 Python 中,真正承担“构造”任务的是 __new__,而 __init__ 是一个“初始化器”。
要理解 __init__ 的运行边界,必须厘清 Python 创建一个对象时的完整推导过程:
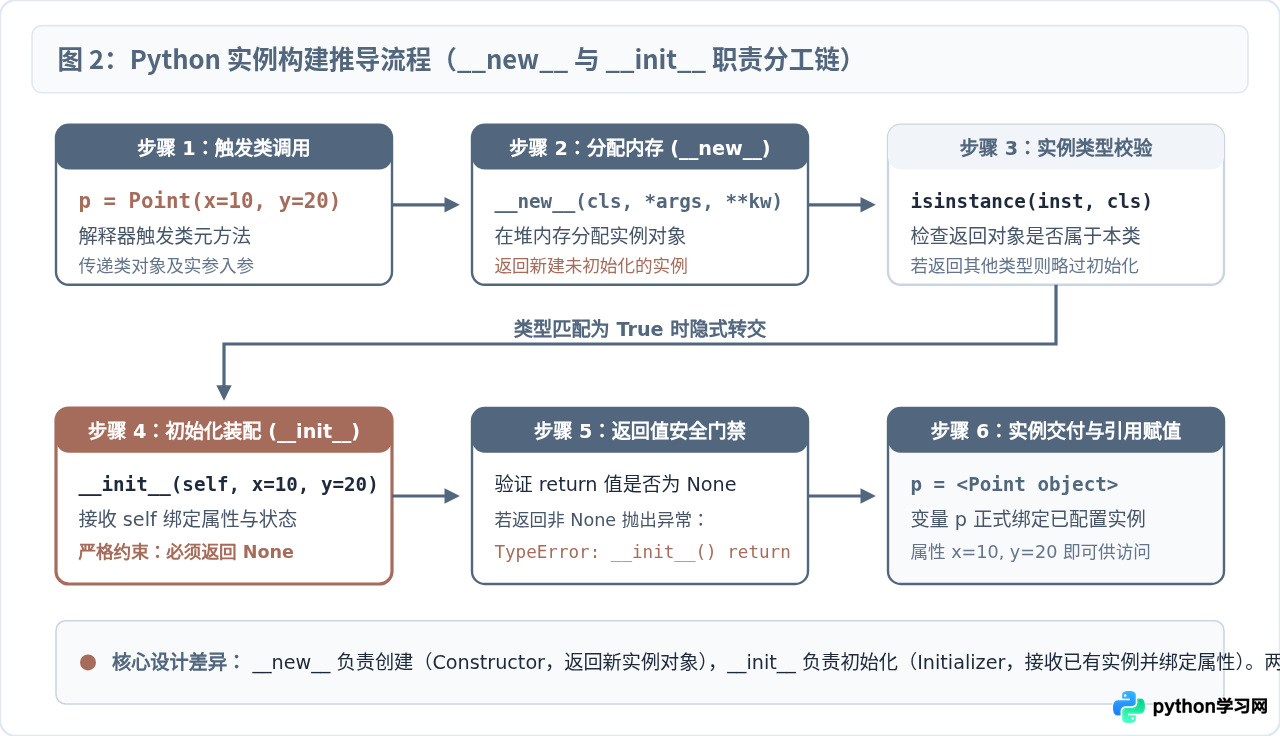
当执行 obj = Point(10, 20) 时,解释器内部经历如下具体步骤:
- 第 1 步:调用元类构造机制,定位到
Point.__new__(Point, 10, 20)。__new__是一个静态方法,它向操作系统/运行时申请内存,创建真正的实例对象并将其返回。 - 第 2 步:解释器检查
__new__返回的对象是否为Point类(或其子类)的实例。如果是,则紧接着将该空实例作为第一个参数(即self),连同传入的实参一起调用Point.__init__(self, 10, 20)。 - 第 3 步:如果在
__new__中返回了一个其他类的对象(例如返回了已缓存的对象或单例),Python 解释器就会直接放弃调用当前类的__init__。
__init__ 必须返回 None 的硬性约束
__init__ 的职责非常明确:接收已存在的 self 实例,并为其挂载属性(Attribute)或设置初始状态。正因其实例已经在外部构造完毕,__init__ 绝不允许返回任何非 None 的对象。
class BadExample:
    def __init__(self, val):
        self.val = val
        return val  # 错误!违背语言规范

# 执行 BadExample(42) 将直接抛出异常:
# TypeError: __init__() should return None, not 'int'
在 __init__ 中,函数执行完毕后应当自然结束(隐式返回 None),或者在需要提前终止初始化流程时写 return 或 return None。任何尝试让 __init__ 返回计算结果或新实例的写法都会触发运行时的 TypeError。
三、继承体系下的 __init__ 协同:super() 与 MRO 原理
在面向对象继承场景中,__init__ 的双下划线特性并不会让它在子类实例化时“自动向上调用”父类。如果派生类定义了自己的 __init__,它就会完全遮蔽(Shadow)父类的同名方法。
因此,编写子类的 __init__ 时,必须显式调用父类初始化逻辑,确保基础属性顺利完成装配:
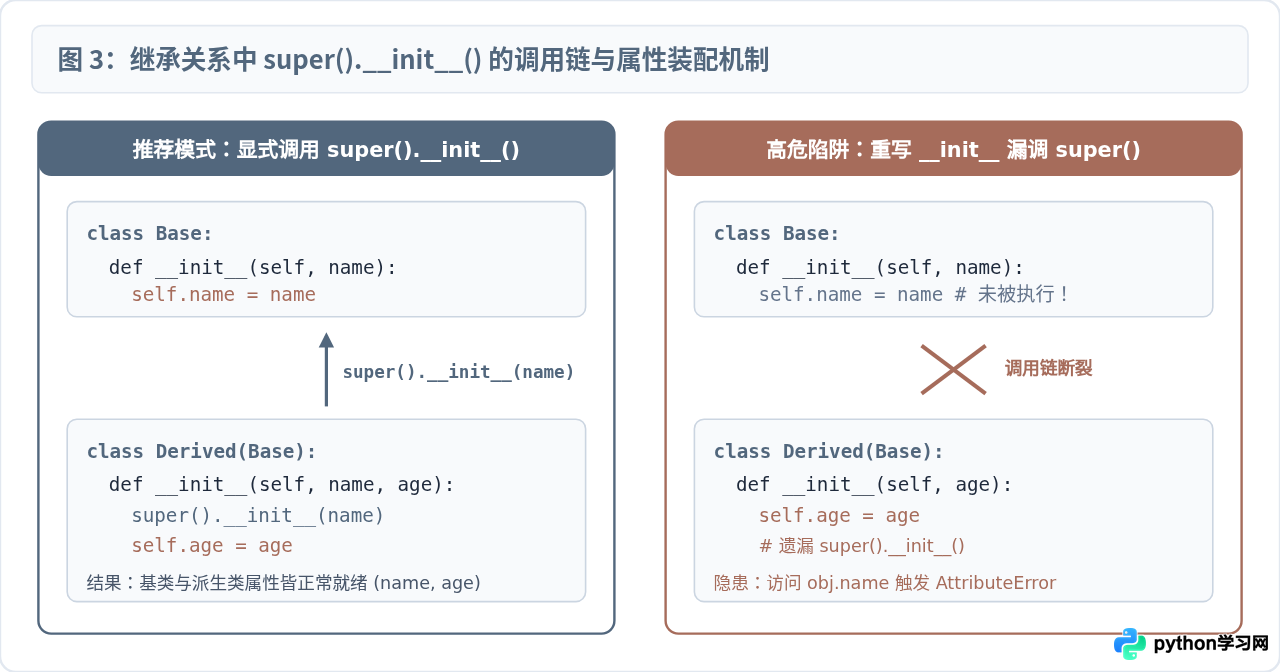
显式调用父类初始化的标准示范
class DatabaseConnection:
    def __init__(self, host: str, port: int):
        self.host = host
        self.port = port
        self.connected = False

class PooledDatabaseConnection(DatabaseConnection):
    def __init__(self, host: str, port: int, pool_size: int = 10):
        # 1. 显式调用父类初始化,完成基类属性装配
        super().__init__(host, port)
        # 2. 装配当前派生类特有的属性
        self.pool_size = pool_size
若遗漏 super().__init__(host, port),则实例中将完全不存在 host、port 和 connected 字段,后续调用任何基类方法时都会由于找不到属性而抛出 AttributeError。
常见编写反模式与排查要点
- 反模式一:在
__init__中进行重型 I/O:__init__的定位是纯粹的内存级状态配置。如果在__init__内部发起耗时的网络请求、连接远程数据库或读取巨型文件,会导致对象创建操作不可控地阻塞,并使单元测试变得极难编写。推荐做法是在__init__中只记录配置参数,将连接操作推迟到connect()方法或使用类工厂方法(Class Factory Method)。 - 反模式二:使用可变对象(如列表、字典)作为参数默认值:如果写成
def __init__(self, tags=[]): self.tags = tags,所有未传参的实例将共享同一个内存列表对象,导致一个实例修改列表直接影响其他所有实例。应改写为def __init__(self, tags=None): self.tags = tags if tags is not None else []。
四、规范总结与实践决策清单
双下划线在 Python 中并不是装饰,而是解释器协议的契约标记。掌握 __init__ 的规范本质,有助于在日常编码中保持架构清晰,规避隐蔽的运行时 Bug。
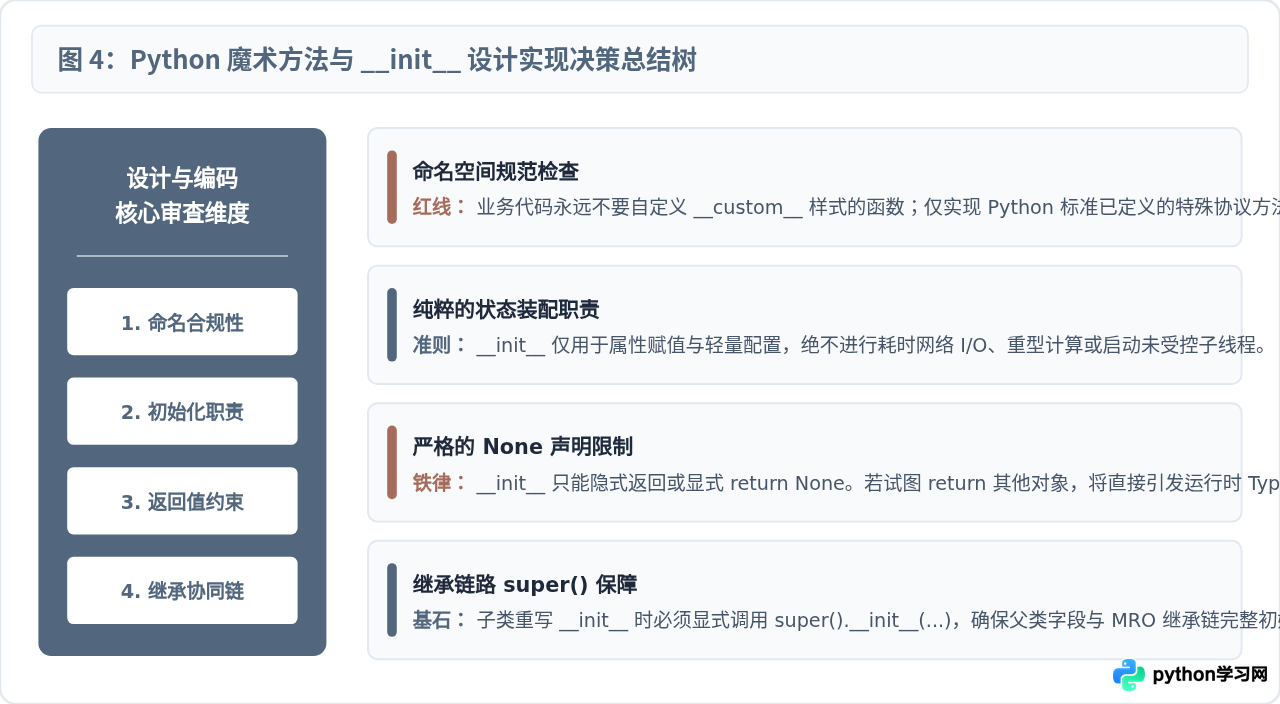
在实际编写 Python 类的初始化逻辑时,建议对照以下四条基准检查:
- 规范严守:除了实现官方规定的标准魔术协议,业务代码永不定义
__custom__样式的方法。 - 职责纯粹:
__init__只负责为self赋予初始属性与安全校验,不负责对象的底层内存分配(由__new__处理),也不承载阻塞性的重型任务。 - 无返回值:确保
__init__始终返回None,提前退出函数使用空的return。 - 继承显式:任何重写了
__init__的子类,均通过super().__init__(...)保证基类属性与 MRO 继承链的健康装配。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















