


Python map函数基础用法:语法结构与迭代器转换
深入讲解Python内置map()函数的核心基础用法,包括语法结构、单序列与多序列映射机制、惰性迭代器生命周期以及如何安全转换为list、tuple等目标容器。
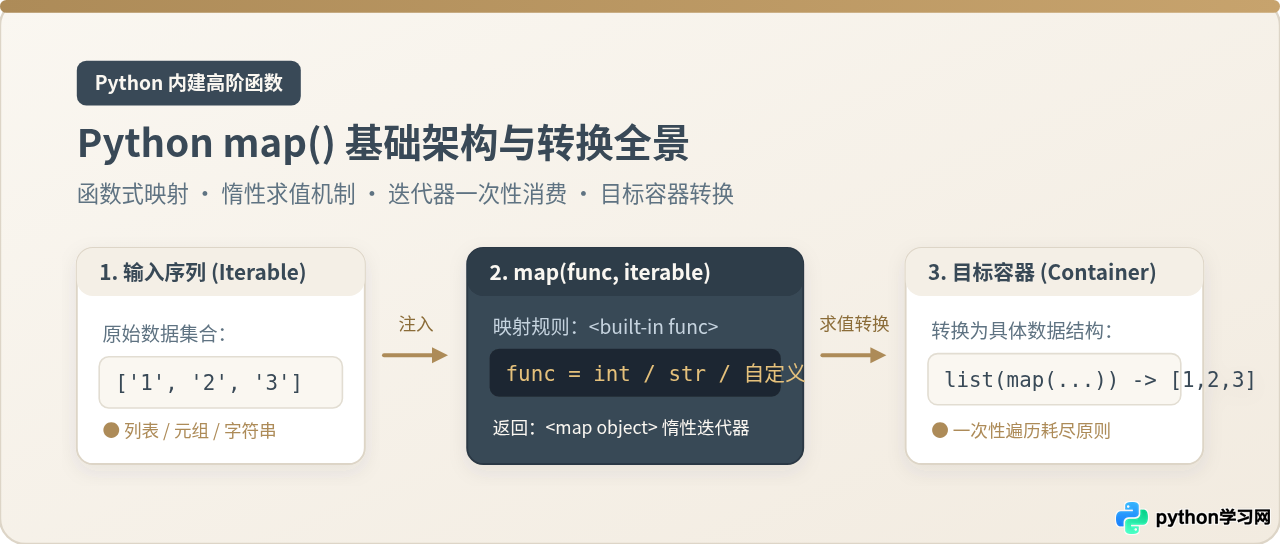
map() 函数用于将指定的处理逻辑批量映射至一个或多个数据序列的每一个元素上。它的核心价值在于以简洁的声明式语法消除低效的显式 for 循环,同时返回一个具备惰性求值(Lazy Evaluation)特性的迭代器对象。本文详细拆解 map() 的语法原型、单序列与多序列映射机制、迭代器底层生命周期,以及转换为列表等具体容器的规范做法。
一、map 函数的基本语法与参数结构
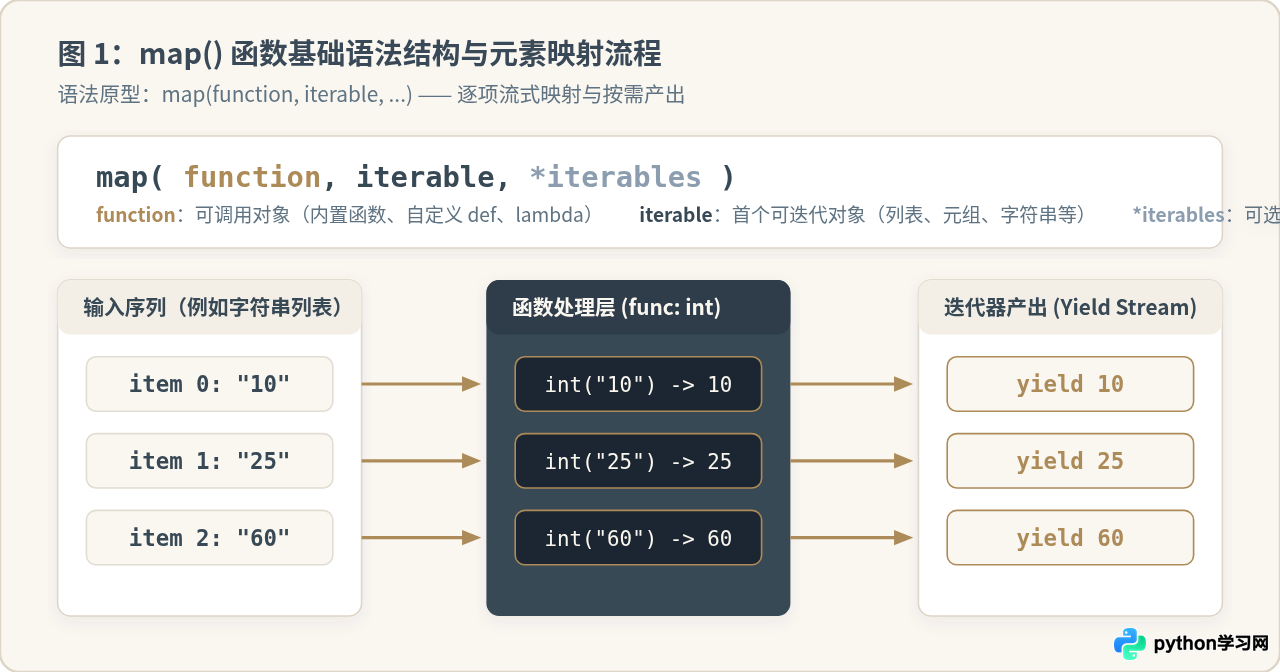
在 Python 中,map() 是内置的高阶函数(Higher-order Function),定义在全局命名空间中,无需导入额外模块即可直接调用。其标准定义形式如下:
map(function, iterable, *iterables)参数由两部分构成:
- function(函数对象):接受参数并执行具体计算的可调用对象(Callable)。可以是 Python 内建函数(如
int、abs、str)、通过def声明的自定义函数,或是简洁的匿名函数(lambda)。 - iterable(可迭代对象):提供输入数据序列,例如列表(
list)、元组(tuple)、集合(set)、字符串(str)或字典的键视图等。 - *iterables(可选的额外可迭代对象):可传入第二个、第三个甚至更多序列。当传入 N 个序列时,第一个参数
function必须同时接收 N 个形参。
1.1 单序列的基础映射示例
最常见的使用场景是把字符串序列统一清洗为数值整数。传统的做法是初始化一个空列表并遍历调用 .append(),而使用 map() 只需一行声明:
# 示例:将字符串数字列表批量转为整型
raw_strings = ["10", "25", "60", "108"]
mapped_result = map(int, raw_strings)

print(type(mapped_result))
print(mapped_result)<map object at 0x103b41d00>
执行上述代码后可以发现,map() 的直接返回值并非包含转换后整数的 [10, 25, 60, 108] 列表,而是一个 <class 'map'> 实例。这就是初学者最容易产生疑惑的地方:映射确实已经建立,但具体计算尚未立即执行。
二、多可迭代对象的映射机制与最短截断原则
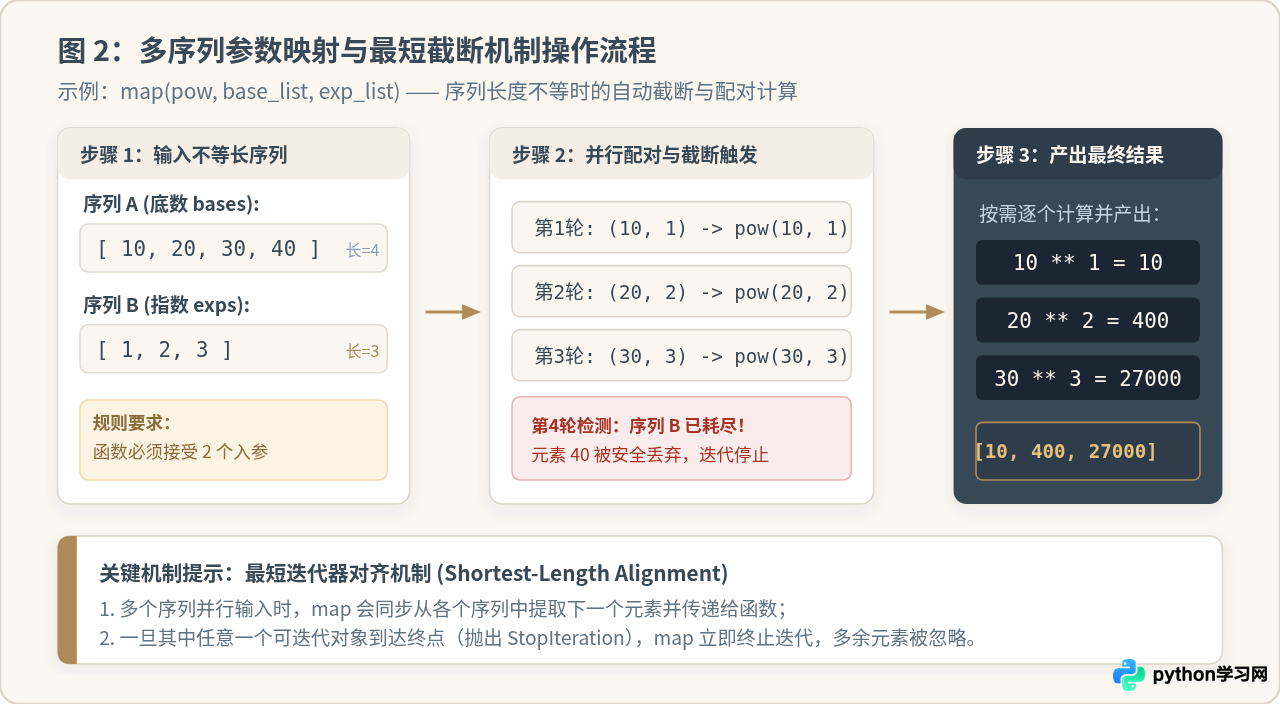
当业务逻辑需要合并或比对多个数据源时,map() 能够接收多个可迭代对象。在执行过程中,map() 会在每一次迭代步进中,分别从每个序列各取出一个元素,打包后以位置参数的形式传递给目标函数。
2.1 多序列对齐计算代码示例
例如计算对应位置数字的乘方运算,内置函数 pow(x, y) 接收两个参数,分别对应底数与指数:
# 示例:双序列传递与幂运算
bases = [10, 20, 30]
exponents = [1, 2, 3]

# pow(10, 1), pow(20, 2), pow(30, 3)
powers = list(map(pow, bases, exponents))
print("计算结果:", powers)2.2 长度不一致时的最短截断规则
如果传入的多个可迭代对象长度不同,Python 3 的 map() 会采取最短截断策略(Shortest-length Termination)。只要其中任意一个序列被遍历完毕,map() 便会立即终止派发,多余元素不会参与运算,也不会引发越界异常。
# 示例:序列长度不对称时的截断表现
bases_long = [10, 20, 30, 40, 50]  # 长度为 5
exponents_short = [1, 2, 3]         # 长度为 3

truncated_powers = list(map(pow, bases_long, exponents_short))
print("截断后的计算结果:", truncated_powers)map() 传入 None 作为函数名,它会起到类似于 zip() 的打包填充效果,且对于长度不足的序列会填充 None。但在 Python 3 中,此行为已被彻底移除,map() 函数参数不可省略,且行为严格以最短序列为边界终止。
三、迭代器机制与惰性求值特性
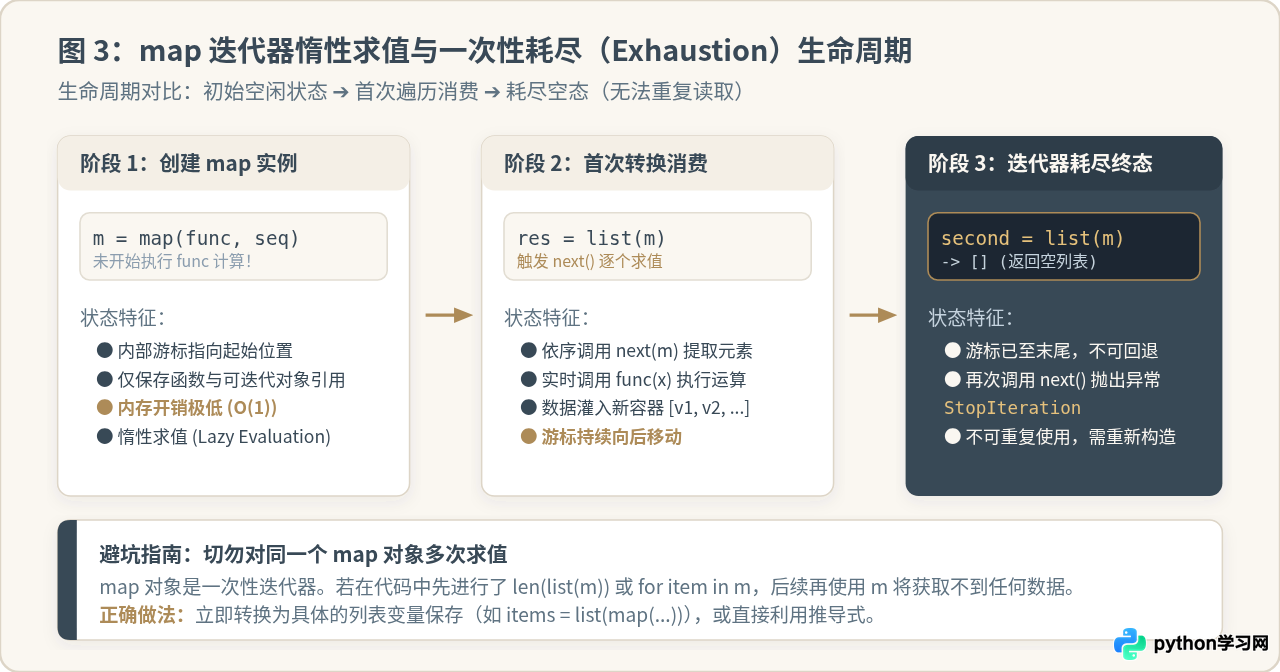
要正确使用 map(),必须理解为什么 Python 3 将其返回值从 Python 2 的即时列表(List)改为了迭代器(Iterator)。这背后的核心设计理念是惰性求值(Lazy Evaluation)。
3.1 惰性计算的内存与性能优势
当执行 m = map(func, large_sequence) 时,Python 解释器仅分配了一个极小的轻量级迭代器控制块。此时,即使 large_sequence 包含数以千万计的元素,系统内存也不会发生显著增长。
只有当程序通过 for 循环、next() 函数或容器转换指令显式“索取”下一个数据时,map() 才会触发一次 func 的计算并产出结果。对于大型日志分析、文件流逐行解析等大规模数据处理场景,这种机制有效避免了在内存中产生庞大的中间列表副本。
# 验证惰性求值:定义带打印副作用的函数
def square_with_log(x):
    print(f"-> 正在计算 {{x}} 的平方")
    return x * x

numbers = [1, 2, 3]

# 创建 map 对象
mapper = map(square_with_log, numbers)
print("1. map 对象已建立,但下方未产生任何函数内部输出:")

# 首次提取一个值
first_val = next(mapper)
print(f"2. 手动提取第一个值: {first_val}")-> 正在计算 1 的平方
2. 手动提取第一个值: 1
3.2 迭代器单次消费与耗尽现象
迭代器协议的核心原则之一是单向步进且不可重置。迭代器内部维护着当前读取指针,一旦指针到达序列末尾,后续再次尝试从中读取数据只会立即收到 StopIteration,返回空集合。
# 示例:迭代器耗尽陷阱
data = [10, 20, 30]
m = map(lambda x: x * 2, data)

first_pass = list(m)
print("第 1 次转为列表:", first_pass)

second_pass = list(m)
print("第 2 次转为列表:", second_pass)第 2 次转为列表: []
在很多初学者的实际代码中,常常出现先使用 len(list(m)) 检查长度,紧接着在下文 for item in m: 遍历逻辑的情况。此时循环体内部将完全不会执行,因为在调用 len(list(m)) 的瞬间,迭代器就已经被彻底耗尽。
四、map 对象的类型转换与实战场景
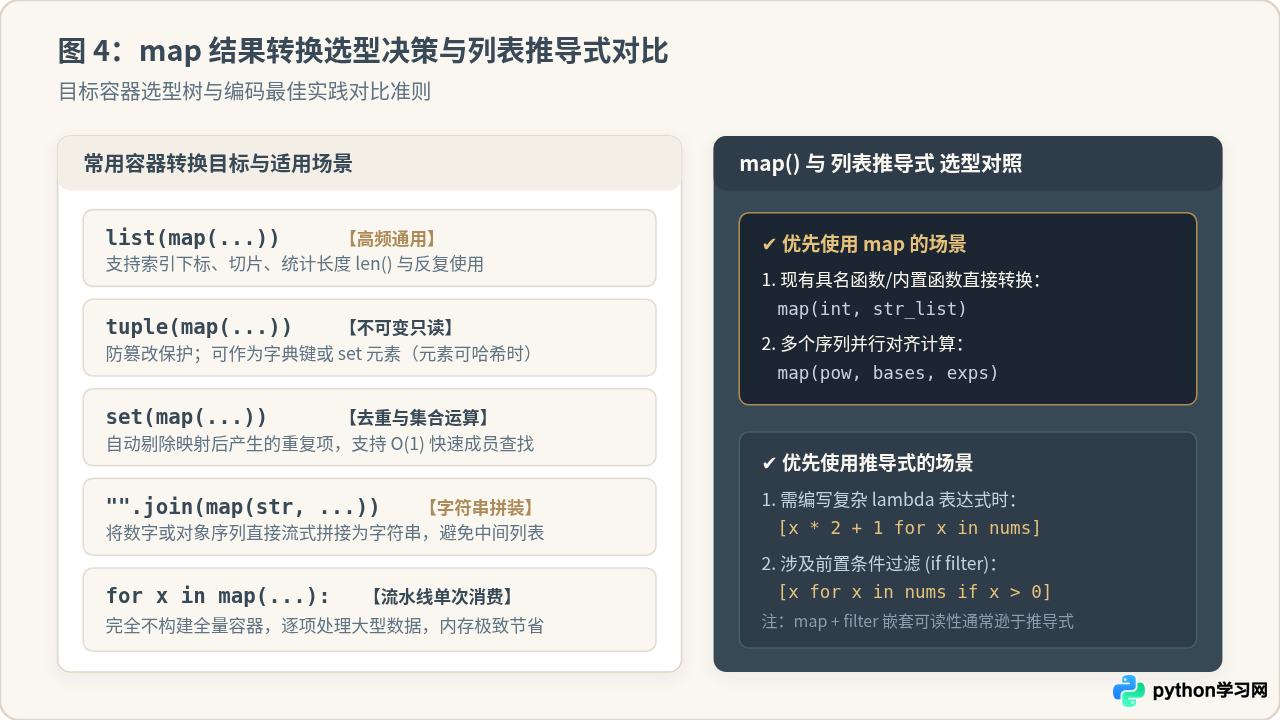
为了能够重复访问数据、执行切片索引或利用特定容器的功能,我们需要将 map 迭代器转换为具体的 Python 内置容器类型。
4.1 转换为列表(list)与元组(tuple)
转换为列表是最高频的模式。转换时会一次性驱动迭代器遍历完毕,并将所有求值结果写入连续内存块:
# 转换为 list 与 tuple
str_numbers = ("3.14", "2.718", "1.414")

float_list = list(map(float, str_numbers))
float_tuple = tuple(map(float, str_numbers))

print("List 结果:", float_list)
print("Tuple 结果:", float_tuple)Tuple 结果: (3.14, 2.718, 1.414)
4.2 转换为集合(set)实现自动去重
当经过映射处理后的数据可能存在重复值,且业务只关心非重复项时,直接将 map 传入 set() 构造器既高效又优雅:
# 示例:提取单词首字母并自动去重
words = ["Apple", "banana", "apricot", "Cherry", "blueberry"]
unique_initials = set(map(lambda w: w[0].upper(), words))

print("唯一大写首字母集合:", sorted(unique_initials))4.3 字符串高效流式拼接(str.join)
在需要将一系列非字符串元素(如数字、枚举、对象属性)合并为一个完整文本字符串时,通常不需要先分配一个中间的临时字符串列表,而是可以直接将 map(str, ...) 送入 str.join():
# 示例:格式化拼接 ID 序列为 CSV 格式
record_ids = [101, 204, 308, 412]
csv_row = ",".join(map(str, record_ids))

print("生成的 CSV 字符串:", csv_row)五、选型对比:map() 与 列表推导式(List Comprehension)
在日常 Python 开发中,map() 与列表推导式往往能够实现相同的数据变换任务。如何做出合适的技术选型取决于具体代码的可读性与函数性质。
| 特性维度 | map() 函数 | 列表推导式 [f(x) for x in seq] |
|---|---|---|
| 返回值类型 | 惰性迭代器(Iterator),按需计算 | 立即求值的全量列表(List) |
| 调用已有命名函数 | 语法最简洁高效,如 map(int, s) |
略微冗余,需书写 [int(x) for x in s] |
| 多序列并行映射 | 原生多参数对齐支持,语法优雅 | 需要配合 zip(),如 [f(a, b) for a, b in zip(A, B)] |
| 包含复杂内联表达式 | 需要使用 lambda,表达式复杂时可读性显著下降 |
可读性极佳,直观表达数学逻辑与运算符 |
| 条件筛选支持 | 需嵌套 filter(),书写较为晦涩 |
原生内置 if 过滤子句,清晰易懂 |
str、int、abs)或已定义的常规函数时,使用 map() 能够减少样板变量的命名,表达意图清晰;当映射逻辑需要编写多层嵌套计算、内联运算或附加 if 过滤条件时,建议优先采用列表推导式或生成器表达式。
六、常见错误排查与编码注意事项
在实际编写涉及 map() 的代码时,需特别关注以下两项易发错误:
6.1 参数数量不匹配抛出 TypeError
当向 map() 传入了多个序列,但目标函数所声明的形参个数少于(或多于)传入的序列数量时,Python 会在首次尝试提取元素并调用函数时抛出 TypeError。
# 错误示例:传入 2 个序列,但函数仅接受 1 个参数
list_a = [1, 2, 3]
list_b = [4, 5, 6]

try:
    # abs 函数仅接收 1 个参数,传入两序列会引发调用异常
    res = list(map(abs, list_a, list_b))
except TypeError as err:
print("捕获类型错误:", err)6.2 忽视惰性执行导致副作用延迟或不执行
如果一个函数具有打印输出、写入数据库或修改全局状态等“副作用”(Side Effect),仅仅调用 map(func, data) 并不会真正执行这些副作用。若没有后续的显式迭代消费,内部代码将永远不会被触发。
因此,不要使用 map() 替代纯粹的遍历循环。对于仅执行副作用而不需要收集返回值的场景,应直接使用常规的 for item in iterable: 语句。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















