


哪里可以下载Python菜鸟教程100例的PDF或源码?
详细介绍获取Python菜鸟教程100例源码与离线PDF文档的正规渠道、克隆下载命令、网页转PDF方法及验证运行步骤。
1. 源码与文档的核心获取途径分析
菜鸟教程(RUNOOB)网站上的“Python 100例”以经典算法、数学逻辑、字符串与字典处理等微型实例为主。很多读者希望离线练习或一次性导入编辑器调试,因此需要整套源码文件或方便翻阅的PDF电子书。
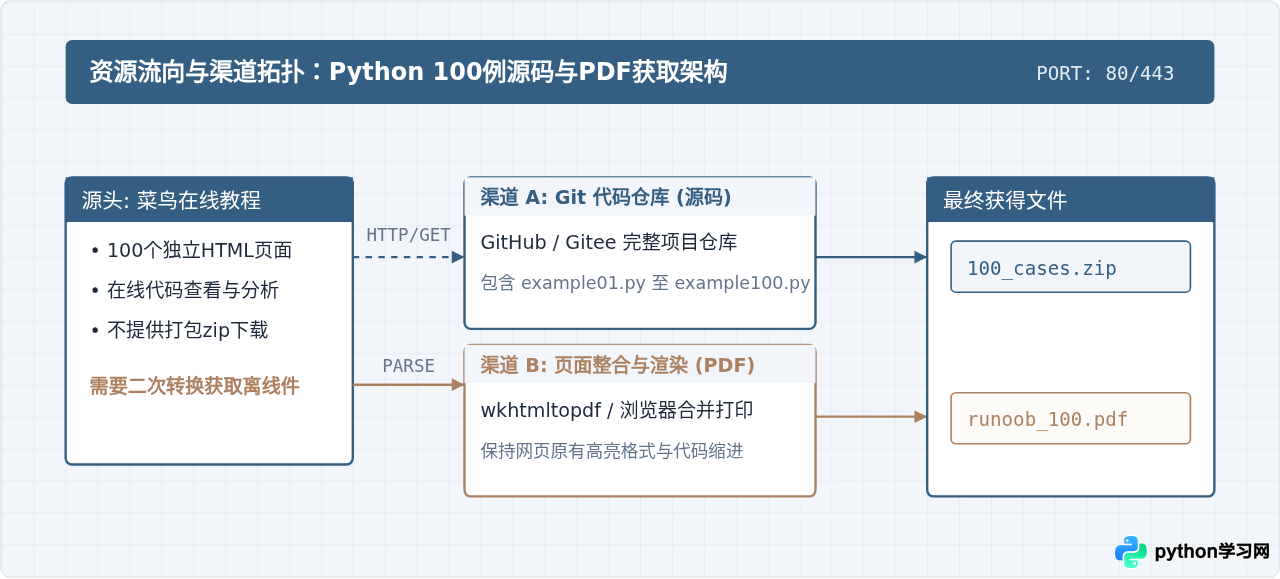
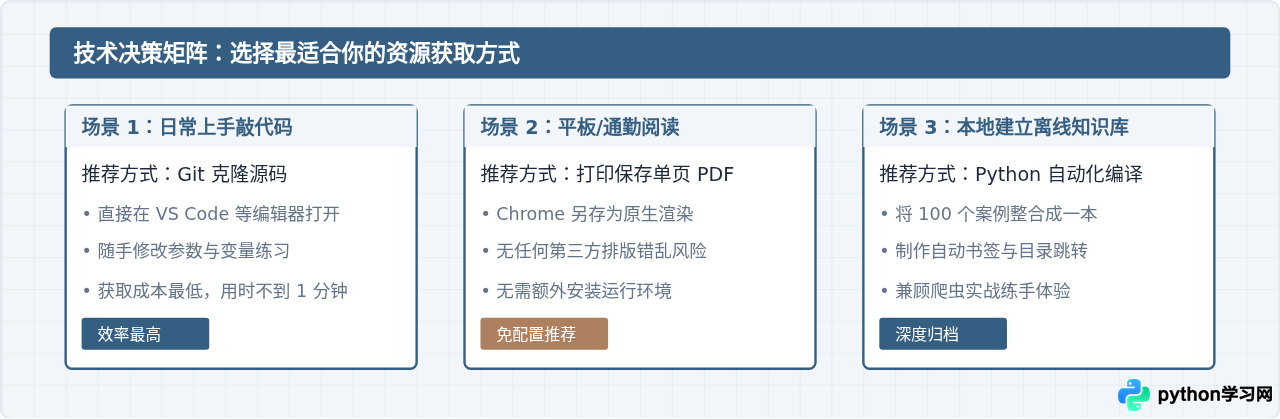
目前获取这些资料主要有三个可靠渠道:公共代码托管平台(GitHub/Gitee)、浏览器本地无损渲染PDF,以及使用Python编写自动化抓取与转换脚本。不同途径在获取难度与最终效果上各有侧重。
2. 如何在 GitHub / Gitee 直接下载全部源码
由于菜鸟教程早期将该100例完全公开,技术社区中有大量开发者将这100个题目、解题思路和源码完整整理并开源。你可以直接使用 Git 命令行工具拉取完整工程,也可以直接在网页端打包下载 ZIP 压缩包。
操作步骤:使用 Git 快速拉取仓库
国内网络环境下,访问 Gitee(码云)的速度通常优于 GitHub。以下以 Gitee 上的开源备份仓库为例:
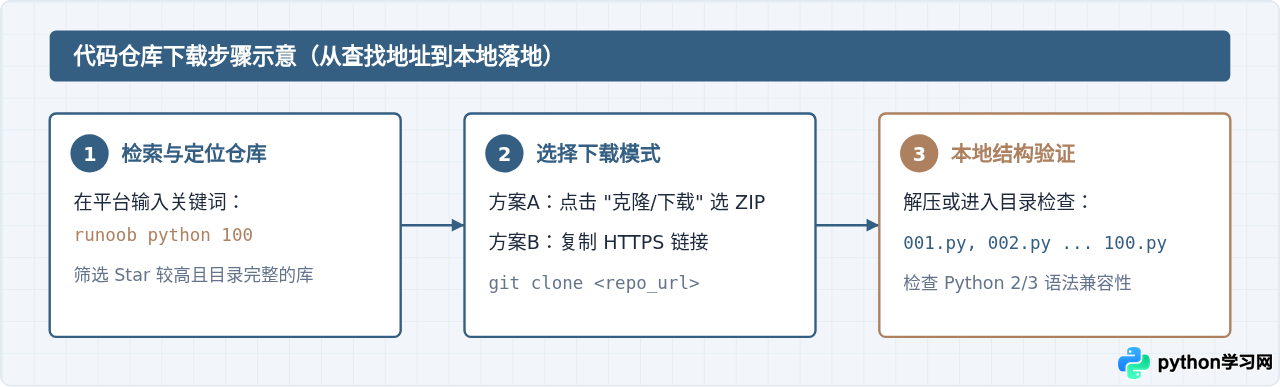
打开终端(Terminal 或 PowerShell),执行以下克隆命令之一:
# 方案一:通过 Gitee 获取常见归档版本(推荐国内网络使用)
git clone https://gitee.com/mirrors/python-100-days.git
# 或者直接检索社区用户同步的菜鸟100例特定仓库
git clone https://gitee.com/open-source-cases/runoob-python100.git

# 方案二:通过 GitHub 获取社区长期维护版本
git clone https://github.com/jackfrued/Python-100-Days.gitprint "Hello" 而非括号语法)。下载开源仓库后,请先观察代码中的 print 语句与 input()/raw_input() 函数。若为 Python 2 语法,可在本地运行自带工具 2to3 -w . 一键将当前目录下所有源码迁移至 Python 3 标准。
3. 制作或获取全套 100 例 PDF 文件的实用方法
部分网络文档分享站点(如文库类平台)常常提供由网友上传的“Python菜鸟教程100例.pdf”,但往往伴随水印严重、排版错乱甚至付费积分限制。自行制作或通过自动化抓取生成,不仅内容完全受控,排版也是最新的。
方法一:浏览器组合打印为 PDF(适合免安装任何额外工具)
- 使用 Chrome 或 Edge 浏览器打开菜鸟教程“Python 练习实例100题”的主目录页面。
- 按快捷键
Ctrl + P(macOS 用户按Command + P)调出打印窗口。 - 在“目标打印机”下拉菜单中选择“另存为 PDF”。
- 在“更多设置”中勾选“背景图形”,这样代码块的高亮背景色与边框样式能够完整保留。
- 点击“保存”,即可得到索引页文档。各例题详情页也可按相同方式按需保存。
方法二:使用 Python + pdfkit 脚本批量合并抓取
如果希望把 100 个实例页面合并成一整本带完整目录的 PDF,可以使用 Python 自行编写一段轻量级脚本,通过 requests 抓取页面,并调用 pdfkit(依赖 wkhtmltopdf 渲染引擎)完成合并。
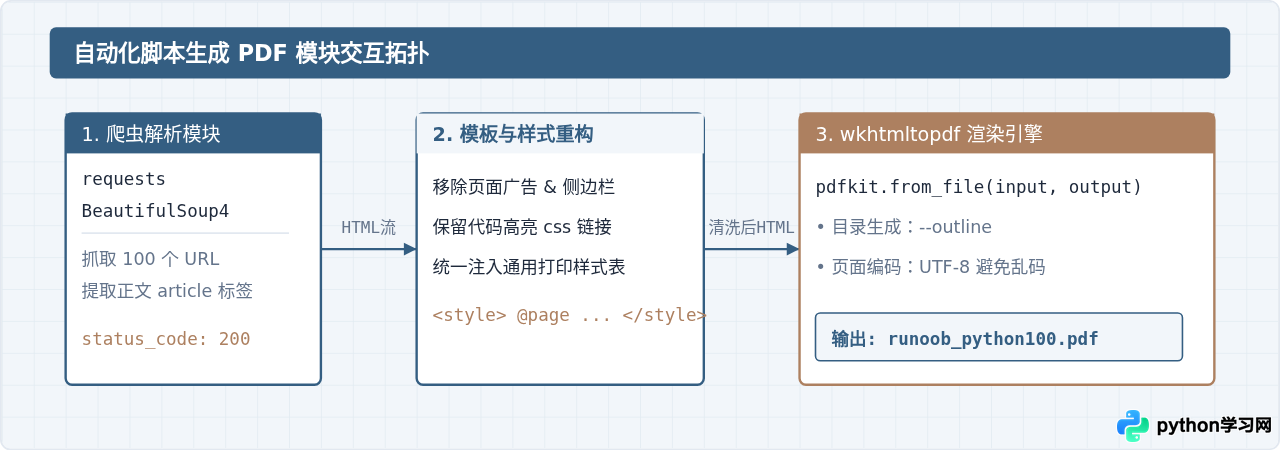
关键实现脚本示例如下(执行前需本地安装 wkhtmltopdf 并执行 pip install requests beautifulsoup4 pdfkit):
import pdfkit
import requests
from bs4 import BeautifulSoup

# 示例:抓取实例1的内容并转为独立页面片段
url = "https://www.runoob.com/python/python-exercise-example1.html"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

response = requests.get(url, headers=headers)
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'html.parser')

# 提取正文主体部分,剥离无关的页头页脚
content = soup.find('div', class_='article-intro')
html_template = f"""
<!DOCTYPE html>
<html>
<head><meta charset="UTF-8"><style>pre{{background:#f8f9fa;padding:10px;}}</style></head>
<body>{str(content)}</body>
</html>
"""

with open("example01.html", "w", encoding="utf-8") as f:
    f.write(html_template)

# 将 HTML 文件转换为 PDF
pdfkit.from_file("example01.html", "example01.pdf")
print("转换完成:example01.pdf")
4. 源码本地运行验证与常见问题排除
成功下载或提取出 .py 源码后,不要盲目逐个双击运行。建议在标准工程环境下进行组织与检验。
| 异常现象 | 根本原因 | 排查与修复方法 |
|---|---|---|
SyntaxError: Missing parentheses in call to 'print' |
源码为旧版 Python 2 编写,当前运行环境为 Python 3 | 将 print x 改为 print(x),或执行 2to3 -w 目标文件.py 自动转换 |
NameError: name 'raw_input' is not defined |
Python 3 中移除了 raw_input,统一改用 input |
全局替换代码中的 raw_input( 为 input( |
| 导出的 PDF 中文显示为方块或乱码 | 系统缺少中文字体,或 HTML 头部未声明 charset="UTF-8" |
HTML 中显式加入 UTF-8 meta 标签,并确保系统安装了文泉驿或微软雅黑字体 |
5. 总结
想要获取“Python菜鸟教程100例”的资料:
- 需要完整源码:首选 Gitee 或 GitHub 搜索
runoob python 100并通过git clone获取,省去逐题复制粘贴的麻烦。 - 需要离线 PDF:利用现代浏览器的“另存为 PDF”打印功能或使用
wkhtmltopdf工具链进行本地抓取合并,能获得排版干净且无广告的离线教程。
这样既能避免在非正规网盘站点下载到夹带垃圾软件的文件,也能确保代码结构的整洁与可读性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















