


Python怎么控制随机小数的位数和精度
深入解析在Python中控制随机小数位数和精度的实用方法,涵盖round截断、格式化输出、整数缩放与Decimal高精度方案,剖析二进制浮点误差与银行家舍入机制。
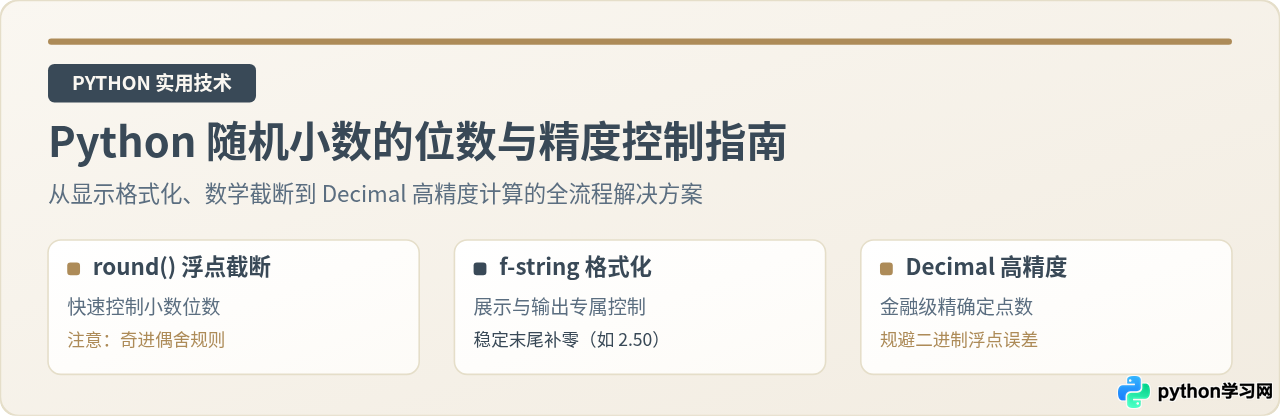
f"{val:.2f}")是最直观且不会丢失末尾零的方案;若需作为浮点数参与常规计算,可使用 round() 或“整数缩放除法”;而面对金额结算、科学计量等对累积误差敏感的场景,则应当使用标准库 decimal.Decimal 进行定点量化。
一、基础现象:随机浮点数的默认生成机制
Python 内置的 random 模块提供了生成随机浮点数的基础函数,例如 random.random() 用于生成 [0.0, 1.0) 范围内的双精度浮点数,以及 random.uniform(a, b) 用于生成指定区间 [a, b] 内的均匀分布浮点数。
直接调用这些函数时,Python 默认会生成符合 IEEE 754 双精度标准的 64 位浮点数,其小数部分通常包含 15 到 17 位有效数字。例如:
import random

# 生成 [10.0, 50.0] 范围内的默认随机浮点数
raw_val = random.uniform(10.0, 50.0)
print(f"原始生成值: {raw_val}")
print(f"数据类型: {type(raw_val)}")
示例输出:
原始生成值: 37.84920412891465
数据类型: <class 'float'>
在绝大多数实际业务中,这种高精细度的小数并不适合直接输出。例如模拟商品折扣通常只需保留 2 位小数,传感器读数通常保留 1 位小数。如果不加控制直接使用,不仅界面排版杂乱,更可能在后续对比或序列化时引发隐蔽问题。
二、四种控制随机小数位数和精度的具体方案
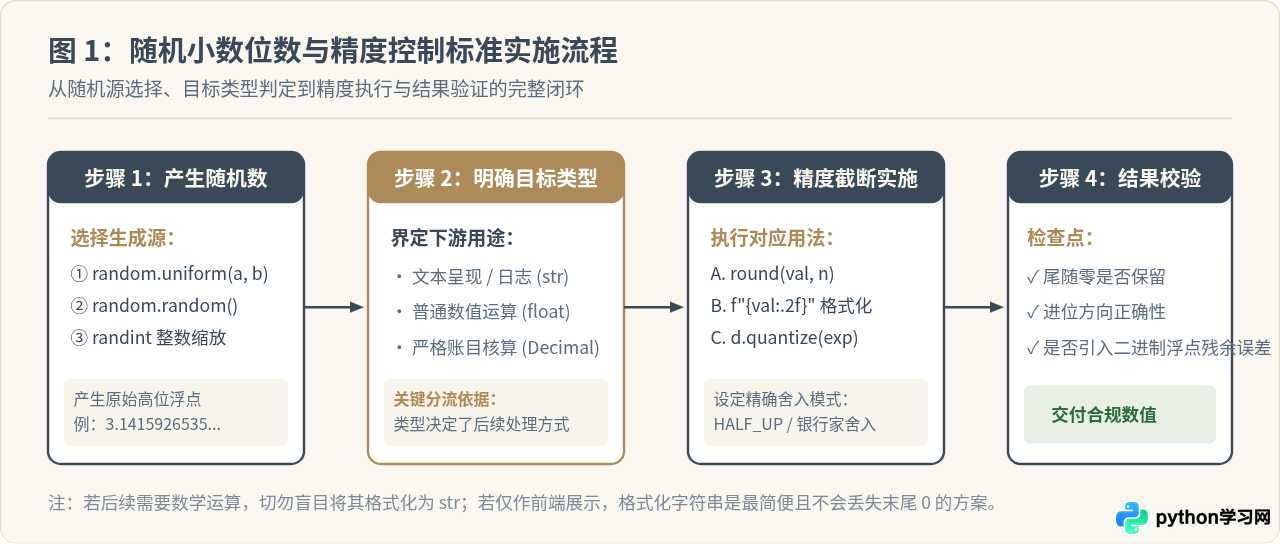
1. 使用 round() 函数控制浮点位数
round(val, n) 是 Python 最直观的截断工具,它将浮点数截断到指定的小数位数 n,并返回一个标准的 float 类型对象。该方法适合需要保留小数位数同时继续作为数字参与运算的日常场景。
import random

# 生成并保留两位小数
price = round(random.uniform(10.0, 50.0), 2)
print(f"保留两位小数: {price}, 类型: {type(price)}")
示例输出:
保留两位小数: 37.85, 类型: <class 'float'>round() 无法强制保留末尾的无效零。例如当截断结果恰好是 2.50 时,作为 float 存储的数值会自动简化显示为 2.5。如果要求严格保持固定宽度显示,必须配合格式化输出。
2. 格式化字符串:锁定输出展示位数
当随机小数的主要目标是用于界面输出、报表排版、日志打印或持久化存储为文本时,使用 Python 3.6+ 的 f-string 格式化表达式是最稳妥的做法。格式化规范 :.Nf 不仅会进行舍入处理,还会自动补足末尾的零。
import random

num = random.uniform(5.0, 6.0)

# 格式化保留两位小数,强制对齐补零
formatted_str = f"{num:.2f}"
print(f"格式化输出文本: {formatted_str}, 类型: {type(formatted_str)}")
示例输出:
格式化输出文本: 5.40, 类型: <class 'str'>
需要明确的是,该方法得到的结果是 str 字符串。如果后续需要进行加减乘除计算,不应过早将其转为字符串,而应在数据呈现的最末端环节执行格式化。
3. 整数随机除法:步长无损的离散模拟法
在许多业务模拟中,随机小数本质上是具有固定步长的离散点。例如生成 0.01 到 9.99 之间的金额,实际上等价于在 1 到 999 之间随机选取一个整数分,再除以 100。
import random

# 生成 1.00 到 10.00 之间步长为 0.01 的随机小数
# 先生成 [100, 1000] 的整数,再缩放 100 倍
val = random.randint(100, 1000) / 100
print(f"整数缩放生成: {val}")
这种方法的优势在于规避了连续浮点截断带来的随机分布偏差,生成的离散点在数学步长上完全均等,非常适合游戏掉落率计算、金额模拟和离散阶梯抽样。
4. decimal 模块:金融级高精度定点控制
当业务对精度有严苛要求(如利息计算、账目对账),必须杜绝二进制浮点数本身的舍入误差时,应当使用 Python 标准库中的 decimal 模块。通过 Decimal.quantize() 可以精确设定保留的位数和舍入模式(例如经典的“四舍五入” ROUND_HALF_UP)。
from decimal import Decimal, ROUND_HALF_UP
import random

# 生成随机浮点数并转为 Decimal(使用 str 构建避免引入二进制微差)
raw_float = random.uniform(10.0, 100.0)
d = Decimal(str(raw_float))

# 精确量化到两位小数,并指定标准四舍五入模式
precise_val = d.quantize(Decimal('0.01'), rounding=ROUND_HALF_UP)
print(f"Decimal 高精度结果: {precise_val}, 类型: {type(precise_val)}")
示例输出:
Decimal 高精度结果: 64.72, 类型: <class 'decimal.Decimal'>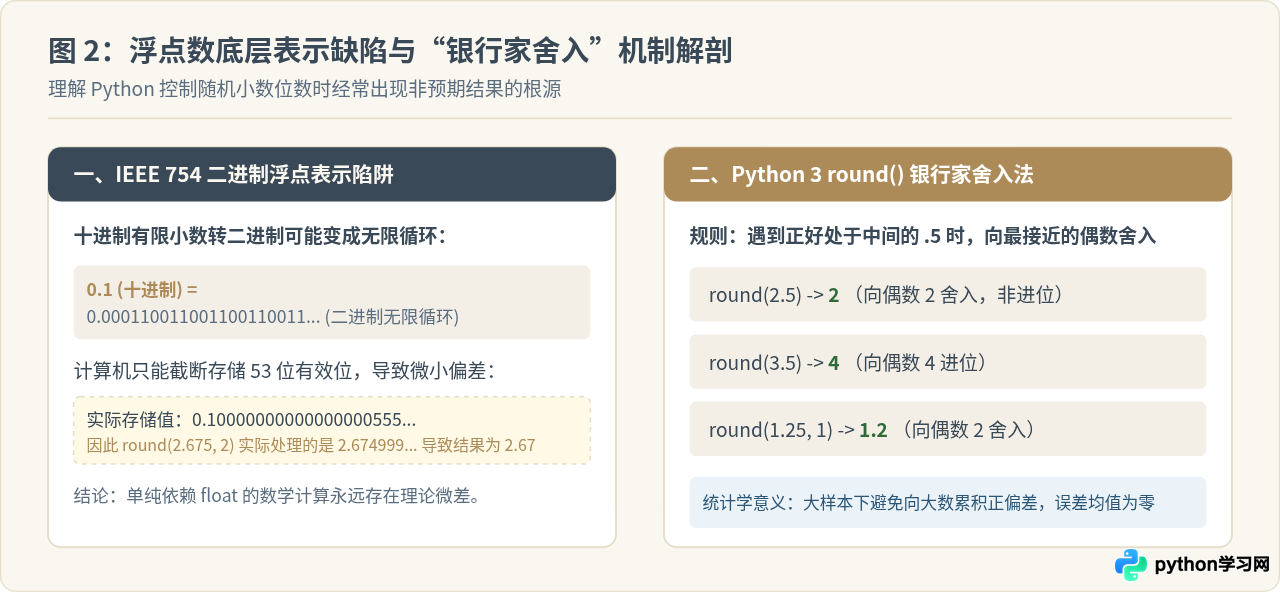
三、原理解析:为什么 round() 有时会“出人意料”?
在初学 Python 时,很多开发者会对 round() 的结果产生困惑。例如执行 round(2.5) 得到 2,而 round(3.5) 却得到 4。理解这一现象背后的机制,是精确控制随机数精度的关键。
1. IEEE 754 二进制浮点表示的固有局限
计算机内部使用二进制表示数字。十进制中的简单有限小数(如 0.1 或 0.2)在二进制下是无限循环小数:
0.1 (十进制) = 0.00011001100110011... (二进制)
计算机的双精度浮点数只能存储有限的 53 位有效位,因此存储的值只是极度接近 0.1 的近似值(约为 0.10000000000000000555...)。这导致在执行浮点截断时,看似恰好处于中点的数字(如 2.675)在底层实际存储可能是 2.6749999999999998...,从而导致 round(2.675, 2) 舍入后为 2.67 而非直觉上的 2.68。
2. 银行家舍入(Round half to even)
Python 3 中的内置 round() 函数采用的是银行家舍入法(也称奇进偶舍):当被舍入的数字恰好处于两个可能结果的正中间时(例如 .5),它总是向最接近的偶数舍入。
round(2.5)中,2 和 3 之间,2 是偶数,因此结果为 2;round(3.5)中,3 和 4 之间,4 是偶数,因此结果为 4;round(1.25, 1)中,1.2 和 1.3 之间,1.2 的末尾 2 是偶数,因此结果为 1.2。
该算法并非缺陷,而是国际通行的数值统计标准。在大量随机数据的统计分析中,传统“逢五必进”的四舍五入会导致整个数据集的总和系统性向上偏倚;而银行家舍入使得中间值向上和向下的概率各占 50%,在统计学上能够保持均值无偏。
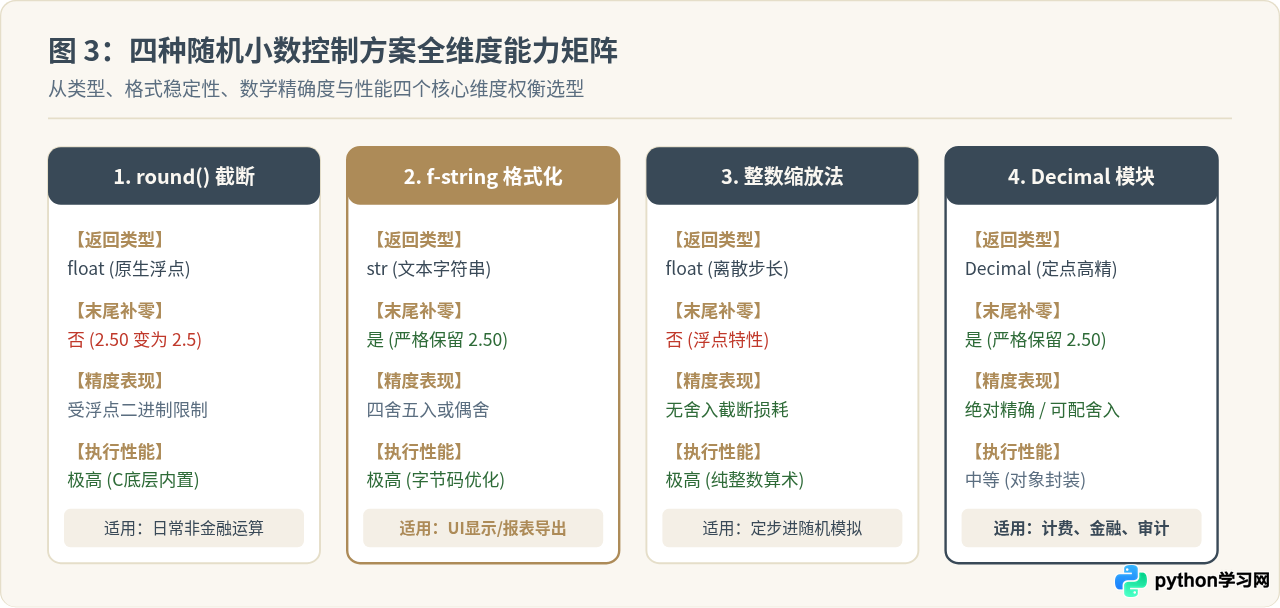
四、各方案横向对比与技术矩阵
为了在实际开发中准确选型,下表对四种主要控制方案的类型表现、补零能力、精度可靠性与性能表现进行了综合汇总:
| 控制方式 | 返回类型 | 末尾保留 0 | 舍入规则 | 主要适用场景 |
|---|---|---|---|---|
round(val, n) |
float |
否(自动略去无效 0) | 银行家舍入(奇进偶舍) | 通用数值计算、轻量截断 |
f"{val:.Nf}" |
str |
是(严格保留指定位数) | 标准格式化舍入 | 终端输出、网页呈现、日志报表 |
randint() / 10^n |
float |
否(浮点属性) | 无截断损耗(直接步进) | 固定步长离散模拟、抽奖与游戏数值 |
Decimal.quantize() |
Decimal |
是(对象包含精度上下文) | 可自由指定(HALF_UP等) | 财务计费、汇率换算、高精计量 |
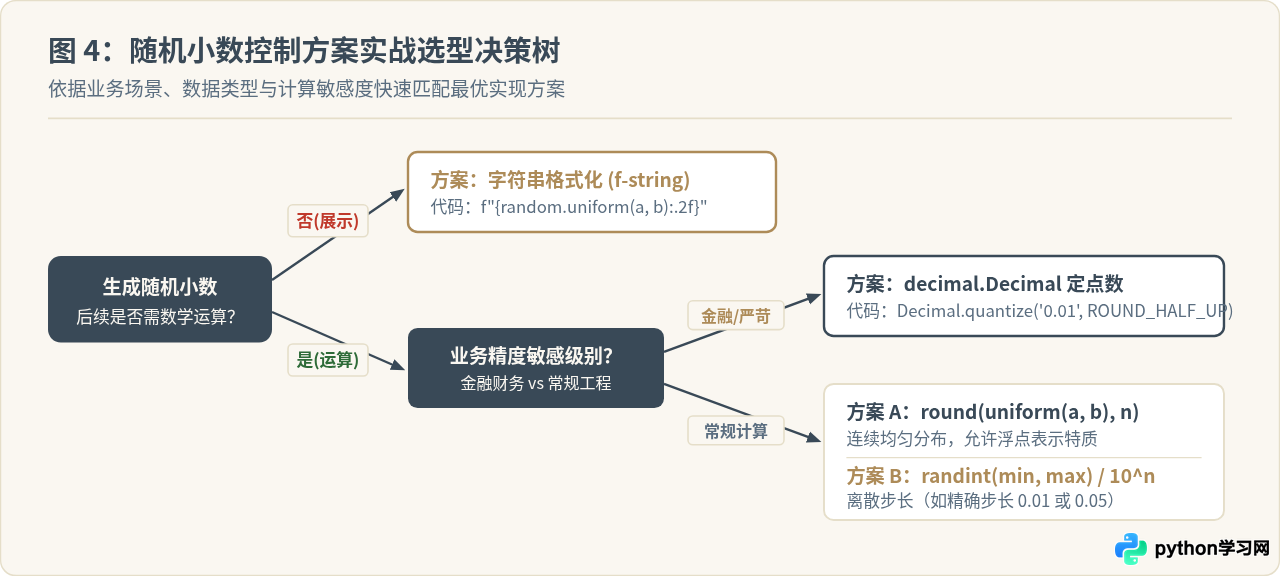
五、工程实践与常见问题排查
1. 如何生成精确包含固定步长的随机小数列表?
如果需要生成一个批量的随机小数列表,且每个数字都严格以 0.05 或 0.01 为最小步长,最稳健的做法是利用列表推导式结合整数缩放:
import random

# 生成 5 个范围在 1.00 到 5.00 之间,精确步长为 0.05 的随机浮点数
step_decimals = [random.randrange(100, 505, 5) / 100 for _ in range(5)]
print(f"固定步长随机数列表: {step_decimals}")
示例输出:
固定步长随机数列表: [3.45, 1.2, 4.85, 2.1, 4.0]2. 为什么 round() 之后存入数据库依然多出很多小数位?
有时在代码中执行了 round(val, 2),但将结果插入 MySQL 或 SQLite 后,数据库里却显示为 12.3000000000000007。
这是由于数据库字段被定义为了 DOUBLE 或 FLOAT 二进制浮点类型。即便 Python 中截断为了 2 位小数,只要底层以二进制存储,微小的二进制近似依然不可避免。彻底解决这一问题的方法是:在数据库中使用 DECIMAL(10, 2) 或 NUMERIC 字段,并在 Python 侧使用 decimal.Decimal 进行数据写入。
3. 科学计算场景下的批量随机数精度控制
如果是在数据科学或机器学习场景下使用 NumPy,无需使用循环逐个调用 round()。NumPy 提供了向量化的随机生成与四舍五入支持:
import numpy as np

# 一次性生成 1000 个在 [0, 1) 范围并保留 3 位小数的随机数组
arr = np.random.uniform(0.0, 1.0, size=1000)
controlled_arr = np.round(arr, decimals=3)
print(f"前 5 个元素: {controlled_arr[:5]}")
六、总结与开发建议
控制 Python 随机小数的位数和精度并非单一函数的问题,而是数据流转周期的设计问题。开发时遵循以下三条核心准则即可高效避坑:
- 看而非算,首选格式化:只要目标用于字符串排版或用户展示,直接使用
f"{val:.2f}",省去后续补零的额外代码; - 离散步长,首选整数法:对于固定精度的离散随机点(如分、厘),使用
random.randint() / 100结构最轻量、分布最均匀; - 涉及资产,必用 Decimal:在计费、资金分配和高精度计量场景中,将
random生成的浮点转为Decimal并配合quantize()明确声明舍入规则,确保业务逻辑安全合规。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















