


Python怎么创建集合:花括号{}与set()函数的用法区别
详细讲解在Python中创建集合的两种核心方式:使用花括号字面量{}与使用set()内置函数。从空集合判定陷阱、可迭代对象转换机制、CPython字节码执行开销到实战选型决策树,全面解析两者的用法差异与避坑技巧。
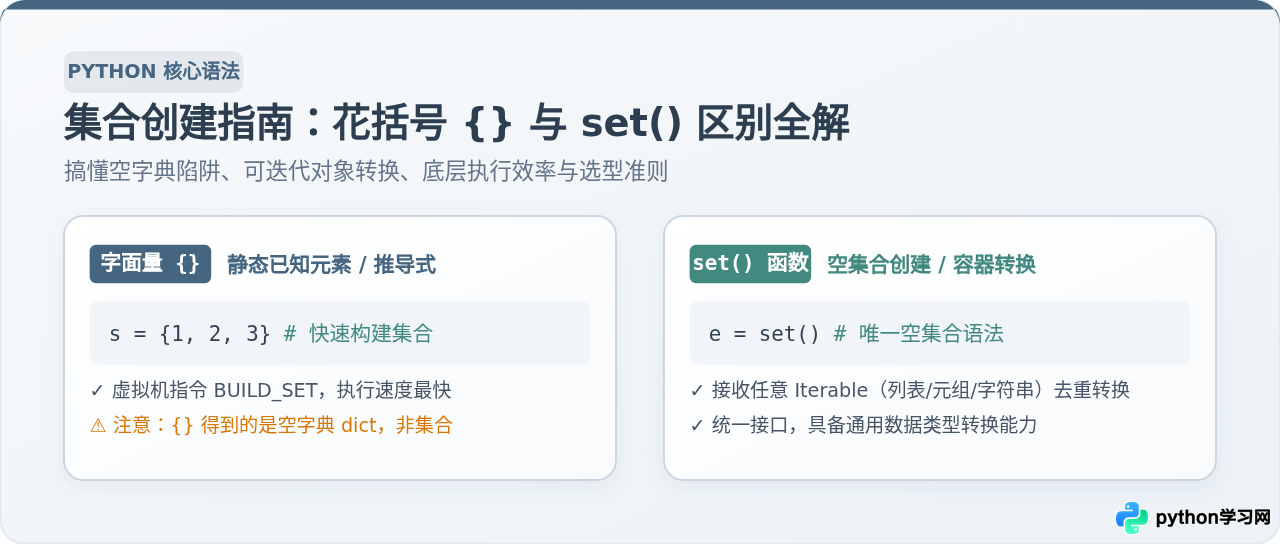
{item1, item2},或者调用内置函数 set()。虽然两者的最终产物都是由唯一、可哈希对象组成的集合,但在空集合初始化、可迭代对象支持、底层执行性能以及语法二义性上有本质区别。最容易混淆的规则在于:单独的空花括号 {} 生成的是空字典而不是空集合,创建空集合必须使用 set()。
一、使用花括号 {} 创建集合的方法与限制
花括号是 Python 中书写集合字面量(Set Literal)的原生语法。当我们在花括号内放入以逗号分隔的单个值时,解释器会将其解析为一个集合对象。
1. 静态已知元素的字面量创建
当你在编写代码时就已经明确知道集合包含哪些具体值,可以直接使用花括号进行定义。如果花括号内写了重复值,Python 在构建集合时会自动去重,仅保留一份:
# 定义包含固定常量的集合
numbers = {1, 2, 3, 4, 4, 2}
fruits = {"apple", "banana", "orange", "apple"}

print("numbers 集合:", numbers)
print("fruits 集合:", fruits)
print("类型验证:", type(numbers))fruits 集合: {'banana', 'apple', 'orange'}
类型验证: <class 'set'>
从输出可以看到,重复出现的数字 4、2 以及字符串 "apple" 在初始化时直接被合并。同时,集合输出的元素顺序与书写顺序可能不一致,这是因为 Python 集合底层依赖哈希表组织元素,不维护元素的插入顺序。
2. 集合推导式(Set Comprehension)
除了直接列举元素,花括号还支持推导式语法,允许我们在创建集合的同时进行循环计算和条件过滤:
# 提取 0 到 9 之间偶数的平方集合
even_squares = {x ** 2 for x in range(10) if x % 2 == 0}
print("偶数平方集合:", even_squares)TypeError: unhashable type 异常。
3. 空花括号的二义性与空字典陷阱
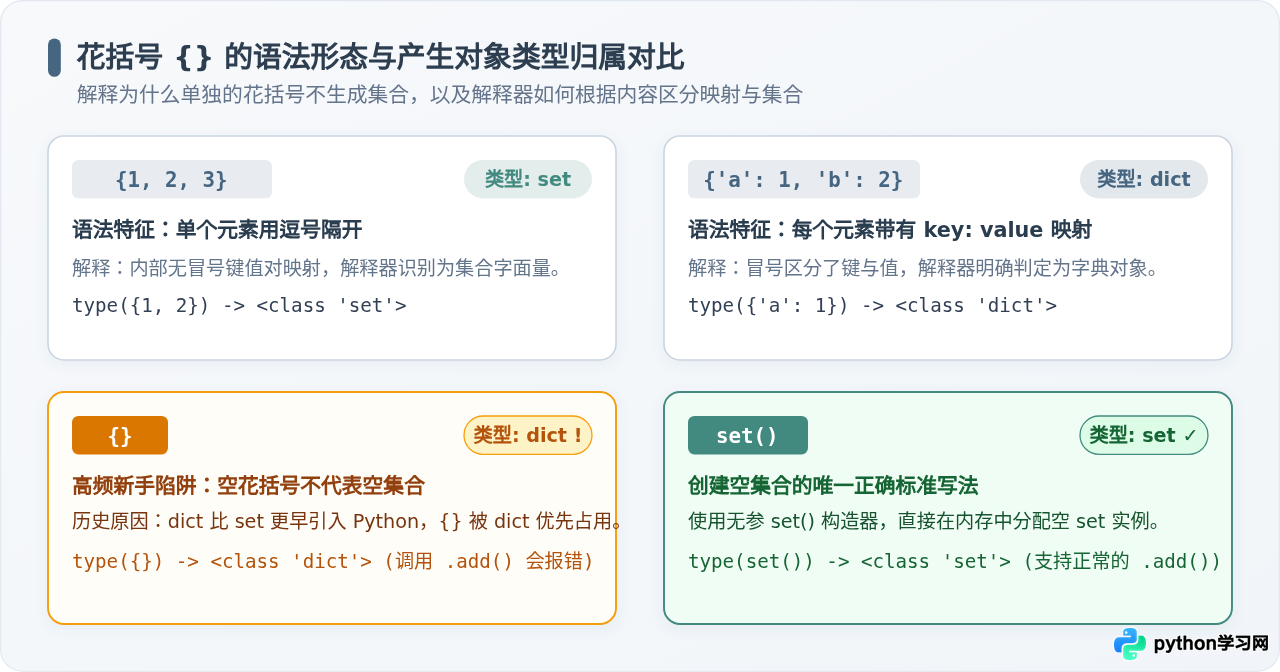
初学者最容易踩中的一个语法陷阱,是试图用 {} 创建一个空集合。在 Python 中,空花括号在词法分析阶段被明确绑定为空字典(dict):
empty_val = {}
print("值:", empty_val)
print("类型:", type(empty_val))类型: <class 'dict'>
产生这一设计的原因是历史演进:字典(dict)在 Python 早期版本就已存在并使用了花括号语法,而集合(set)直到 Python 2.4 才作为标准库引入、在 Python 3 中获得花括号字面量支持。由于空字典语法已被广泛使用数十载,Python 无法将 {} 挪给集合,因而规定空花括号一律表示空字典。
二、使用 set() 内置函数创建集合的机制
set() 是 Python 提供的内置构造函数。与花括号字面量不同,set() 接受零个或一个参数,具备统一的对象实例化与类型转换能力。
1. 创建真正的空集合
当不传入任何参数调用 set() 时,Python 会在内存中分配并返回一个没有任何元素的空集合对象:
empty_set = set()
print("空集合内容:", empty_set)
print("空集合类型:", type(empty_set))

# 正确调用集合专有的 .add() 方法
empty_set.add("python")
empty_set.add("algorithm")
print("添加元素后:", empty_set)空集合类型: <class 'set'>
添加元素后: {'python', 'algorithm'}
如果错误地使用了 s = {},在后续调用 s.add() 时程序会立即报错终止,因为字典对象并没有 .add() 方法。
2. 将任意可迭代对象(Iterable)转换为集合
set() 函数最强大的功能在于类型转换。它可以接收列表、元组、字符串、字典键视图、生成器甚至打开的文件句柄,并在转换过程中完成自动去重:
# 1. 列表转集合去重
data_list = [10, 20, 10, 30, 20, 40]
set_from_list = set(data_list)
print("列表去重结果:", set_from_list)

# 2. 字符串拆解为字符集合
text = "mississippi"
set_from_str = set(text)
print("字符串拆解去重:", set_from_str)

# 3. 字典转集合(默认提取所有键)
info = {"name": "Alice", "age": 25, "role": "admin"}
set_from_dict = set(info)
print("字典提取键集合:", set_from_dict)

# 4. 生成器表达式转换
gen_set = set(x * 2 for x in range(5))
print("生成器转换结果:", gen_set)字符串拆解去重: {'m', 'i', 'p', 's'}
字典提取键集合: {'name', 'role', 'age'}
生成器转换结果: {0, 2, 4, 6, 8}
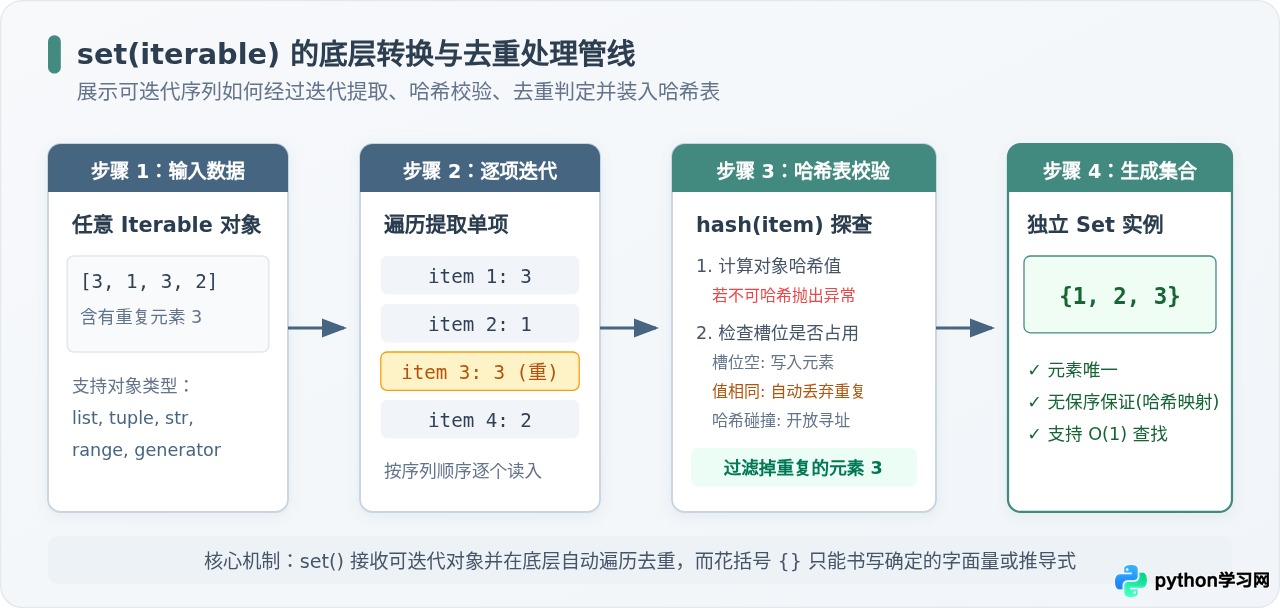
请特别注意字符串传入 set() 的行为:因为字符串在 Python 中本身是字符序列,set("hello") 会将字符串拆散为单个字符并去重,得到 {'h', 'e', 'l', 'o'};而如果你想要一个只包含完整字符串 "hello" 的单元素集合,必须写成字面量 {"hello"} 或传入单元素序列 set(["hello"])。
三、花括号 {} 与 set() 的用法区别深度对比
为了在开发中做出清晰且高效的语法选择,我们需要从语法形态、参数支持以及底层执行性能三个维度全面对比两者的区别。
| 对比维度 | 花括号语法 {} | set() 内置函数 |
|---|---|---|
| 空对象结果 | 创建空字典 dict(非集合) | 创建空集合 set(唯一官方正确方式) |
| 输入参数形式 | 书写由逗号隔开的字面量或推导式表达式 | 接收 0 个或 1 个可迭代对象(Iterable) |
| 外部序列转换 | 不支持直接传入变量解包(如 {my_list} 报错) |
原生支持,如 set(my_list) 一步完成转换 |
| 字符串处理语义 | {"abc"} 产生含 1 个字符串的集合 |
set("abc") 拆散产生含 3 个单字符的集合 |
| CPython 底层字节码 | 直接调用专属指令 BUILD_SET |
查找全局/内置函数符号并调用 CALL_FUNCTION |
| 执行速度基准 | 极高(无函数寻址与栈帧开销) | 适中(常规函数调用与解包开销) |
底层字节码差异与执行性能剖析
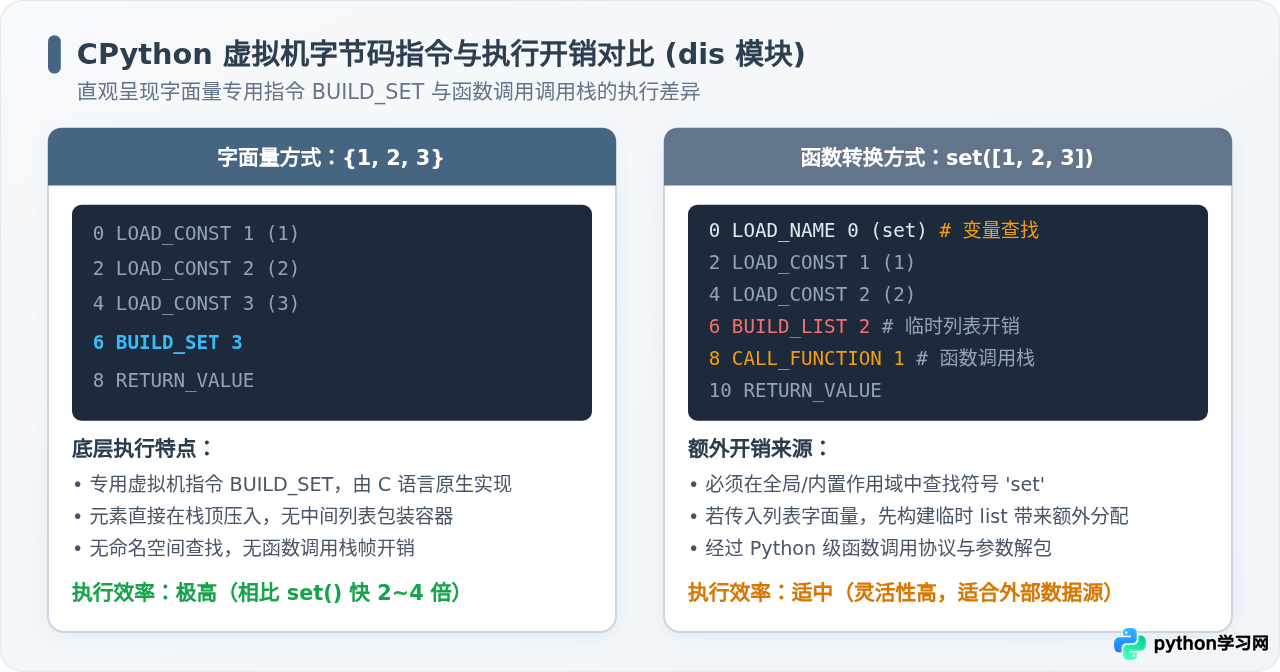
为什么直接书写已知常量的集合时推荐使用花括号,而不是 set([1, 2, 3])?通过 Python 标准库自带的 dis 模块反编译字节码,可以直观观察到虚拟机执行路径的差异:
import dis

print("--- 花括号字面量字节码 ---")
dis.dis("s = {1, 2, 3}")

print("
--- set() 函数调用字节码 ---")
dis.dis("s = set([1, 2, 3])")1 0 LOAD_CONST 0 (1)
2 LOAD_CONST 1 (2)
4 LOAD_CONST 2 (3)
6 BUILD_SET 3
8 STORE_NAME 0 (s)
--- set() 函数调用字节码 ---
1 0 LOAD_NAME 0 (set)
2 LOAD_CONST 0 (1)
4 LOAD_CONST 1 (2)
6 LOAD_CONST 2 (3)
8 BUILD_LIST 3
10 CALL_FUNCTION 1
12 STORE_NAME 0 (s)
从字节码中可以清晰看到:
-
字面量写法:解释器在栈顶加载常量后,直接调用 C 原生实现的专用操作码
BUILD_SET,不需要查找变量名,没有建立函数调用栈帧的额外开销。 -
set() 函数写法:必须先通过
LOAD_NAME在作用域命名空间中搜索名为set的内置函数,接着执行BUILD_LIST在内存中分配并构造一个临时的列表对象,最后通过CALL_FUNCTION触发函数调用与参数传递。
由于省去了符号查找、临时容器构造以及函数调用协议的开销,在已知元素的情况下,花括号字面量的构造速度通常比 set([1, 2, 3]) 快 2 到 4 倍。
四、场景选型与实战决策树
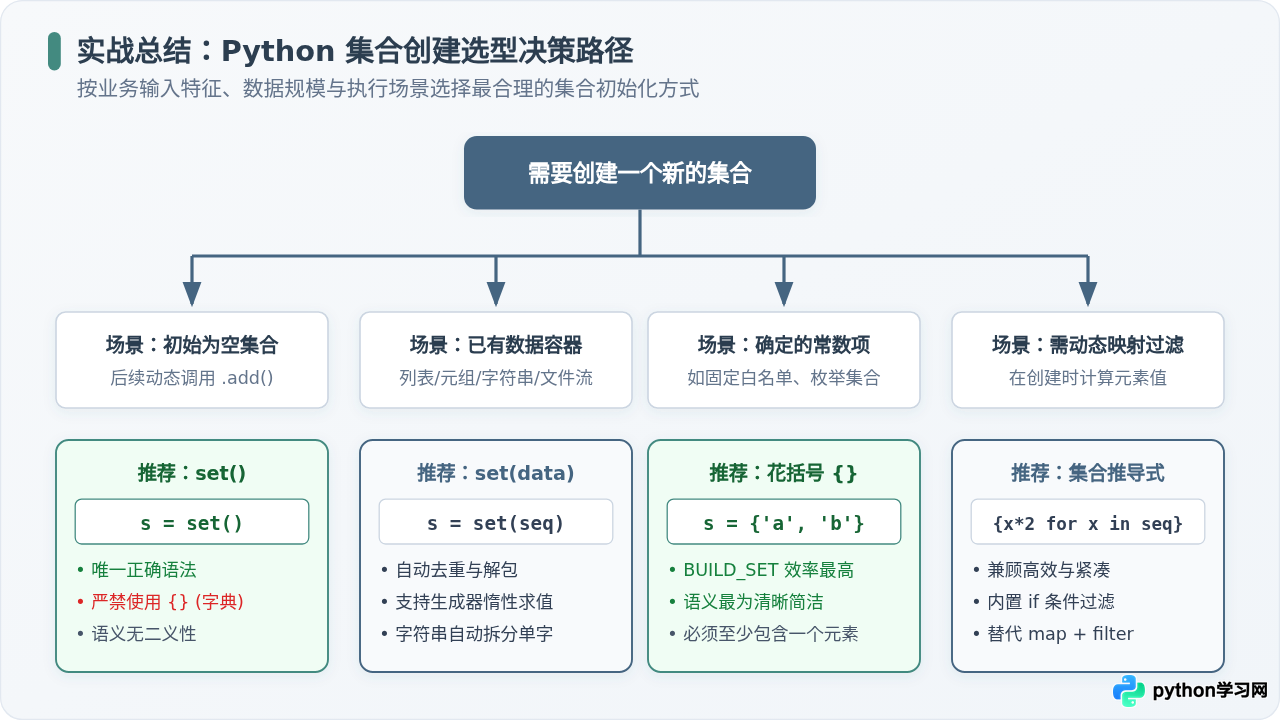
在日常开发中,究竟何时该用花括号,何时该用 set()?你可以根据以下四种典型业务场景对照选择:
-
需要初始化一个初始为空的集合:
唯一选择:必须使用s = set()。切记绝对不要写成s = {}。 -
手中已经有现有序列或容器(列表、元组、文件生成器)需要去重或转换:
首选:使用s = set(existing_data)。这是标准且最直观的类型转换手段。 -
定义已知、固定的常量集合(如白名单、状态枚举、过滤条件):
首选:使用花括号字面量VALID_STATUS = {"pending", "approved", "rejected"}。代码简洁易读,并且能获得最高的执行效率。 -
需要根据循环逻辑动态计算并过滤元素:
首选:使用集合推导式{transform(x) for x in dataset if condition(x)}。相比使用循环逐步.add()或配合map/filter,推导式结构紧凑且由底层优化执行。
五、常见报错与避坑指南
在处理集合创建时,开发者最常遭遇以下三类错误与困惑,排查方法如下:
1. 误将列表放入集合字面量引发 TypeError
当试图把一个列表直接作为集合元素书写时,Python 会立即阻断并抛出异常:
# 错误:将列表作为集合元素
invalid_set = {[1, 2], [3, 4]}
原因与修正:集合内部元素必须是不可变的(可哈希的)。列表的内容随时可能被修改,如果其哈希值改变,集合将无法唯一定位该元素在哈希表中的槽位。若业务上确实需要嵌套复合结构,应将内部列表替换为元组:valid_set = {(1, 2), (3, 4)}。
2. 空集合写成 {} 导致 AttributeError
如果写下 s = {},在后续代码执行动态插入时:
tags = {}
tags.add("python")  # 抛出 AttributeError
修正:将初始化声明改为 tags = set() 即可恢复正常。
3. 单字符串被错误拆解为单字符集合
有时开发者希望将一个字符串作为单独的项目装入集合,却写成了 set("active"):
# 预期:包含单个字符串 "active" 的集合
wrong = set("active")
correct_literal = {"active"}
correct_func = set(["active"])

print("错误写法:", wrong)
print("正确字面量:", correct_literal)
print("正确函数传参:", correct_func)正确字面量: {'active'}
正确函数传参: {'active'}
只要牢记 set() 会自动将传入的参数当做可迭代序列逐字拆解,即可避免此类字符串拆散的非预期行为。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















