


怎么用Python向现有CSV文件追加写入数据
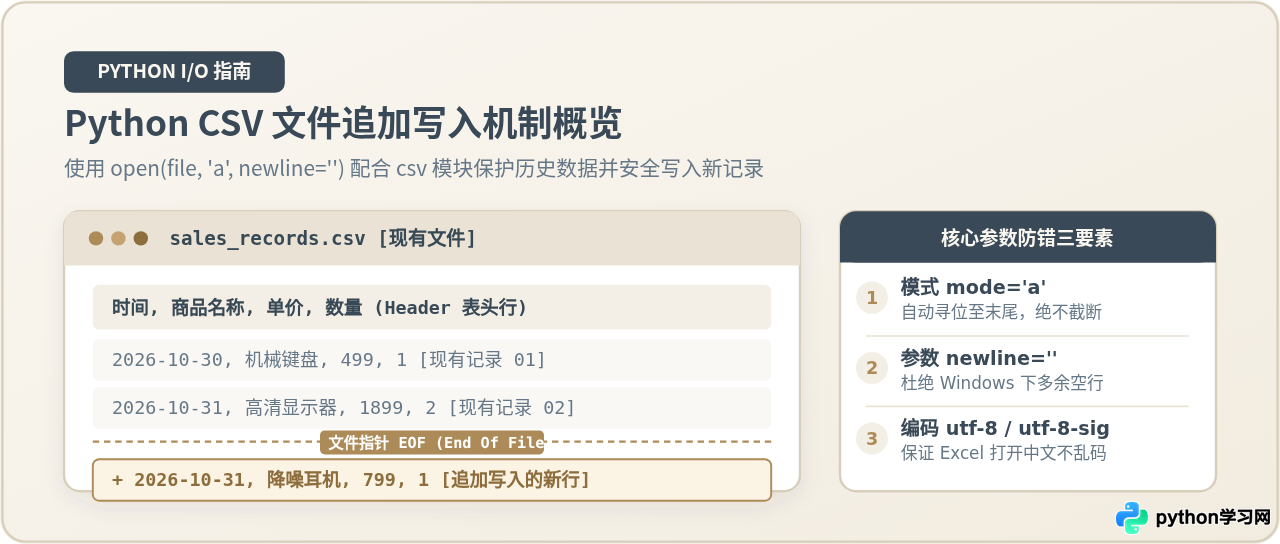
本文系统讲解如何使用Python向现有CSV文件追加写入数据,从标准库csv.writer与DictWriter到Pandas批处理,深入剖析mode='a'、newline参数与表头防重逻辑,提供完整可靠的代码示例。
'a' 打开文件,同时显式设置 newline='' 消除操作系统默认换行差异,并通过 Python 标准库内置的 csv.writer 或 csv.DictWriter 实现数据的按行格式化与磁盘写入。本篇指南将分步拆解底层机制、代码实现、表头防重逻辑以及 Pandas 批处理追加技巧。
一、文件打开模式:为什么必须是 'a' 而非 'w'
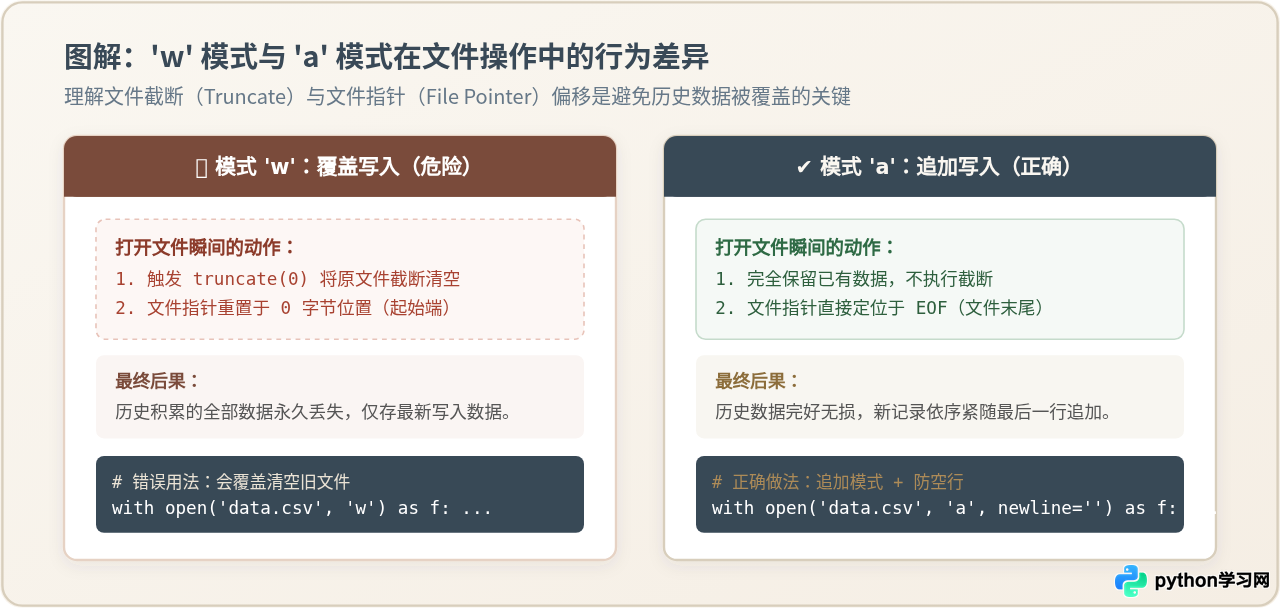
在 Python 中向磁盘文件写入内容,通常使用内置函数 open()。该函数的第二个参数控制文件的打开模式。初学者在尝试追加数据时,最容易出现的严重误操作是继续沿用常规写模式 'w'。
当传入 mode='w' 时,操作系统的文件子系统会在打开瞬间将文件尺寸截断为 0 字节(即清空旧内容),文件指针强制重置在起点,这会导致历史业务记录全部丢失。而传入 mode='a'(Append 追加模式)时,系统会在打开文件时保留已有的一切字节,并直接把文件操作指针(File Pointer)定位于文件末尾(EOF)。随后每一次写入调用,都在文件最末端续写,从而保障了历史数据的完整性。
二、使用标准库 csv.writer 追加列表型数据
Python 自带的 csv 模块无需通过 pip 额外安装,是处理 CSV 文件最直接高效的工具。如果手头的数据是以列表(List)或元组(Tuple)形式组织的单一数据项,使用 csv.writer 是最适合的选择。
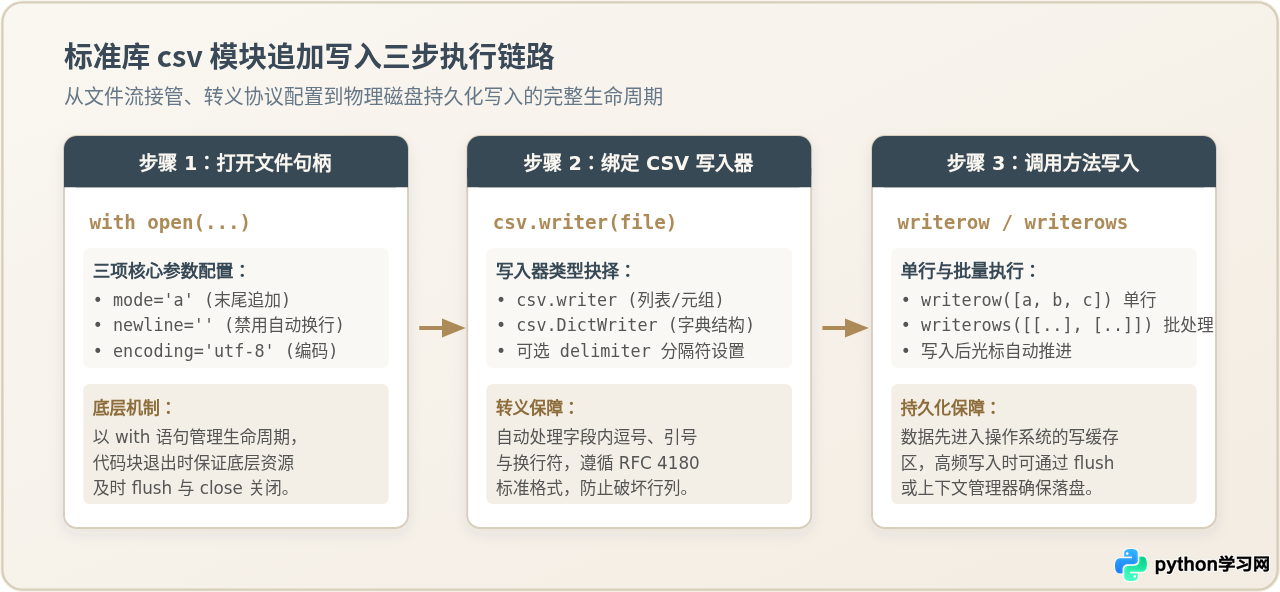
1. 追加单行数据:writerow()
假设当前目录中已有一份名为 sales_records.csv 的销售账单文件,我们需要在末尾追加一笔新的订单记录:
import csv

# 准备待追加的新单行数据(列表格式)
new_record = ['2026-10-31', '降噪耳机', '799', '1']

# 使用 'a' 模式追加,必须指定 newline=''
with open('sales_records.csv', mode='a', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(new_record)

print("单行记录追加完成!")
2. 追加多行数据:writerows()
若有一批从网络请求、传感器或消息队列收集到的多条记录,逐行调用 writerow() 会产生不必要的函数调用开销。此时应调用 writerows() 传入由多个子列表构成的二维列表:
import csv

batch_records = [
    ['2026-10-31', '无线鼠标', '129', '3'],
    ['2026-10-31', '人体工学椅', '1499', '1'],
    ['2026-10-31', 'Type-C拓展坞', '189', '2']
]

with open('sales_records.csv', mode='a', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerows(batch_records)

print("批量数据追加完成!")
在 Windows 系统中,标准换行符为
,而 Unix/Linux/macOS 为
。Python 的 open() 函数在默认情况下会自动进行换行符转换,而 csv 模块内部自带有换行符规范输出逻辑。如果不加 newline='',在 Windows 等平台下每一次 writerow() 写入都会导致数据行之间凭空多出一个空白行。
三、使用 csv.DictWriter 追加字典格式数据
在实际项目(如爬虫采集、RESTful API 响应提取)中,数据往往以字典结构呈现,键名(Key)对应列名,键值(Value)对应单元格内容。此时使用 csv.DictWriter 可以摆脱按列下标固定顺序组织的脆弱性:
import csv

fieldnames = ['时间', '商品名称', '单价', '数量']

# 字典中键的顺序无需严格对应列先后
dict_record = {
    '商品名称': '机械键盘',
    '数量': '1',
    '单价': '499',
    '时间': '2026-10-31'
}

with open('sales_records.csv', mode='a', newline='', encoding='utf-8') as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    # 注意:追加写入时千万不要盲目调用 writer.writeheader(),否则表头会反复混入数据行中间
    writer.writerow(dict_record)
四、关键细节:动态检测与表头(Header)写入控制
在构建自动化脚本或爬虫流水线时,经常会遇到这样一种场景:脚本周期性运行,第一次运行时目标 CSV 文件尚不存在(或大小为 0),需要创建文件并写入表头;而之后的每次运行,文件已经存在,只需要续写数据行,坚决不能再次写入表头。
如果在每次追加时都执行 writeheader(),生成的 CSV 中就会夹杂大量的重复表头行,导致后续使用数据分析工具时报出类型转换错误。通过判断 os.path.exists() 以及 os.path.getsize(),可以构建一个自适应的健壮追加管道:
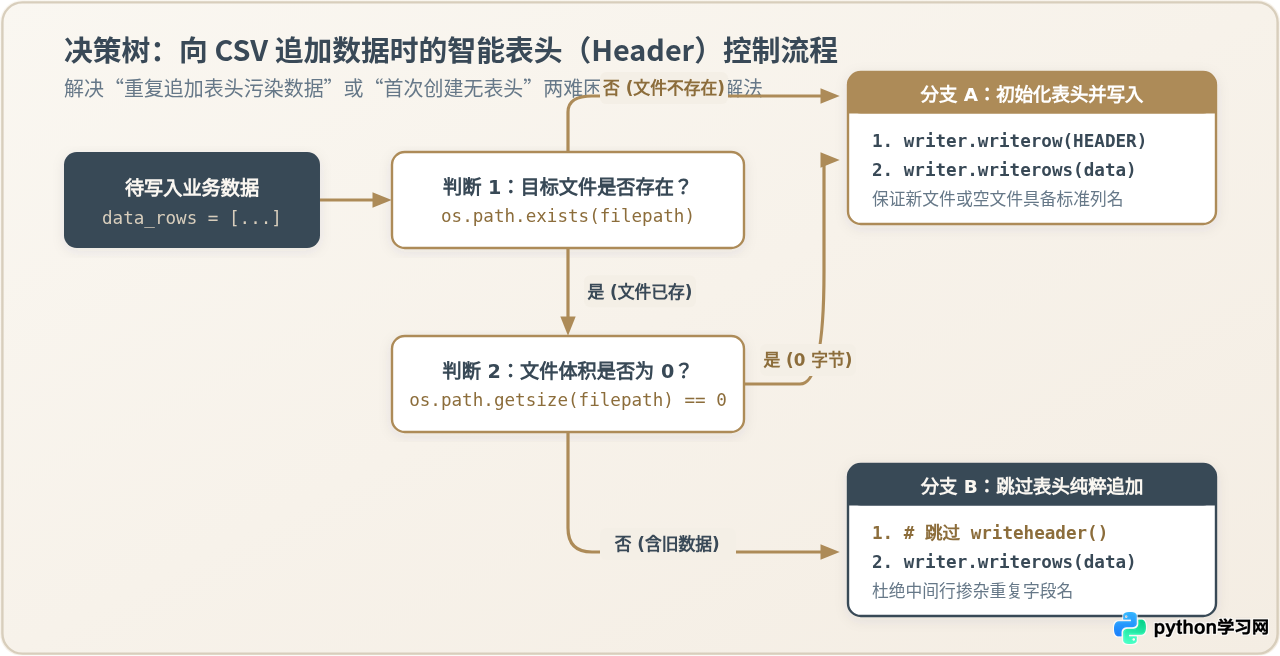
实现该逻辑的通用健壮代码如下:
import os
import csv

file_path = 'sales_records.csv'
fieldnames = ['时间', '商品名称', '单价', '数量']
incoming_data = [
    {'时间': '2026-10-31', '商品名称': '蓝牙音箱', '单价': '299', '数量': '2'}
]

# 核心判断:只有当文件不存在,或者文件虽然存在但内容为空时,才需要补写表头
need_header = not os.path.exists(file_path) or os.path.getsize(file_path) == 0

with open(file_path, mode='a', newline='', encoding='utf-8') as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    if need_header:
        writer.writeheader()
    writer.writerows(incoming_data)
五、数据分析场景:使用 Pandas 向现有 CSV 追加
在数据科学与分析工程中,数据通常承载于 pandas.DataFrame。Pandas 的 to_csv() 方法同样提供了 mode 参数,允许直接追加到现有文件。
使用 Pandas 追加时,必须格外注意以下两点配置:
- mode='a':指定底层以追加模式写入。
- header=False:现有文件中已有表头,追加时必须关闭表头写入;只有首次建表时才置为
True。 - index=False:默认情况下 Pandas 会将行索引(0, 1, 2...)写在第一列,追加数据时如果不关掉该参数,会导致索引列破坏原有字段对应关系。
import os
import pandas as pd

df_new = pd.DataFrame({
    '时间': ['2026-10-31'],
    '商品名称': ['人体工学鼠标垫'],
    '单价': [49],
    '数量': [5]
})

csv_target = 'sales_records.csv'
has_header = os.path.exists(csv_target) and os.path.getsize(csv_target) > 0

# 如果已有内容,则 header=False;若无内容,则 header=True
df_new.to_csv(
    csv_target,
    mode='a',
    header=not has_header,
    index=False,
    encoding='utf-8'
)
六、高频陷阱与防错检查清单
在实际执行追加写入时,除了掌握语法,还需规避以下四个隐性问题:
| 隐患场景 | 典型错误表现 | 技术解决方案 |
|---|---|---|
| Excel 中文乱码 | 用 Excel 打开追加后的 CSV,中文汉字显示为乱码字符 | 将编码参数由 utf-8 改为 utf-8-sig(附带 UTF-8 BOM 标记,适配微软 Office 套件) |
| Windows 隔行空行 | 追加后每条新数据下方都空出一整行 | open() 函数务必显式声明 newline='',由 csv 模块统一管理回车换行 |
| 多进程/多线程写入冲突 | 多处同时追加导致单条记录文字交织错乱、文件损坏 | 单机场景引入 filelock 互斥锁,分布式场景建议投递至队列并由单一进程集中写入 |
| 资源句柄未关闭 | 进程长时间占用文件,外部无法移动或删除 | 一律使用 with open(...) as f: 上下文管理器,由 Python 自动确保在离开作用域时 Flush 与 Close |
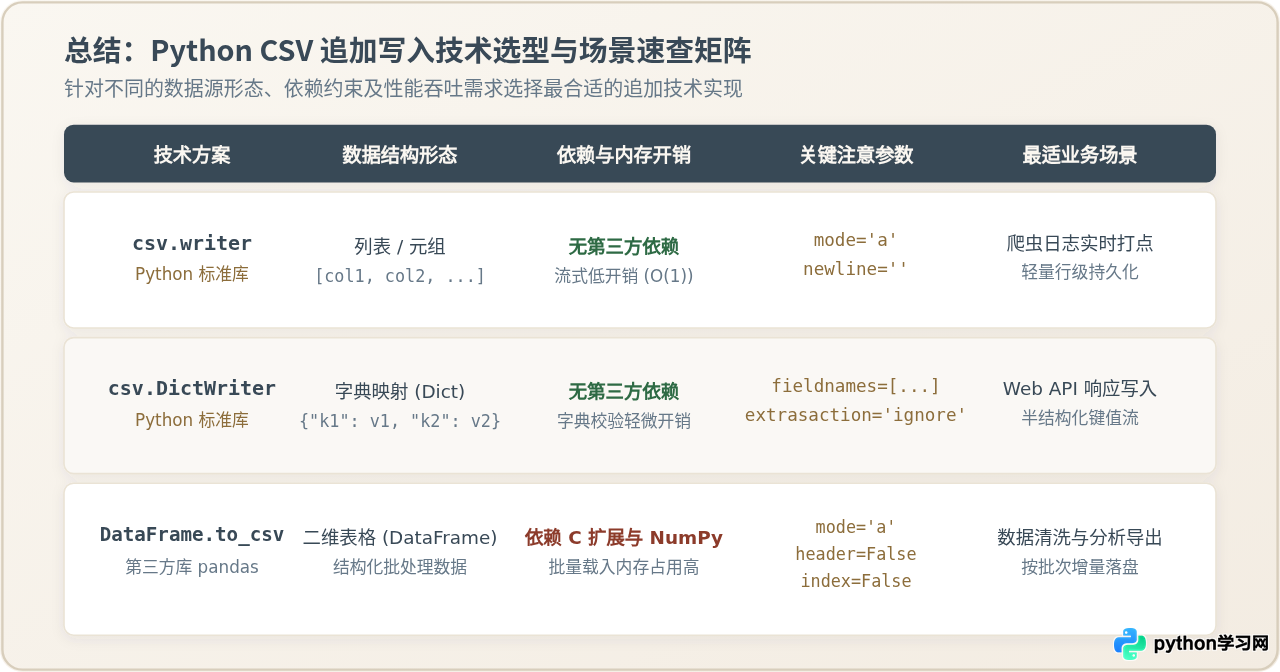
七、总结
使用 Python 向现有 CSV 文件追加写入数据的通用法则可以归纳为两句话:以 with open(file, 'a', newline='', encoding='utf-8') 打开目标管道,依据数据结构选择 csv.writer 或 csv.DictWriter 进行序列化写入。只要在工程中严把 mode='a'、空行抑制与动态表头检测三道关口,即可实现安全、高效、零损坏的数据累积与流式存储。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















