



在 Debian 上搭建 Python 爬虫,难点通常不在“代码写不出来”,而在环境是否干净、依赖是否装对、第一次运行出错时该查哪里。下面按从环境检查到示例运行的顺序梳理一遍,并补上常见的判断点,方便你快速确认自己已经具备最基本的爬虫运行条件。
先确认 Debian 里的 Python 环境是否可用
很多 Debian 系统已经自带 Python,但不同版本、不同安装方式下,命令名可能不完全一致。最稳妥的做法,是先分别检查 python 和 python3 是否可用。
python --version
python3 --version
如果终端能够正常返回版本号,说明系统里已经有可用的 Python 环境;如果没有,再通过 apt 安装。
sudo apt update
sudo apt install python3
sudo apt update 这一步不要省略,否则可能拿到旧的软件包索引,后续安装时也更容易遇到版本问题。
把 pip 补齐,后续装库才方便
Debian 上常见的情况是已经有 Python,但没有 pip,或者系统里只有部分 Python 工具链。先检查 pip3 是否可用:
pip3 --version如果命令没有正常返回版本信息,可以直接安装:
sudo apt install python3-pip装好之后,后面的第三方库基本都通过它来管理。对于 Debian 这类长期维护的系统来说,用系统包先补齐 python3-pip,通常比直接手动折腾安装脚本更省事。
为什么建议先建虚拟环境
这一步不是强制要求,但如果你准备长期维护爬虫项目,或者后面还会装更多解析库、调度库、数据库驱动,虚拟环境几乎是默认配置。它可以把项目依赖和系统全局 Python 隔离开,减少版本冲突。
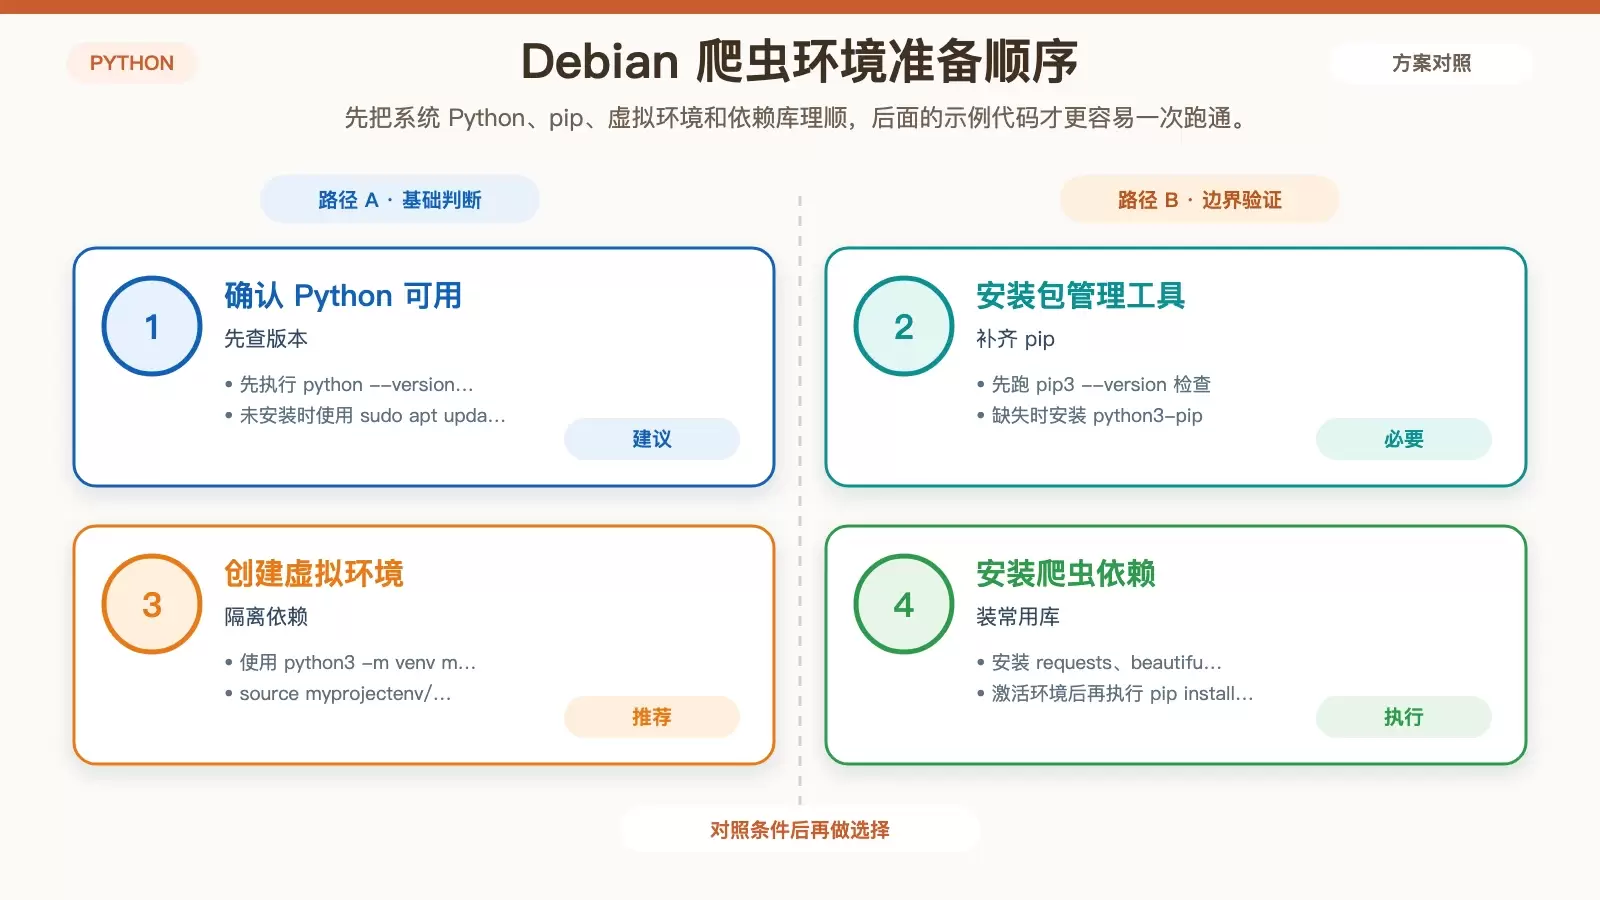
python3 -m venv myprojectenv
source myprojectenv/bin/activate
激活成功后,终端提示符前面通常会出现 (myprojectenv)。这说明当前 shell 已经进入独立环境,后续通过 pip 安装的库会优先写到这个项目目录里,而不是系统全局目录。
如果你没有激活虚拟环境就直接执行安装命令,那么依赖很可能会被写进系统 Python,这在后期排查问题时往往比较麻烦。
Debian 上常用的 Python 爬虫库怎么装
基础入门阶段,常见组合一般是:
requests:负责发送 HTTP 请求beautifulsoup4:负责解析 HTMLlxml:适合更快或更灵活的 XML/HTML 解析scrapy:适合更完整、结构化的爬虫项目
可以先一次性安装:
pip install requests beautifulsoup4 lxml scrapy这里原文使用的是 pip 命令。如果你已经进入虚拟环境,这样执行通常没有问题;如果还没有激活环境,就需要额外确认这些库会被安装到哪里。
入门阶段该怎么选库
如果你只是想抓一个页面、提取少量字段,requests + BeautifulSoup 就够用了。lxml 更适合对解析性能或 XPath 能力有要求的场景;而 scrapy 更像一个完整框架,适合后面把项目做大,而不是第一次试运行就必须上。
先写一个最小可运行示例
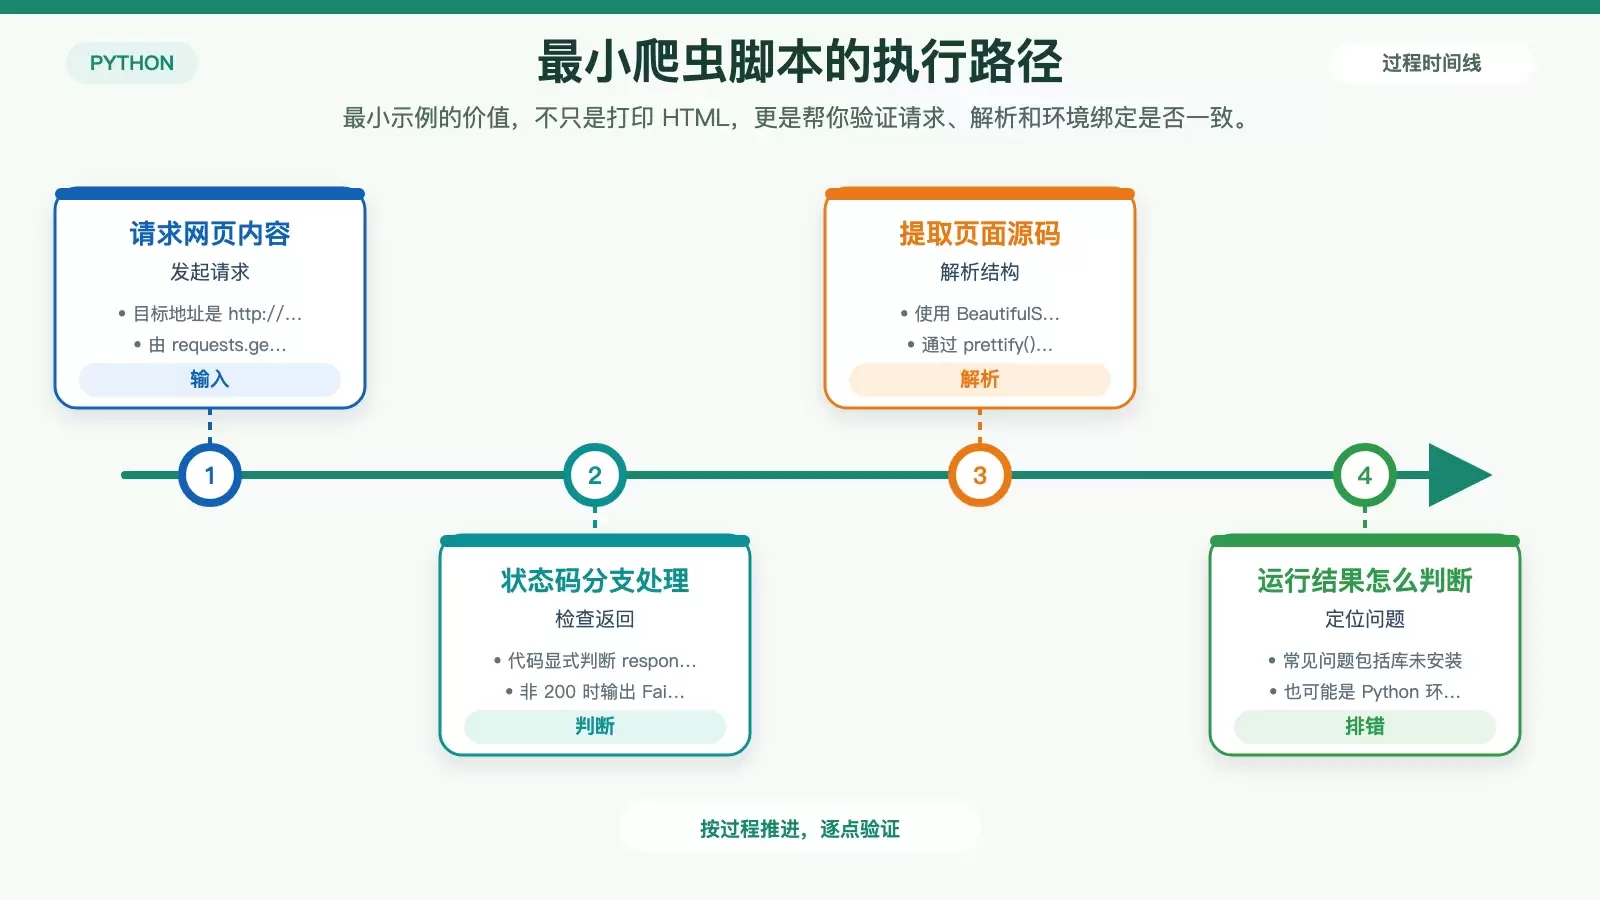
环境装好之后,最好先跑一个最简单的示例,确认请求、解析、输出这三件事都能通。新建 spider.py,写入下面这段代码:
import requests
from bs4 import BeautifulSoup

url = 'http://example.com'
response = requests.get(url)
if response.status_code == 200:
    soup = BeautifulSoup(response.text, 'html.parser')
    print(soup.prettify())
else:
    print('Failed to retrieve the webpage')
这段代码做的事情很直接:先请求 http://example.com,如果返回状态码是 200,就把网页内容交给 BeautifulSoup 解析,再通过 prettify() 输出格式化后的 HTML。
它适合作为环境验证示例,但还不算真正的生产级爬虫。实际项目里,通常还要补上请求头、超时控制、异常处理、重试逻辑等细节。
运行示例后,重点看哪些结果
示例代码保存完成后,直接执行:
python spider.py如果运行正常,终端会输出目标网页的 HTML 结构;如果报错,优先检查三类问题:
- 依赖库没有装好,比如缺少
requests或bs4 - 当前运行的 Python 与安装库时使用的环境不一致
- 网络访问异常,导致请求没有成功返回
第一次搭环境时,很多问题都不是代码逻辑本身,而是“命令执行所在环境”和“库安装所在环境”不一致。尤其是在系统 Python 和虚拟环境并存时,这一点最容易忽略。
正式开始抓取前,别忽略礼仪和数据落地
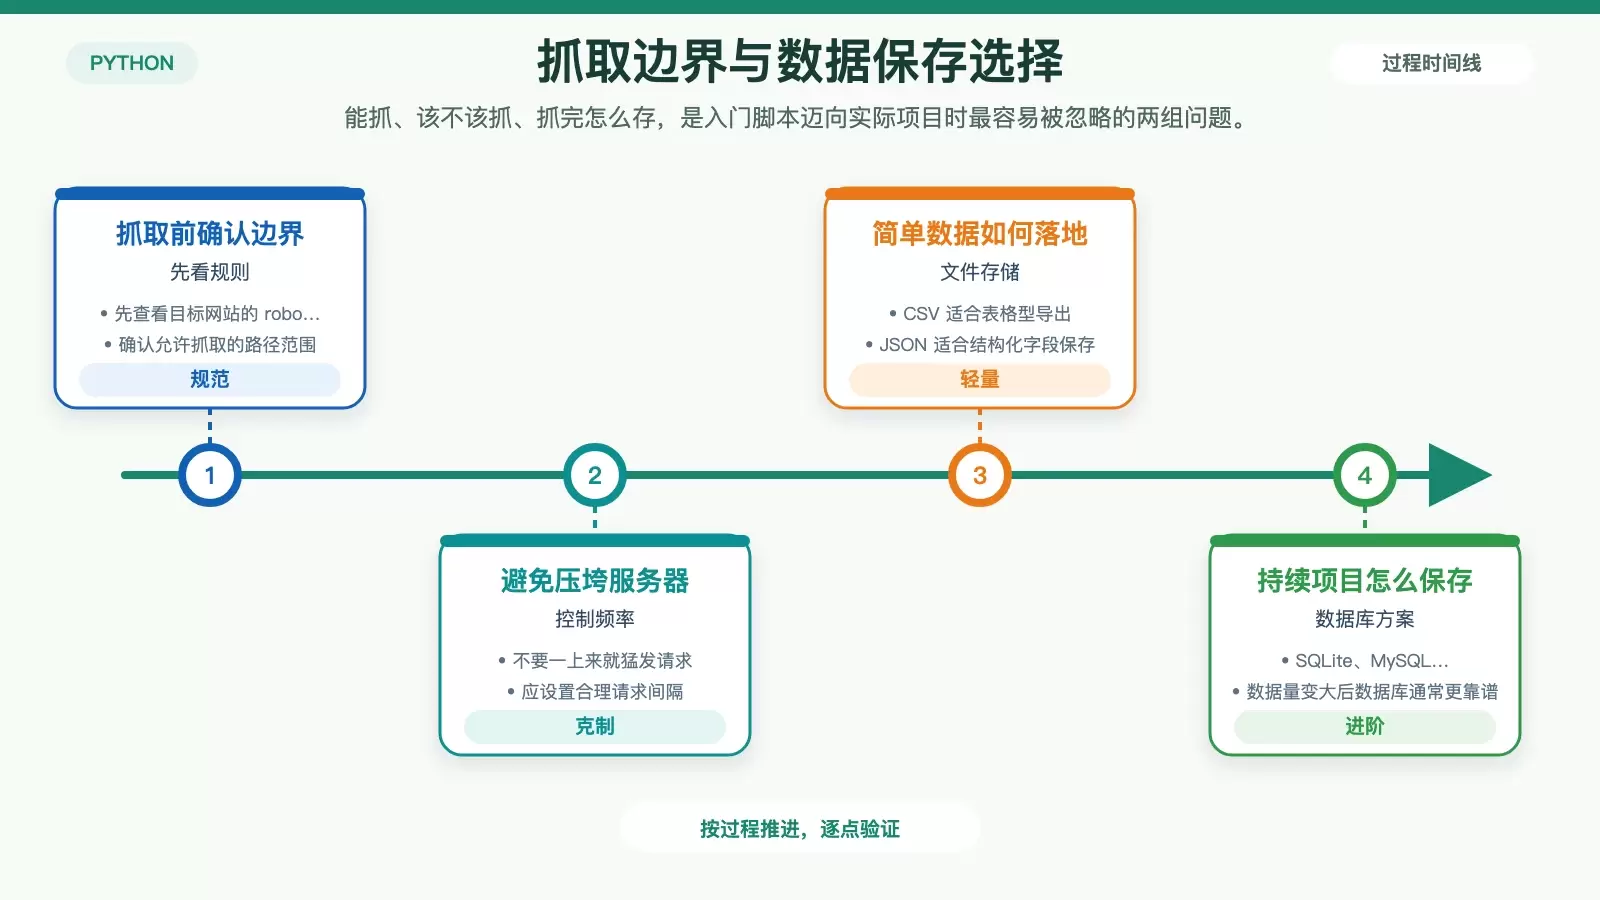
爬虫能跑起来,只是第一步。真正开始抓取目标站点前,至少还要考虑两个问题:能不能抓、抓完往哪放。
先看 robots.txt 和请求频率
不要一开始就高频发请求。先查看目标网站的 robots.txt 文件,了解哪些路径允许抓取,哪些路径有限制。同时给请求设置合理的间隔,避免给目标服务器造成不必要的压力。
这既是技术上的基本约束,也是做爬虫时最基本的边界意识。
抓到的数据可以怎么存
保存方式取决于后面打算怎么使用这些数据。常见选择包括:
- CSV:适合表格型数据导出和简单分析
- JSON:适合结构化字段保存和接口式处理
- 数据库:比如 SQLite、MySQL,适合归档、检索和持续更新
如果只是临时测试,追加到文本文件也能用;但只要数据量开始变大,或者你需要按条件查询,数据库通常会更靠谱。
从入门脚本走向实际项目,还会遇到什么
完成上面的流程后,你已经具备了 Debian 上运行 Python 爬虫的基础条件。再往后,项目通常会逐步碰到登录验证、动态加载、反爬机制、请求调度、数据清洗等问题。
比较稳妥的节奏是:先用最小示例确认环境和基本流程,再根据目标网站的特点逐步补库、改逻辑,而不是一开始就把项目堆到很复杂。















