



在 Ubuntu 上做多语言协作时,真正难的通常不是“能不能连起来”,而是怎么在开发成本、运行效率和后续扩展之间找到平衡。下面按常见场景把几种主流做法拆开讲,并保留关键代码与能力边界,方便你根据调用频率、实时性要求和系统规模做判断。
直接调用系统命令:最快上手的方案
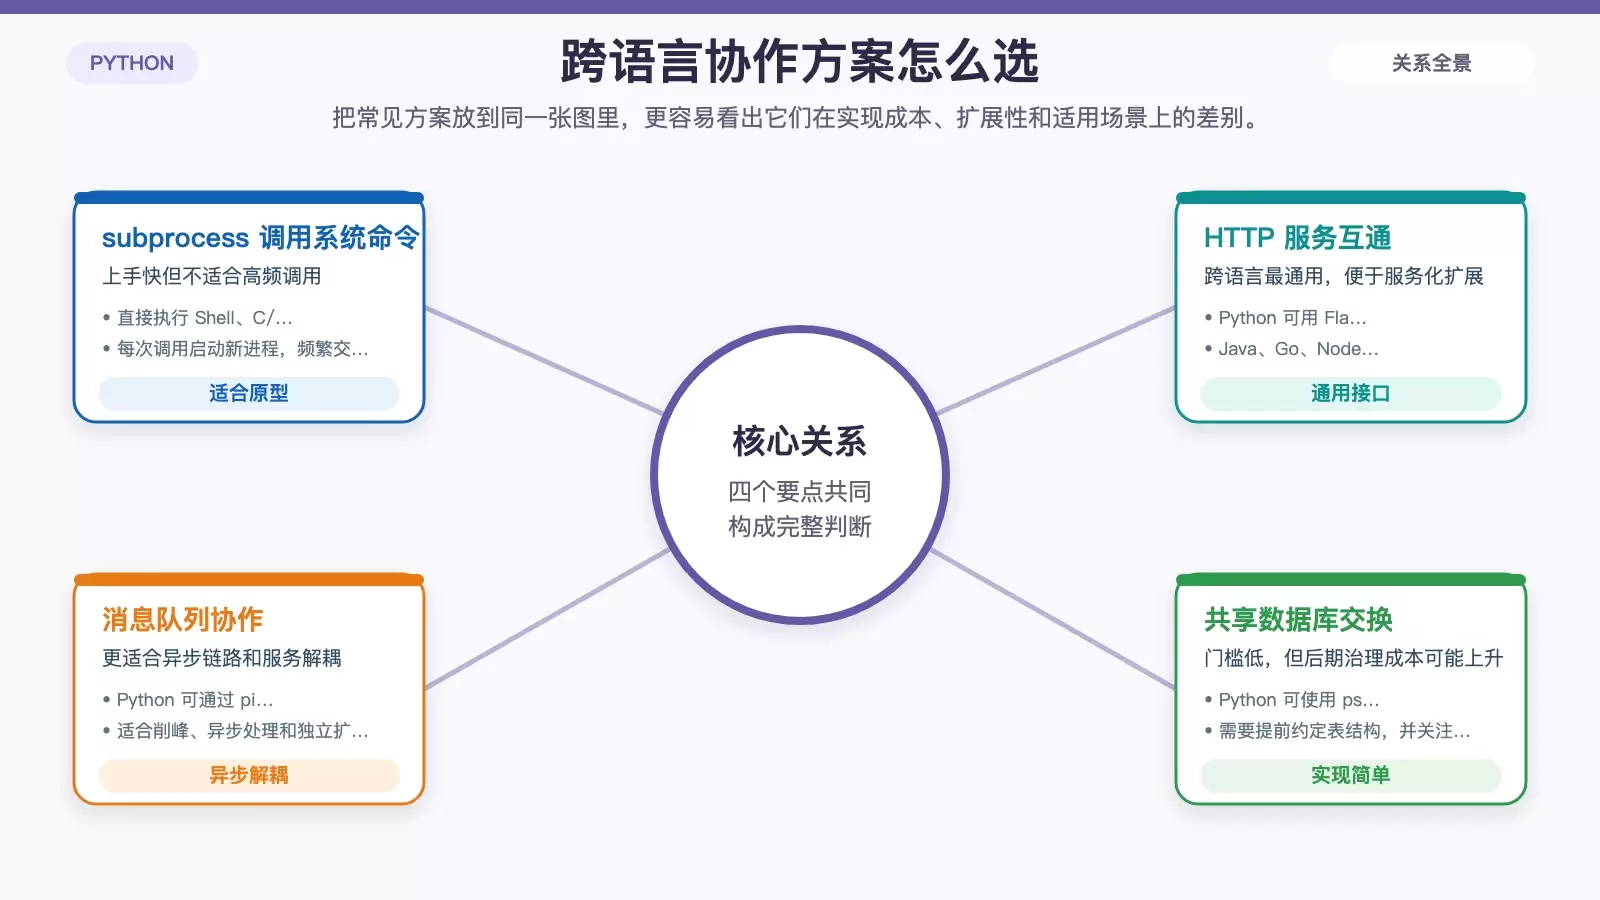
如果目标程序本身已经可以在命令行独立运行,那么用 Python 的 subprocess 模块直接调用,往往是最省事的入口。它很适合把 Shell 脚本、C/C++ 编译产物或现成命令行工具串起来,尤其适合快速原型、构建脚本和内部工具。
import subprocess
# 调用Shell脚本
subprocess.run(["./myscript.sh"])
# 或者直接执行命令
result = subprocess.run(["gcc", "myprogram.c", "-o", "myprogram"], capture_output=True, text=True)
print(result.stdout)
什么时候适合用
这类方式适合低频调用、流程型任务,以及“先跑通再优化”的场景。比如 Python 负责编排流程,Shell 负责部署,C++ 程序负责执行计算。
优点和限制
优点是实现简单,不需要额外服务或协议设计;限制也很明确:每次调用都会启动新进程,带来额外性能开销,不适合高频、低延迟的交互链路。
通过 HTTP 服务互通:最通用的跨语言接口
如果系统已经往服务化方向演进,或者参与方语言较多,那么把 Python 能力封装成 REST API,通常是最容易推广的方式。Python 侧可以使用 Flask、Django,其他语言如 Java、Go、Node.js 只要能发 HTTP 请求就能接入。
from flask import Flask, jsonify, request
app = Flask(__name__)

@app.route('/api/data', methods=['POST'])
def receive_data():
    data = request.json
    # 处理数据
    return jsonify({"result": "success"})

if __name__ == '__main__':
    app.run(debug=True)
这种方式解决什么问题
它解决的是“不同语言、不同进程、不同机器之间怎么稳定协作”的问题。接口定义清晰后,团队之间可以各自维护自己的服务,不必绑定在同一运行时里。
需要注意的成本
HTTP 的优势是灵活和易扩展,但代价是网络延迟与序列化开销。对于请求量大、响应要求严苛的链路,接口设计、连接复用和部署拓扑都要提前考虑。
异步协作与数据交换:消息队列和共享数据库怎么选
消息队列:适合解耦和异步处理
当不同语言写成的组件不需要同步返回结果,而是更强调削峰、异步处理和模块解耦时,消息队列通常更合适。Python 可以通过 pika 连接 RabbitMQ,其他语言也有成熟客户端,例如 Java 的 Spring AMQP、Go 的 streadway/amqp。
这种模式的优势在于服务之间可以独立扩缩容,某个消费者短时不可用,也不一定会直接拖垮整个流程。缺点是链路追踪、重复消费处理和消息一致性会比同步调用更复杂。
共享数据库:简单,但边界要收紧
如果只是做基础的数据交换,共享数据库是很多团队最先想到的方法。Python 常见适配器包括 psycopg2(PostgreSQL)和 mysql-connector-python(MySQL),其他语言同样有对应驱动。
它的优点是实现门槛低,只要提前约定表结构和数据格式,就能让多种语言围绕同一份数据协作。但这更像“共享存储”,而不是理想的服务接口。并发控制、事务边界、数据一致性和表结构演进,都是后期容易出现的问题。
追求实时性时,Socket 往往更直接
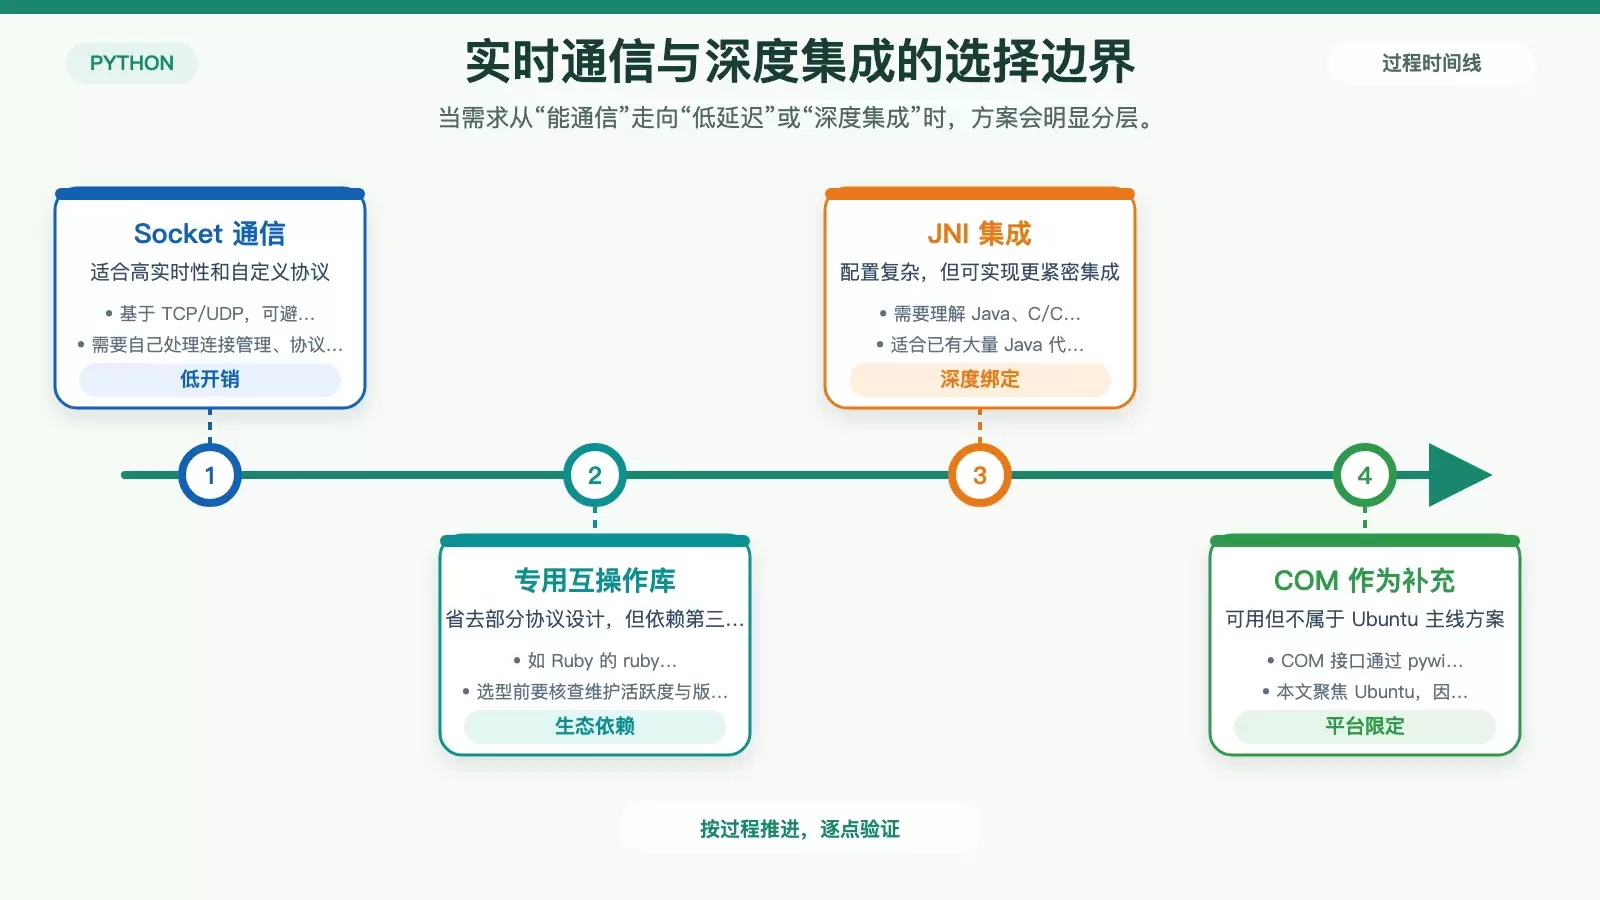
如果不希望引入 HTTP 或消息队列,又对实时性要求较高,可以直接使用 TCP/UDP 套接字通信。Python 自带 socket 模块,其他主流语言也都原生支持。
这种方式比较适合自定义协议、常驻连接、实时数据交换等场景。它的好处是控制力强、协议开销低;代价则是你需要自己处理连接管理、重试机制、粘包拆包以及协议演进问题。相比 REST API,开发和运维门槛都会更高一些。
更紧耦合的互操作:专用库与 JNI
外部互操作库
有些语言生态本身就提供了与 Python 互操作的库。例如 Ruby 的 ruby-python,可以让 Ruby 直接调用 Python 函数,反向协作也有类似思路。
这类方案通常能减少你自己设计协议的工作量,但选择前要重点确认两件事:一是项目是否仍在维护,二是它对当前 Ubuntu 环境、Python 版本和目标语言版本的兼容性如何。
JNI:面向 Java 深度集成的方案
如果目标是把 Python 与 Java 做更紧密的集成,JNI(Java Native Interface)是一条可行路径。它通常需要你理解 Java、C/C++ 与本地接口之间的协作方式,配置和调试成本都不低。
不过在已经有大量 Java 代码、又对性能和调用深度有要求的场景里,JNI 仍然有现实价值。它不是最轻便的选择,但适合那些明确要做深度绑定的系统。
Ubuntu 下怎么选:按场景做判断
如果你只是想把现有工具先接起来,subprocess 往往足够直接;如果系统要长期演进、调用方语言多,HTTP 服务通常是更稳妥的公共接口;如果任务天然异步、需要削峰解耦,消息队列更合适;如果看重实时性并愿意维护自定义协议,可以考虑 Socket;如果是特定语言生态的深度融合,再评估专用互操作库或 JNI。
共享数据库虽然常见,但更适合作为简单交换手段,而不是复杂系统中的首选通信方式。至于 COM 接口和 pywin32,那是 Windows 平台的补充方案,不属于本文讨论的 Ubuntu 主线。
实际落地时,可以优先问三个问题:调用是高频还是低频、需要同步返回还是异步处理、后续是否还会扩展到更多服务或更多语言。把这三个问题先想清楚,选型通常就不会偏得太远。















