


C语言进阶:深入理解数据在内存中的存储机制

C语言程序中变量在内存中的实际表现往往与直观认知存在差异。本文从整型的补码存储、大小端模式检测、无符号数的整型提升陷阱,到浮点数的IEEE 754标准,系统拆解数据在底层二进制层面的存储与转换机制,帮助开发者理解内存窗口背后的真实逻辑。
数据类型分类
在进行内存分析前,需明确C语言的数据分类。基本内置类型包括 int, char, float, double 等;构造数据类型(自定义类型)包含数组、struct(结构体)、union(共用体/联合)和 enum(枚举)。指针类型如 int*, void* 以及空类型 void 也是构建程序的基础。
利用内存窗口观察数据
要直观理解数据存储,必须学会使用调试器中的内存查看工具。不同版本的IDE界面略有差异,但核心观察要素一致:
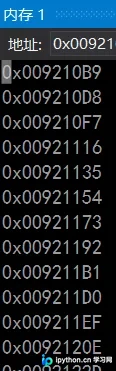
第1步:打开内存窗口并定位地址
在调试状态下,通过输入变量的内存地址来查看该区域的内容。首先需要找到变量的起始地址。
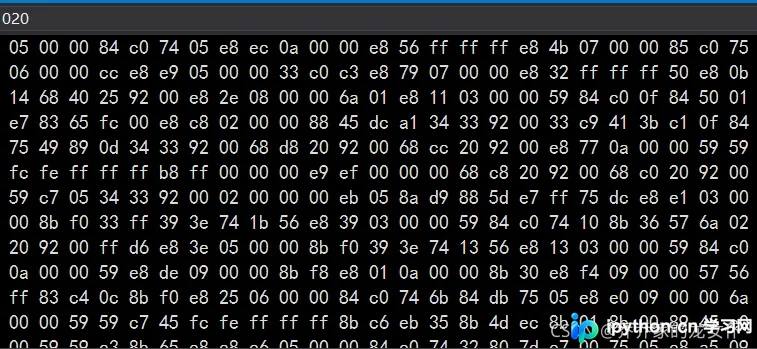
第2步:查看内存原始内容
内存窗口默认通常以16进制显示数据。对于非专业人士来说,这些十六进制数看起来杂乱无章,但计算机实际上存储的就是这些二进制序列对应的十六进制表示。
第3步:文本视图(ASCII/Text)
部分内存窗口提供文本或ASCII视图,它尝试将内存中的字节解释为字符。然而,由于内存数据并不总是合法的字符编码,这部分显示往往无意义或乱码,主要用于辅助确认是否为字符串数据。
整型的存储:原码、反码与补码
所有数据在内存中均以二进制形式存在。对于有符号整数(如 int),其最高位作为符号位(0为正,1为负)。计算机内部统一使用补码来存储数值,原因如下:
- 统一零的编码:消除正零和负零的区别。
- 简化硬件设计:CPU通常只有加法器。通过将减法转换为加法(例如
1 - 1视为1 + (-1)),可以使用同一套电路完成运算。 - 符号位参与运算:将符号位与数值位统一处理,无需额外判断。
三种码制的定义:
- 原码:直接将数值写成二进制,最高位为符号位。例如
-7的原码为10000000 00000000 00000000 00000111。 - 反码:正数反码同原码;负数反码是原码符号位不变,其余位按位取反。例如
-7的反码为11111111 11111111 11111111 11111000。 - 补码:正数补码同原码;负数补码是反码加1。例如
-7的补码为11111111 11111111 11111111 11111001。
案例分析:正数与负数的存储差异
声明变量 int a = 5; 和 int b = -5; 并在内存中观察:
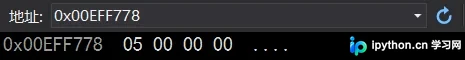
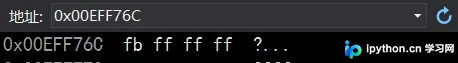
可以看到,a (5) 的二进制补码直接存储,而 b (-5) 则是经过取反加1处理后的结果。将 -5 的补码 11111111 11111111 11111111 11111011 每四位一组转换为十六进制,即为 0xFFFFFFF3。
大小端模式(Endianness)
对于超过1个字节的数据类型(如 int 占4字节),其在内存中的排列顺序有两种模式:
- 大端模式:数据的高字节保存在内存的低地址处。
- 小端模式:数据的低字节保存在内存的低地址处。
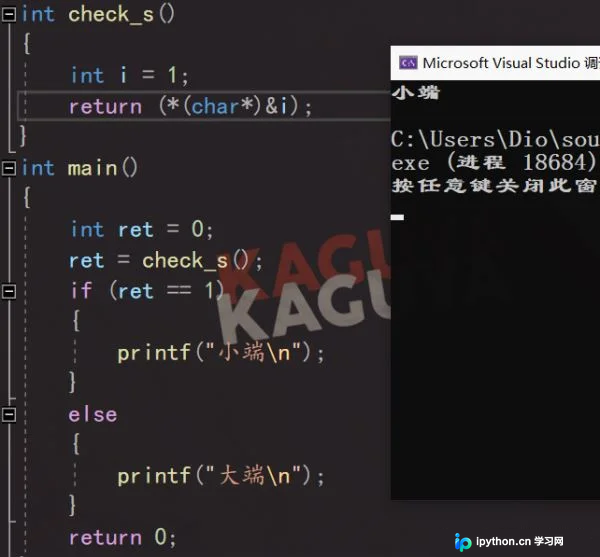
检测大小端的代码实现:
#include <stdio.h>

int check_endianness() {
    int i = 1;
    // 强制转换为 char* 指针,只取第一个字节
    return (*(char*)&i);
}

int main() {
    if (check_endianness() == 1) {
        printf("当前系统为小端模式\n");
    } else {
        printf("当前系统为大端模式\n");
    }
    return 0;
}
上述代码利用联合体或指针类型强转特性,检查地址最低处的字节是否为1。若为1,说明低位在前,即小端模式(大多数现代x86/x64架构均为小端)。
不同类型与整型提升
在打印不同宽度的类型时,常因“整型提升”产生意料之外的结果。整型提升是指表达式求值时,小于 int 宽度的整型值会被提升为 int 或有符号的 unsigned int 类型。
案例演示:
#include <stdio.h>

int main() {
    char a = -1;
    signed char b = -1;
    unsigned char c = -1;

    // -1 的完整补码是全1:11111111 11111111 ... (32个1)
    // char 只有8位,存入时发生截断,仅保留后8位:11111111

    printf("a = %d, b = %d, c = %d", a, b, c);
    return 0;
}
结果分析:
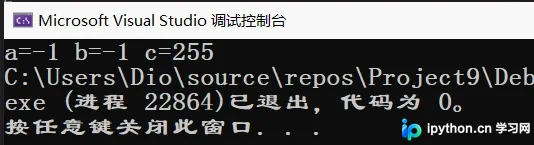
当使用 %d 打印时,会发生整型提升:
a和b(signed char):因为是有符号数,提升时进行符号扩展(高位补1)。提升后的32位全1再次被当作有符号数解码,结果仍为-1。c(unsigned char):因为是 unsigned 数,提升时高位补0。虽然存入的是11111111(255),提升后变为00000000 00000000 00000000 11111111。在使用%d(有符号十进制)打印时,最高位是0,被视为正数,因此结果为255。
无符号数的循环陷阱
理解存储机制有助于避免逻辑错误。以下代码展示了一个常见的死循环陷阱:
#include <stdio.h>
#include <windows.h>

int main() {
    unsigned int i;
    for (i = 9; i >= 0; i--) {
        printf("%u \n", i);
        Sleep(1000);
    }
    return 0;
}
现象与原理:
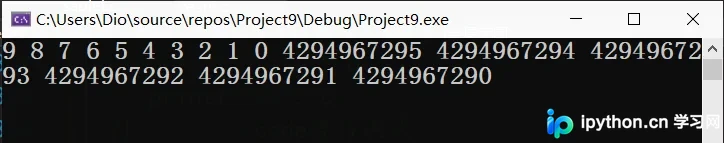
表面上看 i 递减至0会退出循环,但实际上 i 是 unsigned int。当 i 从0减1时,不会变成-1,而是发生溢出,变为最大的无符号整数(全1补码,对应极大正值)。这个巨大的正数显然满足 i >= 0,导致循环无法终止。
浮点数的存储机制 (IEEE 754)
浮点数(float, double)的存储比整型复杂得多。根据国际标准 IEEE 754,任意二进制浮点数 V 可表示为:
V = (-1)S × M × 2E
- S (Sign):符号位,0表示正,1表示负。
- M (Mantissa):有效数字,范围 [1, 2)。
- E (Exponent):指数位。
特殊规定:
- 有效数字 M 的舍入:由于科学计数法中首位必然是1,计算机会默认省略这一位,只存储小数部分。这节省了一位存储空间(32位浮点数实际提供24位有效精度)。
- 指数 E 的偏移量:E 在存储时必须加上一个偏移量。对于32位
float,偏移量为127;对于64位double,偏移量为1023。这使得指数可以为负数也能用无符号整数表示。此外,E 全0和全1有特殊含义(接近0或无穷大)。
经典案例解析:
#include <stdio.h>

int main() {
    int n = 9;
    float* pFloat = (float*)&n;

    printf("n = %d\n", n);            // 打印9
    printf("*pFloat = %f\n", *pFloat); // 打印 0.000000

    *pFloat = 9.0;
    printf("n = %d\n", n);             // 打印 1091567616
    printf("*pFloat = %f\n", *pFloat); // 打印 9.000000

    return 0;
}
步骤拆解:
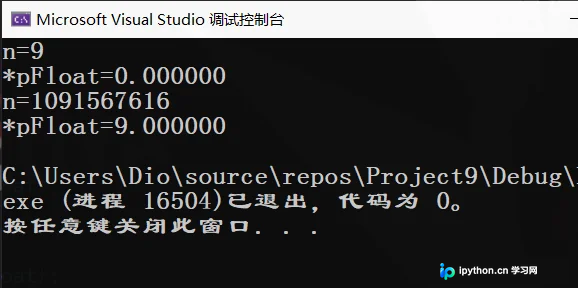
n = 9转为float读取:整数 9 的补码是00000000 00000000 00000000 00001001。
按 IEEE 754 解析:
- S = 0
- E (8位) =00000000(全0)。根据规定,E全0表示指数极小(接近0)。
- M (23位) =000...001001。
组合后的浮点数极小,低于%f默认的小数精度显示下限,故显示为0.000000。*pFloat = 9.0写回int读取:浮点数 9.0 的科学计数法为1.001 × 2³。
- S = 0
- E = 3 + 127 = 130 =10000010
- M = 00100000000000000000000
拼接后的32位二进制为0 10000010 00100000000000000000000,即十六进制0x41100000。
当用%d将其视为整数打印时,转换得到的十进制值为1091567616。
以上就是C语言数据在内存中存储机制的详细内容,更多关于C语言进阶学习的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















