


Go语言中实现MySQL分页查询的正确姿势

在Go语言后端开发中,处理大量数据时通常采用数据库层面的分页策略。本文将演示如何通过RESTful接口接收分页参数,执行COUNT查询获取总数,并利用LIMIT和OFFSET语句在MySQL中截取指定页面的数据,最终返回结构化分页结果。
目标与核心逻辑
实现高效的数据库分页查询主要包含三个步骤:
1. 从请求中提取页码(page)和每页条数(limit)。
2. 执行一条 COUNT 语句查询满足条件的数据总行数。
3. 根据偏移量(offset = (page - 1) * limit)和 limit 执行 SELECT 语句获取当前页数据。
这种模式下,数据库承担筛选和排序工作,避免将全表数据加载到Go内存中进行切片操作(即“内存分页”),从而显著降低服务器内存压力和响应延迟。
准备条件
我们需要一个标准的Go项目结构,通常包含以下层级或组件:
- API Layer: 负责处理HTTP请求和响应。
- Service Layer: 业务逻辑处理,协调Query和DB连接。
- Mapper/DAO Layer: 直接操作数据库执行SQL。
- Query Params: 定义
page和limit的默认值及校验规则。
假设我们使用 restful-go 或类似的库作为Web框架,并直接使用标准库 database/sql 进行数据库交互。
真实操作顺序
第1步:配置路由访问入口
首先需要在API路由中定义GET请求,明确声明分页参数的格式。这有助于前端或调用方了解如何传递分页信息。
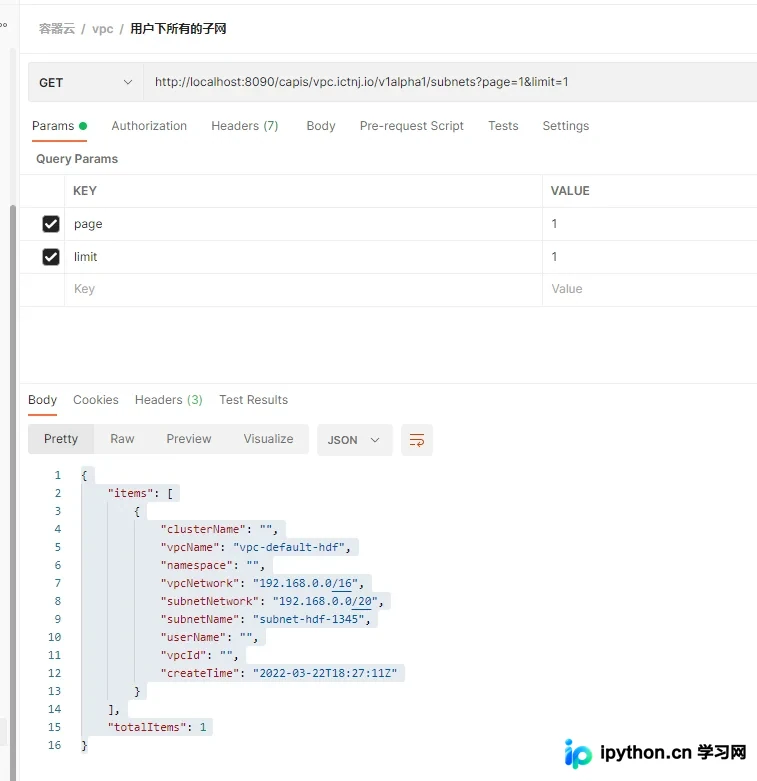
参考代码如下:
// 设置 GET /subnets 路由,支持 page 和 limit 参数
ws.Route(ws.GET("/subnets").
To(sc.ListSubnet).
Doc("List subnets authorized to the login user.").
Param(ws.QueryParameter(query.ParameterPage, "page").Required(false).DataFormat("page=%d").DefaultValue("page=1")).
Param(ws.QueryParameter(query.ParameterLimit, "limit").Required(false)).
Returns(http.StatusOK, api.StatusOK, api.ListResult{}))
第2步:控制器解析请求参数
在Controller层,获取当前登录用户身份,并提取URL中的 query 参数。建议在此处对页码和限制数量做基础校验,防止负数或异常大的数值导致SQL注入风险或性能抖动。
接着,将请求上下文传递给 Service 层。
// 处理 subnet 列表查询请求
func (v *SubController) ListSubnet(request *restful.Request, response *restful.Response) {
    // 1. 获取用户名等身份信息
    username := request.Attribute(filters.UserName).(string)

    // 2. 实例化 Service
    subnetService := &service.SubnetService{}

    // 3. 解析 Page 和 Limit 参数
    query := query.ParseQueryParameter(request)

    // 4. 调用 Service 层执行逻辑
    result, err := subnetService.ListSubnet(query, v.Db, username)
    if err != nil {
        api.HandleError(response, request, err)
        return
    }

    // 5. 写入响应
    response.WriteEntity(result)
}
Service 层编排
Service 层保持简洁,主要负责权限判断和数据流转,不直接编写复杂的 SQL。
// 服务层:委托 Mapper 执行实际查询
func (ss *SubnetService) ListSubnet(query *query.Query, db *sql.DB, userName string) (*api.ListResult, error) {
    sm := mapper.NewSubnetMapper(db)
    // 调用 Mapper 获取分页数据
    sb, err := sm.SearchAllByUserName(query, userName)
    return sb, err
}
Mapper 层实现数据库分页
这是核心逻辑所在。我们需要分别执行“总数查询”和“分页数据查询”。
计算总记录数
使用 COUNT(*) 配合相同的过滤条件(如 username)来获取总条数。注意关闭游标以防止资源泄露。
获取当前页数据
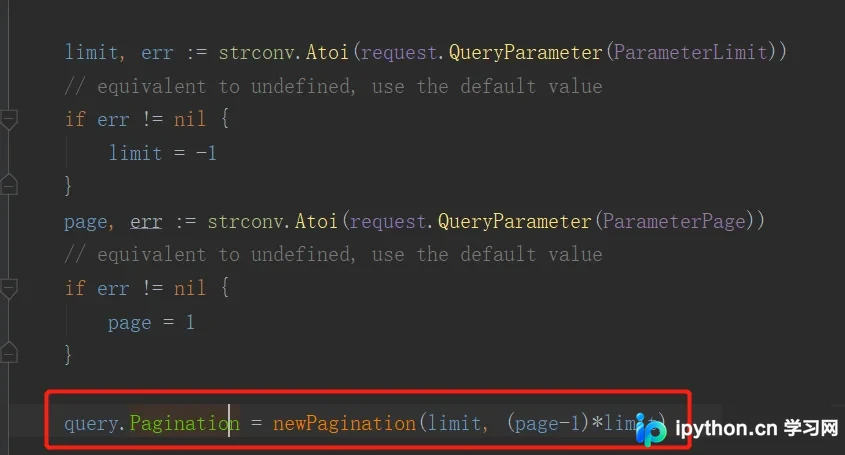
计算 Offset:(page - 1) * limit。执行带有 LIMIT ?, ? 占位符的查询。
// Mapper实现:带总数统计的分页查询
func (s *SubnetMapper) SearchAllByUserName(query *query.Query, userName string) (*api.ListResult, error) {

    // 1. 查询总记录数
    totalRow, err := s.Db.Query("SELECT COUNT(*) from t_subnet ,t_vpc where t_vpc.id = t_subnet.vpcid and username = ?", userName)
    if err != nil {
        klog.Error("query orders count error", err)
        return nil, err
    }

    var total int
    for totalRow.Next() {
        err := totalRow.Scan(&total)
        if err != nil {
            klog.Error("scan count error", err)
            continue
        }
    }
    totalRow.Close()

    // 2. 查询当前页数据 (LIMIT offset, limit)
    // 注意:此处应确保 SearchAllByUserNameSql 包含正确的 WHERE 和 JOIN 条件
    rows, err := s.Db.Query(SearchAllByUserNameSql, userName, query.Pagination.Limit, query.Pagination.Offset)
    defer func() {
        if rows != nil {
            rows.Close()
        }
    }()

    if err != nil {
        klog.Error("query subnet error", err)
        return nil, err
    }

    // 3. 扫描结果集
    items := make([]interface{}, 0)
    for rows.Next() {
        ss := new(vpc.SubnetItem)
        // 确保 Scan 的参数顺序与 SELECT 列的顺序一致
        err = rows.Scan(&ss.VpcName, &ss.VpcNetwork, &ss.SubnetName, &ss.SubnetNetwork, &ss.CreateTime)
        if err != nil {
            klog.Error("scan row error", err)
            break
        }
        items = append(items, *ss)
    }

    // 4. 组装返回结构
    return &api.ListResult{
        TotalItems: total,
        Items:      items,
    }, nil
}
结果验证
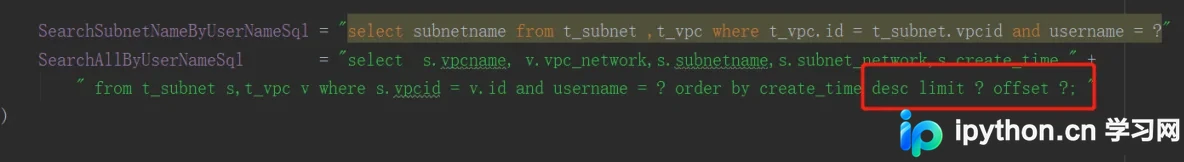
执行上述逻辑后,数据库端会产生两类操作日志,如图所示:
第一步查出了所有count数目(用于计算总页数):
第二步查询语句带上 Limit 和 Offset 参数,控制查到的具体页数范围:
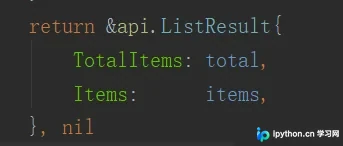
最终 API 会返回包含 totalItems(总条数)和 items(当前页数据列表)的结构体。前端可根据 totalItems 动态生成分页控件。
排错与注意事项
- SQL注入风险: 示例中使用
?` 预编译参数是安全的。切勿将参数拼接进字符串中。 - 深度分页问题: 当
page极大时(例如第10万页),LIMIT 1000000, 10效率极低。若需处理此类场景,应考虑基于索引游标的分页(Cursor-based Pagination),而非传统的 Offset/Limit。 - 空行检查: 务必检查
rows.Scan()后的错误返回。
简要总结
以上就是Golang通过MySQL语句实现分页查询的详细内容。对于小数据量或无需数据库干预的场景,也可采取内存分页方式(查出全部数据后在Go数组中切片),但面对海量数据,推荐上述基于数据库层级的标准做法。更多关于Go语言数据库优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















