


Java 异常处理的真实性能开销分析

在Java开发中,异常机制虽能提升代码整洁度,但其性能影响常被低估。实验表明,频繁抛出异常本身耗时仅约0.02毫秒,但生成堆栈跟踪及处理逻辑可能导致十倍以上的性能损失。合理控制异常使用频率和优化日志记录策略,对提升高并发应用响应速度至关重要。
实验目的与基础结论
在处理客户技术支持时,我们常发现代码中存在未被意识到的异常。消除这些异常后,运行速度显著提升。这引发了一个核心疑问:在代码中使用异常是否带来显著的性能开销?由于异常是错误处理不可或缺的一部分,完全摒弃不现实,因此我们需要量化其影响。
基于一段随机抛出异常的简单代码进行测试,尽管HotSpot编译器的JIT行为使精确测量变得复杂,但该实验足以揭示基本趋势:
- 抛出与捕获的开销: 结果出乎意料地低。每个异常的代价约为 0.02 毫秒。
- 阈值效应: 除非单次操作抛出超过10万次异常,否则这一基础开销几乎可以忽略不计。
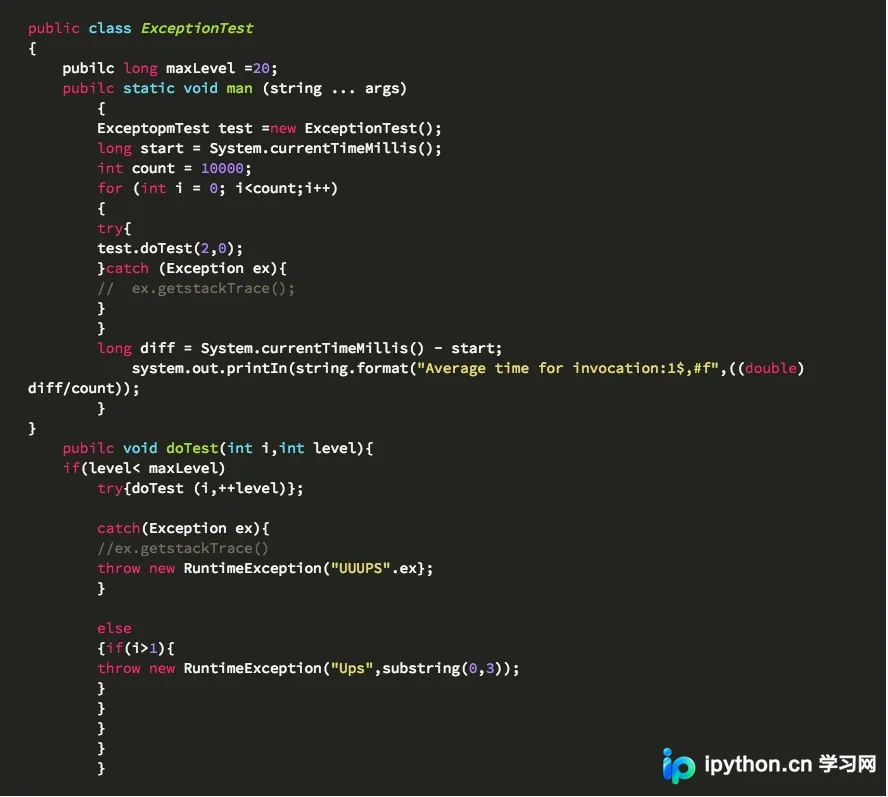
虽然异常处理本身的执行效率很高,但它并非唯一影响性能的因素。真正的问题在于:当异常发生时,程序实际上做了什么?
被忽视的性能瓶颈:补充代码与堆栈跟踪
单纯捕获异常通常伴随着复杂的“补充逻辑”,例如重试网络连接、触发默认回滚方案或进行数据一致性校验。这些操作往往比抛出异常本身慢得多,是导致性能下降的主因之一。
更为关键的是堆栈跟踪(Stack Trace)的生成成本。为便于调试,开发者通常会记录异常详情,而收集栈信息是一个昂贵的操作。
- 生成成本翻倍: 在抛出异常的同时收集 Stack Trace,其性能开销比单纯抛出高出约 10 倍。
- 多次累积效应: 在现代架构中,异常往往经历多层传递(如 Java 库级 → 框架级 → 应用业务逻辑级)。每层都可能涉及异常的重新抛出或包装,导致需要生成多条 Stack Trace。
- I/O 消耗: 将冗长的栈信息写入日志文件或控制台,会进一步放大 I/O 阻塞带来的延迟。
优化建议与最佳实践
既然异常机制本身并非性能毒药,关键在于如何正确使用。以下是具体的优化策略:
第1步:评估异常的使用场景
目的: 防止滥用异常来控制正常的业务流。
操作:
- 仅在真正的异常情况(如输入非法、资源不可用、网络中断)下抛出异常。
- 对于预期的控制流变化,应优先使用条件判断(if-else)而非 try-catch。
第2步:优化日志与监控策略
目的: 平衡可观测性与执行性能。
操作:
- 按需记录栈信息: 不要对所有 catch 块都强制记录完整的 Stack Trace。对于已知的、可恢复的低频异常,可仅记录错误消息。
- 聚合监控: 利用 APM 工具(如 OneAPM 等)在后台异步跟踪异常数量和类型,而不是在同步请求链路上密集输出日志。
- 减少日志级别: 生产环境中,将常规异常的日志级别调低(如从 ERROR 降为 WARN 或 INFO),避免高频写入磁盘。
第3步:精简补充逻辑
目的: 降低异常处理分支的计算复杂度。
操作:
- 避免在 catch 块中进行复杂的计算或深层嵌套的逻辑调用。
- 对于重试机制,采用指数退避算法并结合最大次数限制,防止无效循环占用 CPU 资源。
总结
因噎废食地抛弃异常机制是不可取的,它依然是编写健壮、干净代码的基础。核心在于控制异常的抛出频率以及避免在关键路径上频繁生成堆栈跟踪。通过合理的日志分级和异步监控,可以在保证系统稳定性的同时,最大化运行性能。以上就是Java异常处理性能影响分析的详细内容,更多关于Java优化技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















