


在Python中使用base64模块处理字符编码的详细教程

Base64 是一种将任意二进制数据转换为可打印文本字符串的通用编码方法。在 Python 开发中,借助内置的 base64 模块可以高效完成数据的编解码、URL 安全适配及缺失填充符的自动修复。本文将详细解析其底层原理、核心 API 用法以及常见报错处理方案,确保在实际项目中正确应用于 Cookie、数字证书签名或小段网页数据传输。
Base64 编码原理与 Python 基础操作
Base64 的核心设计是为了解决二进制文件(如 exe、jpg、pdf)在纯文本编辑器中显示乱码的问题。其原理是通过预定义的 64 个字符表,将原始二进制流重新排列组合。
- 每取 3 个字节(共 24 位)作为一组输入。
- 将该组数据切分为 4 个 6 位的片段。
- 每个 6 位片段转为十进制数值,作为索引查找字符表,输出对应的 4 个字符。
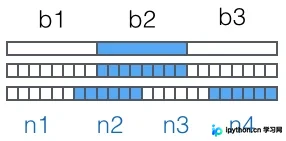
该机制会使数据长度增加约 33%。对于不足 3 字节的剩余数据,Base64 会在末尾补足 \x00 字节,并在编码结果尾部添加 = 号表示补充长度,解码时会自动剥离这些占位符。
Python 标准库提供了开箱即用的编解码工具。在现代 Python 3 环境中,推荐使用 bytes 类型避免字符集混淆:
import base64

# 编码:bytes 转为字符串
encoded_data = base64.b64encode(b'binary\x00string')
print(encoded_data)  # 输出: b'YmluYXJ5AHN0cmluZw=='

# 解码:字符串还原为 bytes
decoded_data = base64.b64decode(b'YmluYXJ5AHN0cmluZw==')
print(decoded_data)  # 输出: b'binary\x00string'
URL 安全编码与特殊字符处理
标准 Base64 编码可能产生 + 和 / 符号,这在 URL 参数或 Cookie 传递时极易引发歧义或被浏览器转义。针对该场景,Python 提供了安全的替代变体:
# 标准编码可能包含 + 和 /
base64.b64encode(b'i\xb7\x1d\xfb\xef\xff')  # 输出: b'abcd++//'

# URL 安全编码将 + 替换为 - ,/ 替换为 _
base64.urlsafe_b64encode(b'i\xb7\x1d\xfb\xef\xff')  # 输出: b'abcd--__'

# 对应安全解码
base64.urlsafe_b64decode(b'abcd--__')  # 恢复原二进制数据
部分前端框架或服务端为了进一步缩短体积,会主动剥离尾部的 = 填充符。由于标准解码器严格依赖 4 的倍数长度,直接传入去填充字符串会抛出 TypeError: Incorrect padding 异常。此时需手动修复格式。
修复解码报错的自定义处理步骤
第1步:计算缺失填充符数量
获取传入字符串的长度,对 4 取模。余数不为 0 时,说明存在被移除的 =。
第2步:拼接补全字符串
根据余数判断需要补多少位,将补齐后的字符串赋值给新变量。
第3步:调用标准解码器执行转换
将补全后的数据传给 b64decode,即可安全返回原始二进制内容。
def safe_b64decode(s):
    import base64
    # 计算并补全缺失的填充符
    s_padded = s + '=' * (4 - len(s) % 4)
    return base64.b64decode(s_padded)

# 验证测试
print(safe_b64decode('YWJjZA'))  # 正常输出: b'abcd'
完成上述逻辑后,业务代码可无缝兼容服务端或前端裁剪过的 Base64 载荷。
使用注意事项与适用场景
许多开发者容易将编码与加密混淆。Base64 本质是查表映射算法,不具备密钥机制,无法抵御逆向分析,因此绝不能用于数据加密或隐私保护。它的核心价值在于保证数据格式的兼容性与可读性。
推荐将其用于以下轻量级场景:
- 邮件附件或正文中的小型二进制块传输
- HTTP Cookie 或 URL 查询参数中的 Token 携带
- 数字证书指纹或签名的文本化存储
处理大文件时建议分块读取与编码,避免内存占用过高。
以上就是在Python中使用base64模块处理字符编码的详细内容,更多关于Python数据编码与网络数据传输的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















