


Python web.py 框架 URL 路由与参数传递实战

本文详细演示 Python web.py 框架中 URL 路由规则的编写逻辑,包含通过查询字符串安全获取参数、利用正则路径直接传参的方法,以及如何接收 POST 原始数据并使用 lxml 解析 XML 报文。配合代码实例与运行结果对照,帮助开发者快速理解该框架的请求处理机制。
GET 请求参数传递与路由配置
web.py 框架采用元组结构管理 URL 路由映射。在 GET 请求中,参数通常通过 URL 查询字符串(如 ?name=xx&age=yy)附加于地址之后。框架支持两种方式处理这些参数:一是通过 web.input() 统一捕获;二是直接在路由规则中使用正则提取并传入处理器方法。
第1步:使用 web.input() 获取查询参数
此方法适合参数位置不固定或需要默认值的场景。首先在路由配置中指向对应的类:
urls = (
  '/', 'index',
  '/weixin/(.*)?', 'WeixinInterface'
)
在 index 类的 GET 方法中调用 web.input()。建议显式声明键名并提供默认值,避免未传递参数时引发 KeyError:
class index:
  def GET(self):
    i = web.input(name='kevinkelin', age=100)
    return render.index(i.name, i.age)
配合模板文件(语法使用 $def with 和 $if):
$def with(name, age)
$if name:
  I just want to say hello to $name, he is $age years old
$else:
  hello, world!
当访问 http://127.0.0.1:8080/ 时,由于未传参,程序自动应用默认值输出:
I just want to say hello to kevinkelin, he is 100 years old
若追加查询参数(如 ?name=yyx&age=26),则覆盖默认值:
I just want to say hello to yyx, he is 26 years old
若将参数设为 None:i = web.input(name=None, age=None),未传参时将进入模板的 $else 分支。完全省略参数名(i = web.input())并在后续引用 i.name 会导致异常,需提前防范。
第2步:通过正则路径提取参数
若希望参数直接出现在路径中而非查询字符串后,可修改路由正则:
urls = (
  '/name=(.*)&age=(.*)', 'index',
  '/weixin/(.*)?', 'WeixinInterface'
)
此时需在类方法中接收匹配的分组变量:
class index:
  def GET(self, name, age):
    return render.index(name, age)
访问 http://127.0.0.1:8080/name=yyx&age=26 即可得到相同渲染结果。该方法省去了 web.input() 步骤,但正则表达式编写复杂度较高,且路径一旦变化容易导致 404,在实际项目中需谨慎评估路由规范。
POST 请求数据处理与解析
对于表单提交或外部接口回调,通常使用 POST 方法。web.py 通过 web.data() 读取原始请求体:
def POST(self):
    data = web.data()
    return data
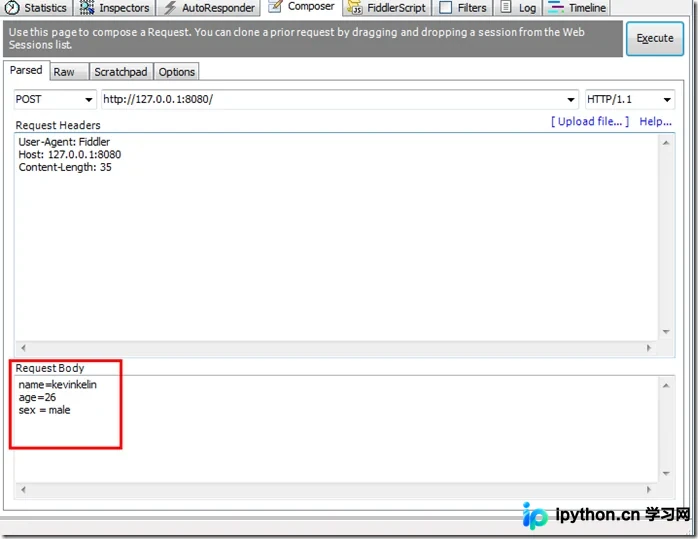
返回值类型为字符串(或字节流)。以接收标准 XML 报文为例,可通过第三方库进行结构化解析:
<xml>
<ToUserName>yanxingyang</ToUserName>
<FromUserName>study_python</FromUserName>
<CreateTime>123456</CreateTime>
<MsgType>text</MsgType>
<Content>Just a test</Content>
</xml>
第3步:使用 lxml 解析 XML 报文
引入 lxml 库可高效提取节点文本:
from lxml import etree

data = web.data()
xml_root = etree.fromstring(data)
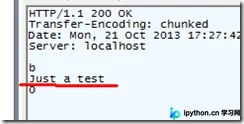
content_text = xml_root.find('Content').text
return content_text
调试与注意事项
- 路由匹配顺序遵循从上至下原则,第一个匹配成功的规则将被执行,后续规则失效。
web.input()是线程安全的局部上下文对象,切勿将其定义为全局变量。- POST 端点默认关闭 CSRF 保护,对外部不可信来源的回调接口务必做好签名验证。
总结
以上内容整理了 web.py 框架中 URL 路由配置与参数处理的完整逻辑。通过区分 GET 查询传参与 POST 原始数据读取,结合正则路径提取与 XML 解析工具,能够覆盖大多数传统 Web 应用的请求处理需求。以上就是 Python web.py 框架 URL 设置与请求参数处理的详细内容,更多关于 Python Web 开发基础实践的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















