


Python基础语法选择题题库:自测掌握程度

发布时间:2026-10-10 |
5人浏览过
检验Python基础语法的真实掌握程度,最好的方式不是盲目刷代码,而是看自己是否能看透代码执行背后的底层机制。本文整理了一套贴合实际开发陷阱的基础语法自测试卷,分为变量类型、容器切片、函数执行、控制流与作用域四大核心模块。每道题均附带输出推导与机理解析,帮助你准确定位知识漏洞。
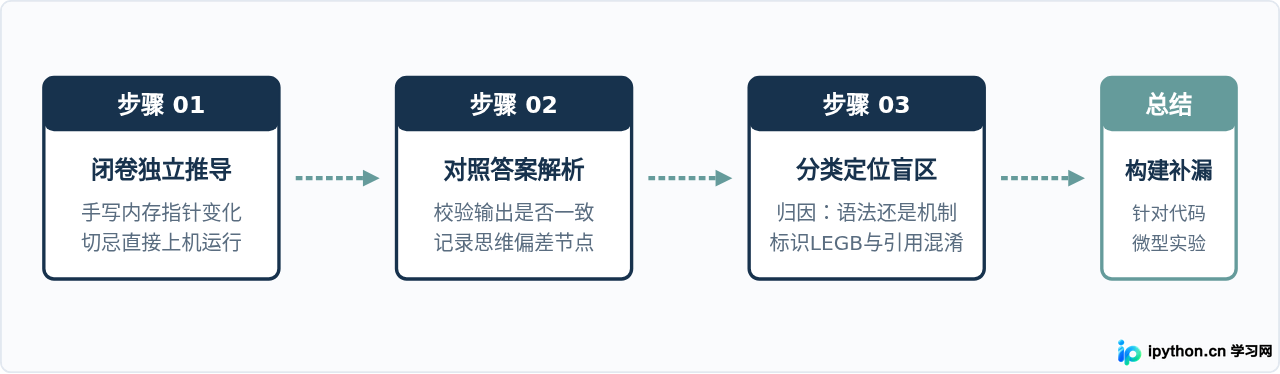
图 1:四步闭环自测操作规范
第一单元:变量引用与可变性
Python中“变量是对象的标签,而不是盒子”。理解不可变对象(int、str、tuple)与可变对象(list、dict、set)的引用行为,是避免代码产生意外副作用的基础。
题目 1:不可变对象与原处修改
执行以下代码段,打印的结果是:
x = 256
y = x
x += 1
print(y)- A. 257
- B. 256
- C. 抛出
UnboundLocalError异常 - D.
None
正确答案:B
解析:整型(
解析:整型(
int)是不可变数据类型。执行 y = x 时,变量 y 与 x 绑定到同一个内存地址;当执行 x += 1 时,Python会创建新的整型对象 257 并将 x 重新绑定到该对象,而 y 仍然指向原有的 256。
题目 2:浅拷贝与嵌套列表乘法
执行以下代码段后,列表 matrix 的最终值为:
matrix = [[0] * 2] * 2
matrix[0][0] = 1
print(matrix)- A.
[[1, 0], [0, 0]] - B.
[[1, 1], [0, 0]] - C.
[[1, 0], [1, 0]] - D.
[[1, 1], [1, 1]]
正确答案:C
解析:乘法运算符
解析:乘法运算符
* 2 对包含可变对象的列表执行的是浅复制(引用拷贝)。外层列表的两个元素实际上指向内存中完全相同的子列表 [0, 0]。因此修改 matrix[0][0] 实际上就是修改了共享子列表的首个元素。
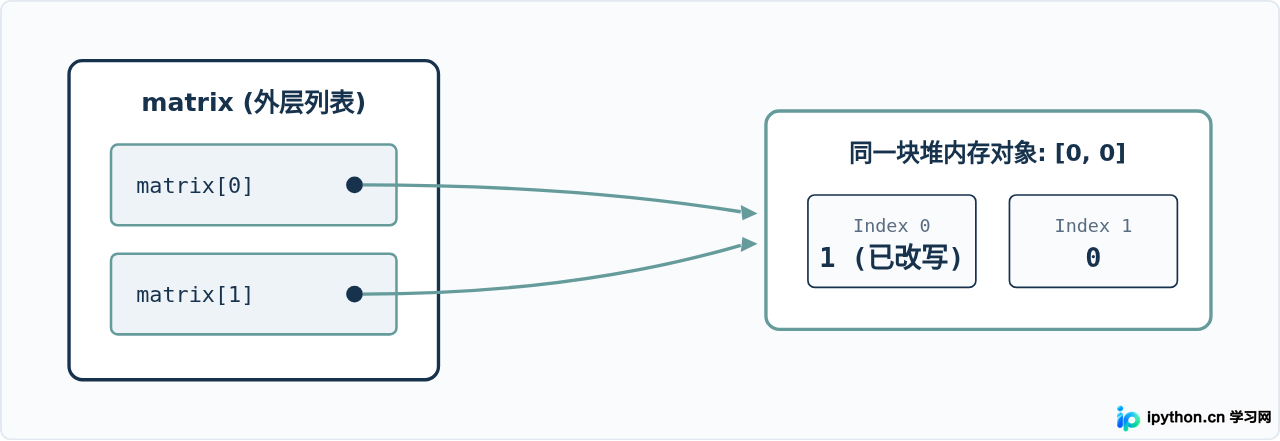
图 2:列表浅复制时的引用共享拓扑图
第二单元:容器操作与切片边界
序列的切片遵循“左闭右开”规则,而负步长切片更是基础测试中的高频失分点。此外,字典推导式与键值对更新规则也是必考内容。
题目 3:负步长切片索引
执行下列代码,终端打印出的字符串是:
s = "abcdef"
print(s[4:1:-1])- A.
"edcb" - B.
"edc" - C.
"fedc" - D.
"fedcb"
正确答案:B
解析:切片语法为
解析:切片语法为
[start:stop:step]。当步长 step = -1 时,切片从右向左移动。起始索引 4 对应字符 'e',终止索引 1 对应字符 'b'。因为终止边界不包含在内,所以实际提取的索引为 4, 3, 2,对应的字符依次为 'e', 'd', 'c'。
题目 4:字典键的唯一性与覆盖机制
下列代码执行后,len(data) 的结果是:
data = {True: "yes", 1: "one", 1.0: "unit"}
print(len(data))- A. 3
- B. 2
- C. 1
- D. 抛出
TypeError
正确答案:C
解析:在Python中,字典判断键是否相同依据两个条件:
解析:在Python中,字典判断键是否相同依据两个条件:
hash(key1) == hash(key2) 且 key1 == key2。在内置机制中,True == 1 == 1.0 完全成立,且它们的哈希值均等于 1。因此这三个赋值语句操作的是同一个键,后面的值覆盖前面的值,最终字典只包含一个键值对。
第三单元:函数参数与作用域解析(LEGB)
函数的默认参数在定义期进行求值,而不是在调用期求值。这一点结合全局与局部变量查找,是区分及格与进阶开发者的关键分水岭。
题目 5:可变对象作为函数默认参数
执行以下代码,输出的内容是:
def append_item(val, target=[]):
    target.append(val)
    return target

print(append_item(1))
print(append_item(2))- A.
[1]换行[2] - B.
[1]换行[1, 2] - C.
[1, 2]换行[1, 2] - D. 抛出
RuntimeError
正确答案:B
解析:函数的默认参数仅在
解析:函数的默认参数仅在
def 语句定义函数时被评估一次。由于 target 默认值绑定的是一个空列表(可变对象),每次不传实参调用该函数时,都会操作保存在函数对象内部的同一个列表引用。
题目 6:局部作用域重影(UnboundLocalError)
执行以下代码段会发生什么:
count = 10

def update():
    print(count)
    count = 20

update()- A. 打印 10,并将外部的
count修改为 20 - B. 打印 10,然后报错
SyntaxError - C. 直接抛出
UnboundLocalError异常 - D. 打印 20
正确答案:C
解析:Python在编译函数代码块时,一旦发现函数内部有针对
解析:Python在编译函数代码块时,一旦发现函数内部有针对
count 的赋值语句(count = 20),就会将 count 判定为局部变量。因此在第一句 print(count) 执行时,解释器试图在局部空间读取该变量,但此时它尚未赋值,因此触发 UnboundLocalError: local variable 'count' referenced before assignment。
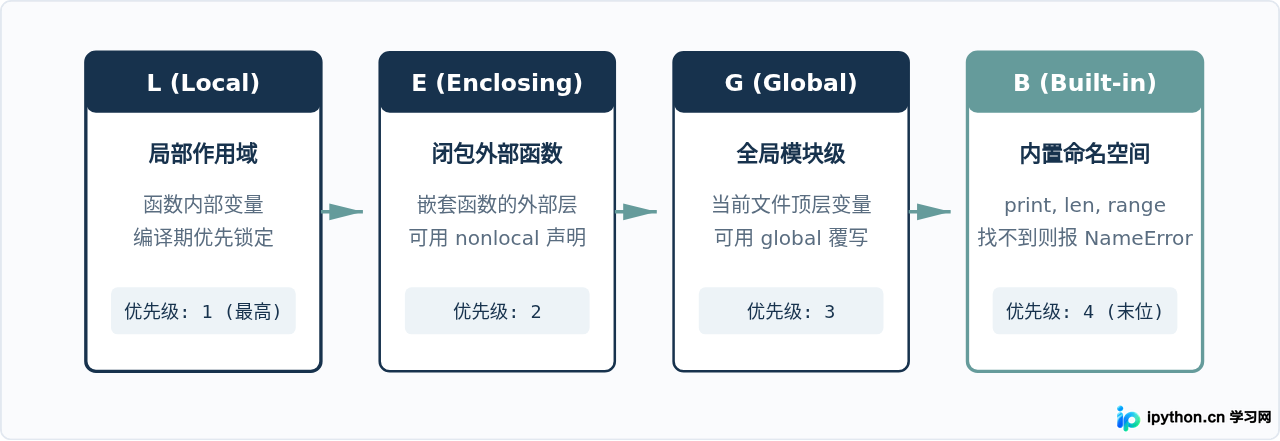
图 3:Python LEGB 作用域检索层级对比
第四单元:控制流机制与异常拦截
异常处理和循环语句中的 else 子句是Python语法中极具特色的一部分,也是日常编写健壮代码不可缺少的一环。
题目 7:循环中的 else 触发条件
执行以下代码,终端输出的结果是:
for num in range(2, 5):
    if num % 2 == 0:
        continue
else:
print("Loop Completed")- A. 没有输出
- B. 输出
Loop Completed - C. 抛出
SyntaxError - D. 报错
IndentationError
正确答案:B
解析:在Python中,
解析:在Python中,
for...else 结构的设计规则是:只有当循环正常迭代结束,且没有遇到 break 中断时,才会执行 else 块。代码中使用的关键字是 continue,并没有触发 break,因此循环迭代完 range(2, 5) 后进入 else 分支并打印信息。
题目 8:异常捕获机制与 finally 的返回值覆写
执行以下函数,返回值是什么:
def demo():
    try:
        return 1
    finally:
        return 2

res = demo()
print(res)- A. 1
- B. 2
- C.
None - D. 1 换行 2
正确答案:B
解析:无论
解析:无论
try 块内是否遇到 return 语句,finally 块中的代码都保证会被执行。如果 finally 内部也明确包含了 return 语句,它会压制并丢弃 try 块原本准备返回的值,直接以 finally 中的返回值作为整个函数的最终输出。
掌握程度评估与查漏补缺建议
完成上述8道经典自测题目后,可以对照以下诊断矩阵对自己的薄弱点进行归因分析与定向复盘:
| 得分区间 | 水平评估 | 核心薄弱点与复习抓手 |
|---|---|---|
| 7 - 8 题正确 | 扎实掌握 | 对底层执行模型、作用域与内存引用机制理解清晰,可以平稳过渡到面向对象进阶(魔法方法、元类)与并发编程。 |
| 4 - 6 题正确 | 初窥门径 | 能够写出常用功能,但对“默认参数生命周期”、“可变性浅拷贝”和“作用域编译机制”存在概念模糊,容易在生产环境写出不易复现的Bug。 |
| 0 - 3 题正确 | 基础悬空 | 缺乏对Python对象模型的整体认知,往往用直觉替代语法规则。建议重新梳理数据类型体系及LEGB规则。 |
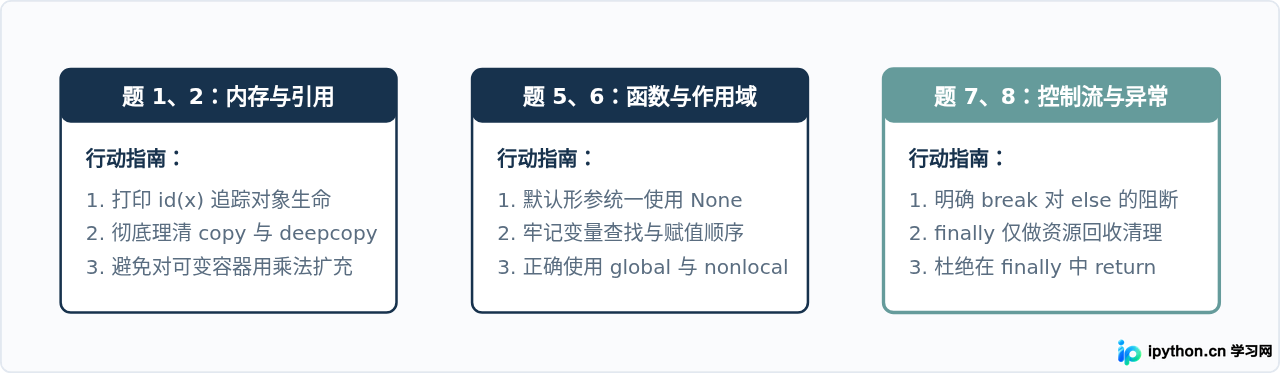
图 4:基础语法错题归因与专项突破路径
建议将本次做错的题目抽离出来,在本地终端通过简单的 id() 检查或单步调试模式,亲眼观察一次变量与内存引用的变更过程。这种刻意练习能够快速消除认知死角,建立稳固的Python编程直觉。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















