


深入解析Linux网络IO模型:阻塞、非阻塞、多路复用与异步

本文详细解析Linux环境下的五种网络IO模型,重点对比阻塞、非阻塞、IO多路复用(select/epoll)及异步IO的执行流程。通过剖析等待数据与拷贝数据两个阶段,阐明各模型在进程阻塞状态、系统调用次数及适用场景上的核心差异,帮助开发者根据连接数与性能需求选择合适的IO处理方式。
一、I/O模型
IO在计算机领域代表Input/Output(输入/输出)。由于程序代码及运行时数据均驻留在内存中,由CPU这一高速计算核心执行,因此涉及数据交换的场景(如磁盘读写、网络通信)必须通过IO接口进行。
同步(synchronous)IO与异步(asynchronous)IO,以及阻塞(blocking)IO与非阻塞(non-blocking)IO的具体定义及其区别是什么?
对此问题的回答因知识背景而异。例如,Wiki认为asynchronous IO与non-blocking IO是同一概念。这种差异源于讨论时的上下文(context)不同。因此,本文限定讨论背景为Linux环境下的network IO。
Stevens在相关文献中比较了五种IO Model:
blocking IO(阻塞IO)
nonblocking IO (非阻塞IO)
IO multiplexing (IO多路复用)
asynchronous IO (异步IO)
signal driven IO (信号驱动IO)
由于signal driven IO在实际应用中并不常用,本文仅讨论剩余的四种IO Model。
接下来阐述IO发生时涉及的对象及步骤。
以network IO中的read操作为例,它涉及两个系统对象:发起IO调用的process(或thread)以及系统内核(kernel)。当一个read操作发生时,需经历两个阶段:
等待数据准备 (Waiting for the data to be ready) 将数据从内核拷贝到进程中 (Copying the data from the kernel to the process) 理解这两点至关重要,因为各IO Model的区别正体现在这两个阶段的不同处理上。
二、 blocking IO
在Linux中,默认情况下所有socket均为blocking模式。一个典型的读操作流程如下:
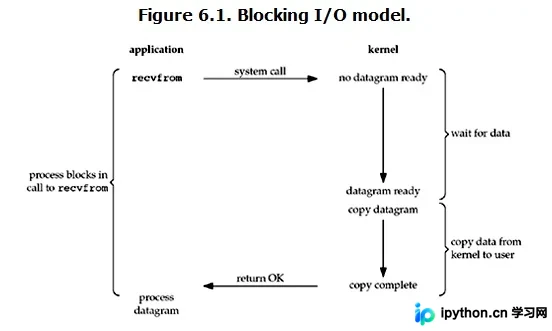
当用户进程调用recvfrom系统调用时,内核开始IO的第一阶段:准备数据。对于network IO,若数据尚未到达(例如未收到完整UDP包),内核需等待足够数据。在此期间,用户进程被完全阻塞。一旦内核数据准备就绪,便将数据从内核拷贝至用户内存,随后内核返回结果,用户进程解除block状态并继续运行。
因此,blocking IO的特点在于IO执行的两个阶段(等待数据与拷贝数据)中,进程均处于被阻塞状态。
三、non-blocking IO
在Linux下,可通过设置socket使其变为non-blocking。对non-blocking socket执行读操作的流程如下:
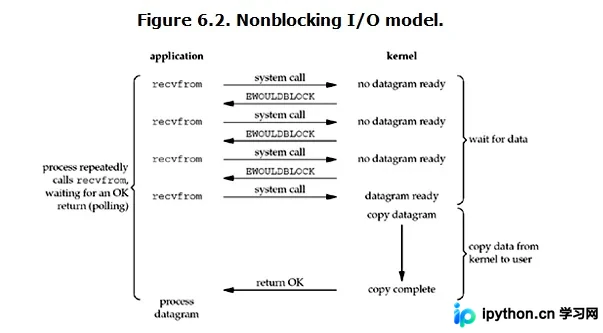
从流程图中可见,当用户进程发起read操作时,若内核数据未准备好,内核不会阻塞用户进程,而是立即返回error。对用户进程而言,发起read后无需等待,即刻获得结果。若结果为error,用户进程知晓数据未就绪,可再次发送read操作。一旦内核数据准备好且再次收到用户进程的system call,内核立即将数据拷贝至用户内存并返回。因此,用户进程需不断主动询问内核数据是否就绪。
注意:
在网络IO中,非阻塞IO同样进行recvfrom系统调用以检查数据状态。与阻塞IO不同,“非阻塞将大的整片时间的阻塞分成N多小的阻塞”,使得进程有机会频繁被CPU调度。即每次recvfrom调用间,CPU权限仍归进程所有,进程可执行其他任务。若数据未准备好,内核立即返回error。进程返回后可执行其他操作,随后再次发起recvfrom系统调用。此循环往复的过程称为轮询。通过轮询检查内核数据,直至数据就绪再拷贝至进程进行数据处理。需注意,在拷贝数据的全过程中,进程仍处于阻塞状态。
import time
import socket

sk = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sk.bind(('127.0.0.1', 8080))
sk.listen(5)
sk.setblocking(False)  #设置套接字为非阻塞模式
while True:
  try:
    print('waiting client connection .......')
    connection, address = sk.accept() # 进程主动轮询
    print("+++", address)
    client_messge = connection.recv(1024)
    print(str(client_messge, 'utf8'))
    connection.close()
  except Exception as e:
    print(e)
    time.sleep(4)

#############################client

import time
import socket
sk = socket.socket(socket.AF_INET,socket.SOCK_STREAM)

while True:
  sk.connect(('127.0.0.1', 8080))
  print("hello")
  sk.sendall(bytes("hello", "utf8"))
  time.sleep(2)
  break
上述实例中,服务端每隔4秒轮询一次。若无客户端连接,则抛出错误信息并继续轮询。
非阻塞IO:
优点:能够在等待任务完成期间执行其他任务(包括提交其他任务,即“后台”可同时执行多个任务)。
缺点:任务完成的响应延迟增加,因为仅每隔一段时间轮询一次read操作。任务可能在两次轮询间的任意时刻完成,导致无法实时获取数据,进而降低整体数据吞吐量。
四、IO multiplexing
IO multiplexing一词可能略显陌生,部分地区也称此IO方式为event driven IO。select/epoll的优势在于单个process可同时处理多个网络连接的IO。其基本原理是select/epoll函数不断轮询所有负责的socket,当任一socket有数据到达时,便通知用户进程。其流程如图:
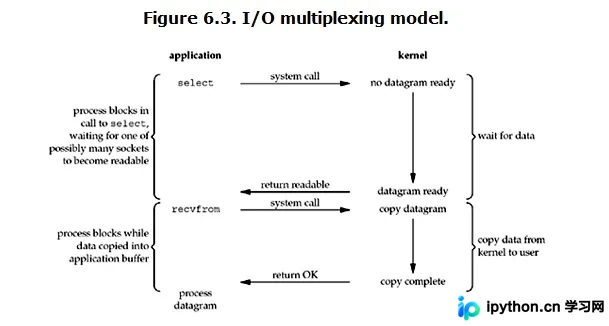
当用户进程调用select时,整个进程会被block。同时,kernel“监视”所有select负责的socket,当任一socket数据准备好,select即返回。此时用户进程再调用read操作,将数据从kernel拷贝至用户进程。
此图与blocking IO图差异不大,事实上甚至更差,因为此处需使用两个system call(select和recvfrom),而blocking IO仅调用一个system call(recvfrom)。然而,select的优势在于能同时处理多个connection。(补充说明:若处理的连接数不高,使用select/epoll的web server性能未必优于multi-threading + blocking IO的web server,甚至延迟可能更大。select/epoll的优势并非处理单个连接更快,而是能处理更多连接。)
在IO multiplexing Model中,实际应用中,每个socket通常设置为non-blocking。但如上图所示,整个用户process实际上一直处于block状态,只不过是被select函数block,而非被socket IO直接block。
注意:
1.若select函数返回结果中包含可读文件,进程可通过调用accept()或recv()让kernel将内核中已准备好的数据copy到用户区。
2.select的优势在于可处理多个连接,但不适用于单个连接场景。
import select, socket

sock = socket.socket()
sock.bind(('127.0.0.1', 8080))
sock.listen(5)

sock.setblocking(False)
listen_obj = [sock, ]

while True:
  r, w, e = select.select(listen_obj, [], [])

  for obj in r:
    if obj == sock:
      conn, addr = obj.accept()
      print('conn', conn)
      print('addr', addr)
      listen_obj.append(conn)
    else:
      data = obj.recv(1024)
      print(data.decode('utf8'))
      send_data = input('>>>')
      obj.send(send_data.encode('utf8'))

#############################client


import socket

sock = socket.socket()
sock.connect(('127.0.0.1', 8080))


while True:
  data = input('>>>')
  sock.send(data.encode('utf8'))
  recv_data = sock.recv(1024)
  print(recv_data.decode('utf8'))
sock.close()
上述实例中,服务端kernel监听select负责的listen_obj中的所有socket对象。当任一socket对象被激活,系统根据其类型判断是否建立通信。
五、asynchronous I/O
Linux下的asynchronous IO实际应用较少。先观察其流程:
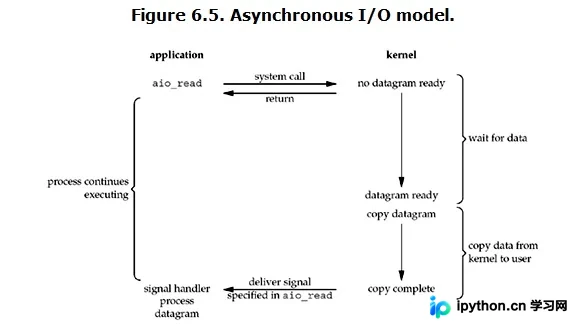
用户进程发起read操作后,可立即执行其他任务。从kernel角度看,收到asynchronous read请求后,首先立即返回,因此不会对用户进程产生任何block。随后,kernel等待数据准备完成,将数据拷贝至用户内存。全部完成后,kernel向用户进程发送signal,告知read操作已完成。
显然,使用异步IO编写的程序性能远高于同步IO,但其缺点是编程模型复杂。
A synchronous I/O operation causes the requesting process to be blocked until that I/O operation completes;
An asynchronous I/O operation does not cause the requesting process to be blocked;
两者的区别在于synchronous IO在执行”IO operation”时会阻塞process。按此定义,前述的blocking IO、non-blocking IO、IO multiplexing均属于synchronous IO。有人可能质疑:non-blocking IO并未被block。此处存在一个“狡猾”的定义点:所指的”IO operation”是指真实IO操作,即例子中的recvfrom system call。non-blocking IO在执行recvfrom时,若kernel数据未准备好,不会阻塞进程;但当kernel数据准备好时,recvfrom将数据从kernel拷贝至用户内存,此时进程被block。而在asynchronous IO中,进程发起IO操作后直接返回,不再关注后续,直到kernel发送信号告知IO完成。在此全过程中,进程完全未被block。
各IO Model的比较如图所示:
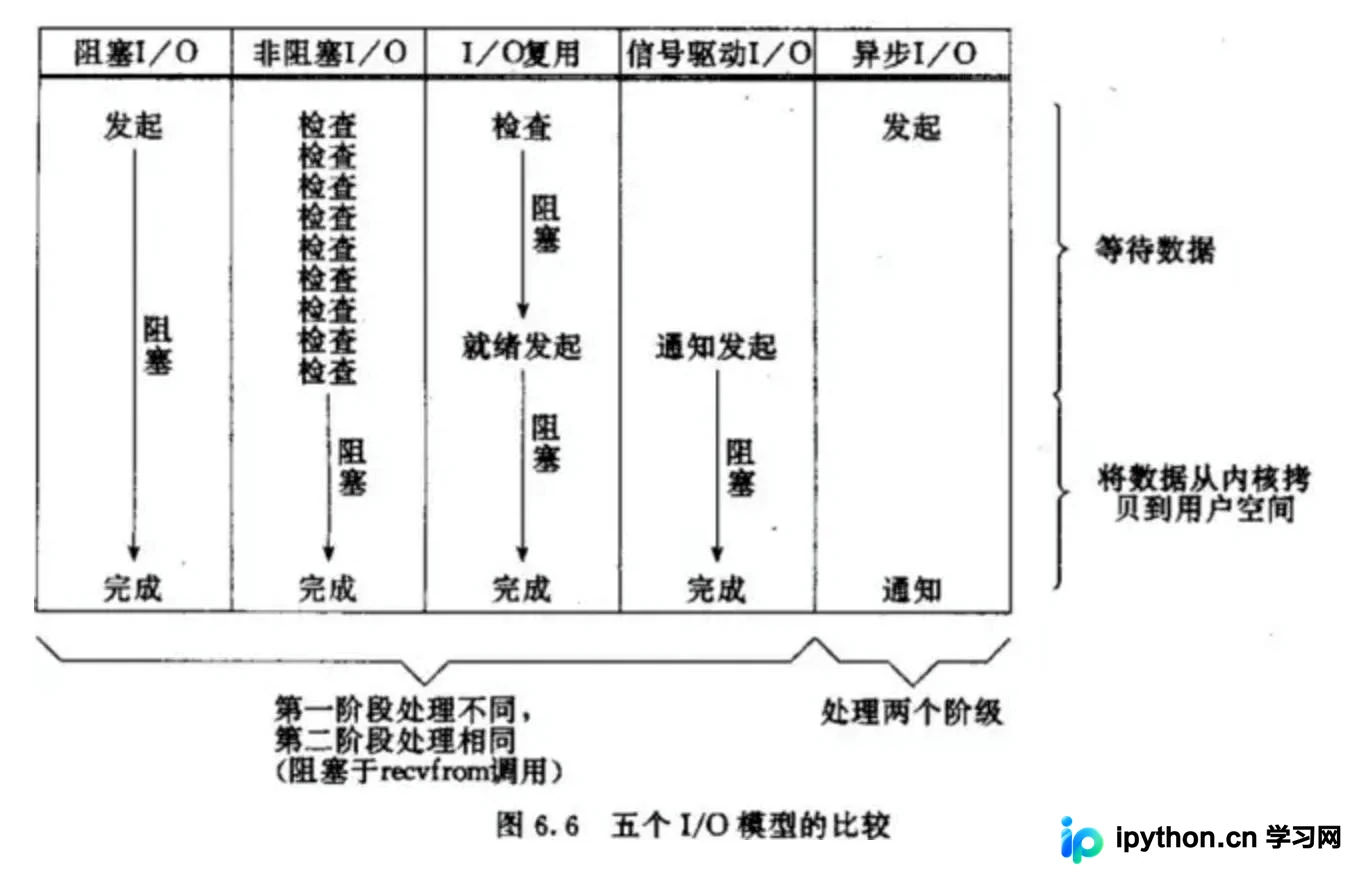
经上述介绍,non-blocking IO与asynchronous IO的区别显而易见。在non-blocking IO中,尽管进程大部分时间未被block,但仍需进程主动check,且数据准备完成后,需进程再次主动调用recvfrom将数据拷贝至用户内存。而asynchronous IO则完全不同。它如同用户进程将整个IO操作委托给kernel(他人),完成后由kernel发送信号通知。在此期间,用户进程无需检查IO状态,也无需主动拷贝数据。
以上关于Python基础之I/O模型的浅谈内容即为小编分享给大家的全部信息,希望能对大家有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















