


Python使用httplib下载网页源码的示例

发布时间:2026-10-13 |
3人浏览过
本文提供使用Python标准库httplib模块发起GET请求并获取网页源码的完整代码示例。通过连接指定域名、发送请求、读取响应数据并打印结果,展示了基础的HTTP交互流程,适用于Python初学者理解网络请求实现。
本文介绍一个使用Python编写的下载网页源码的示例程序,供读者参考学习。
#!/usr/bin/python
import httplib
httpconn = httplib.HTTPConnection("www.baidu.com")
httpconn.request("GET", "/index.html")
resp = httpconn.getresponse()
if resp.reason == "OK":
  resp_data = resp.read()
  print resp_data
  print len(resp_data)
httpconn.close()
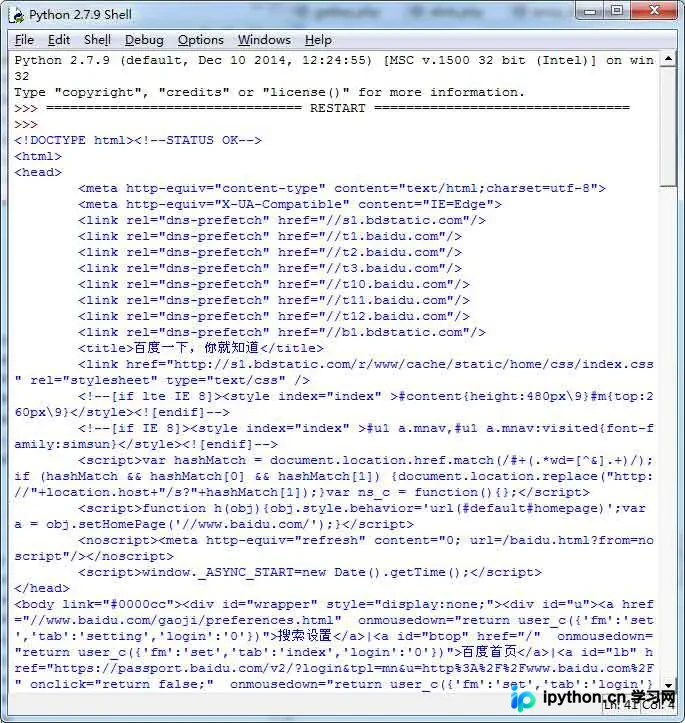
执行代码后,获取到的网页源码内容会被存储到变量resp_data中。
程序运行的实际效果如下图所示:
如需了解更多Python相关知识,建议查阅本站的相关专题,包括《Python进程与线程操作技巧总结》、《Python Socket编程技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望上述内容能对您的Python编程实践提供帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















