



很多 Python 爬虫还在沿用 cloudscraper 这类“开箱即用”的老方案,但在新版 Cloudflare 防护面前,常见结果已经变成了 403、503,或者不断跳转到 /cdn-cgi/challenge-platform/。这篇文章不再停留在“参数怎么调”的层面,而是直接拆开当前失败的根因、哪些做法其实无效,以及为什么真正可行的路线只剩下复用真实 Chromium 实例。
为什么 cloudscraper 现在经常失效
cloudscraper 在防护强度不高的网站上,确实还可能正常工作;但只要碰上当前主流的 Cloudflare 配置,尤其是开启了 I'm Under Attack 模式,或者站点接入新版 Turnstile,成功率就会明显下降。根本原因不是请求格式写错,而是它所依赖的执行环境已经跟不上 Cloudflare 挑战逻辑的复杂度。
新版挑战不只是“执行一段 JavaScript”这么简单,往往还会涉及:
WebAssembly.instantiate()调用Date.now()与performance.now()的时间差校验- 动态创建
Worker线程 navigator.webdriver、canvas等关键指纹检查
而 cloudscraper 底层依赖的是 execjs + Node.js 来执行 JS,这意味着它很难完整模拟浏览器的运行时环境,也无法把这些指纹特征伪装到足够接近真实 Chrome 的程度。一旦挑战执行失败,Cloudflare 通常就会直接拦截,或者把请求打回挑战页面。
为什么会一直卡在 /cdn-cgi/challenge-platform/
很多人看到 /cdn-cgi/challenge-platform/ 会误以为请求根本没有发出去。实际情况通常相反:请求已经到达站点,但 Cloudflare 的 JS challenge 没有在客户端环境中顺利执行,于是触发了 fallback 重定向。
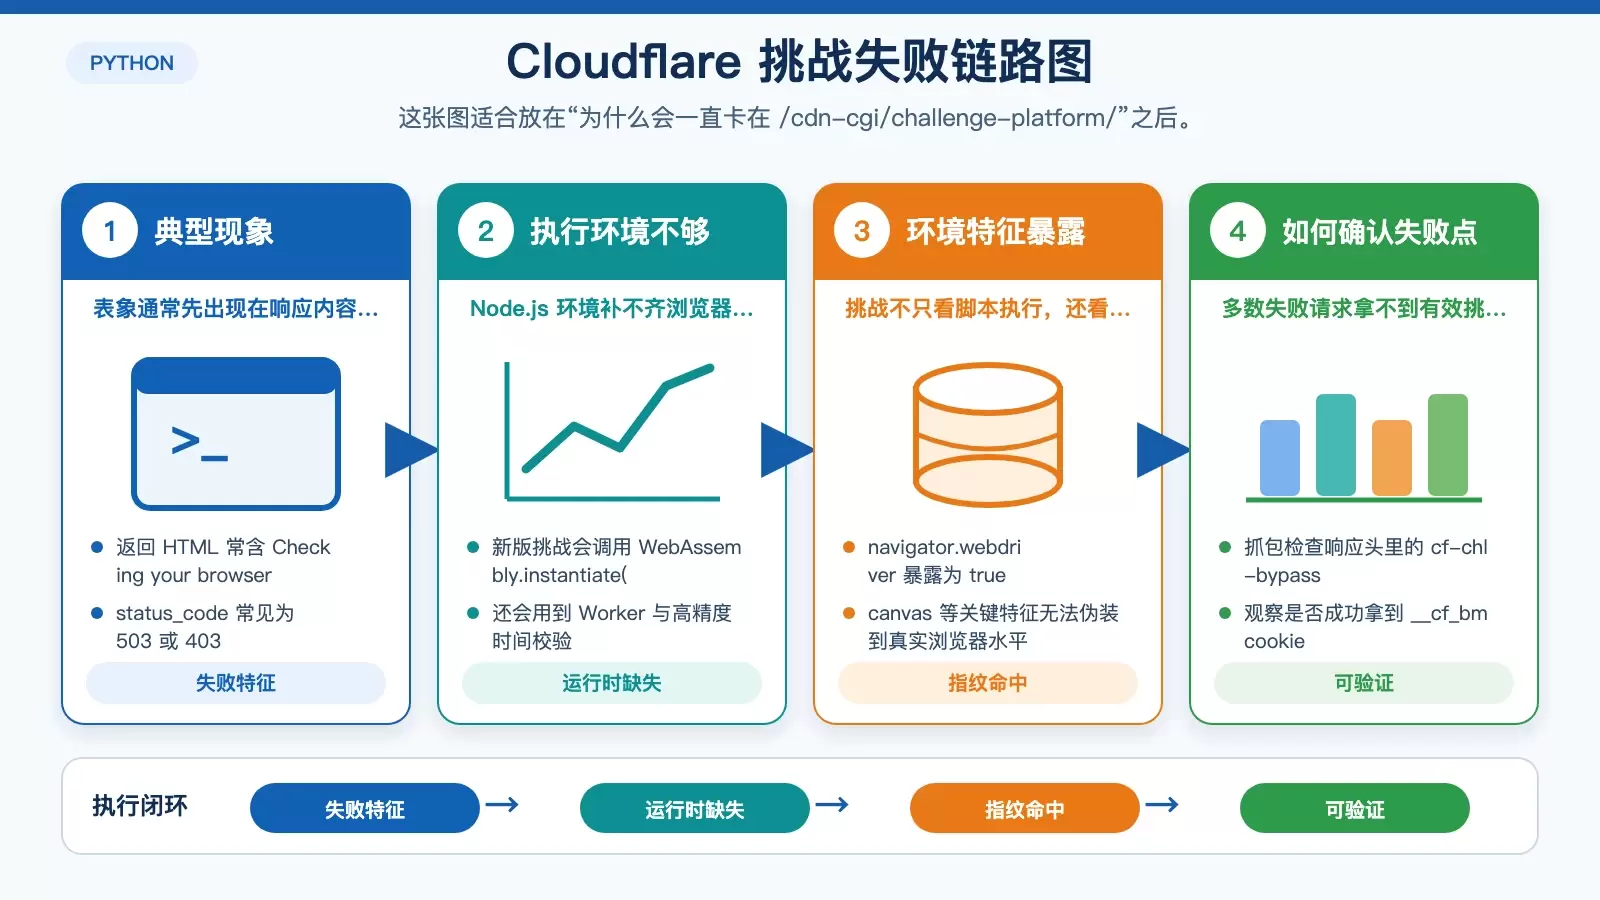
这类场景常见的表象包括:
- 返回 HTML 中包含
Checking your browser before accessing status_code常见为503或403- 挑战脚本执行中途报错,例如
ReferenceError: WebAssembly is not defined
进一步看,真正失败的点主要有两类。一类是运行时能力缺失,例如缺少 WebAssembly、Worker 或高精度时序行为;另一类是环境指纹暴露,例如 navigator.webdriver 始终为 true,这在现代 Cloudflare 规则下几乎就是明确的自动化标记。
验证方式也很直接:抓包观察响应头里是否出现有效的 cf-chl-bypass,或者是否成功拿到 __cf_bm cookie。多数失败的 cloudscraper 请求,通常拿不到这些关键值。
为什么常见参数调优基本没用
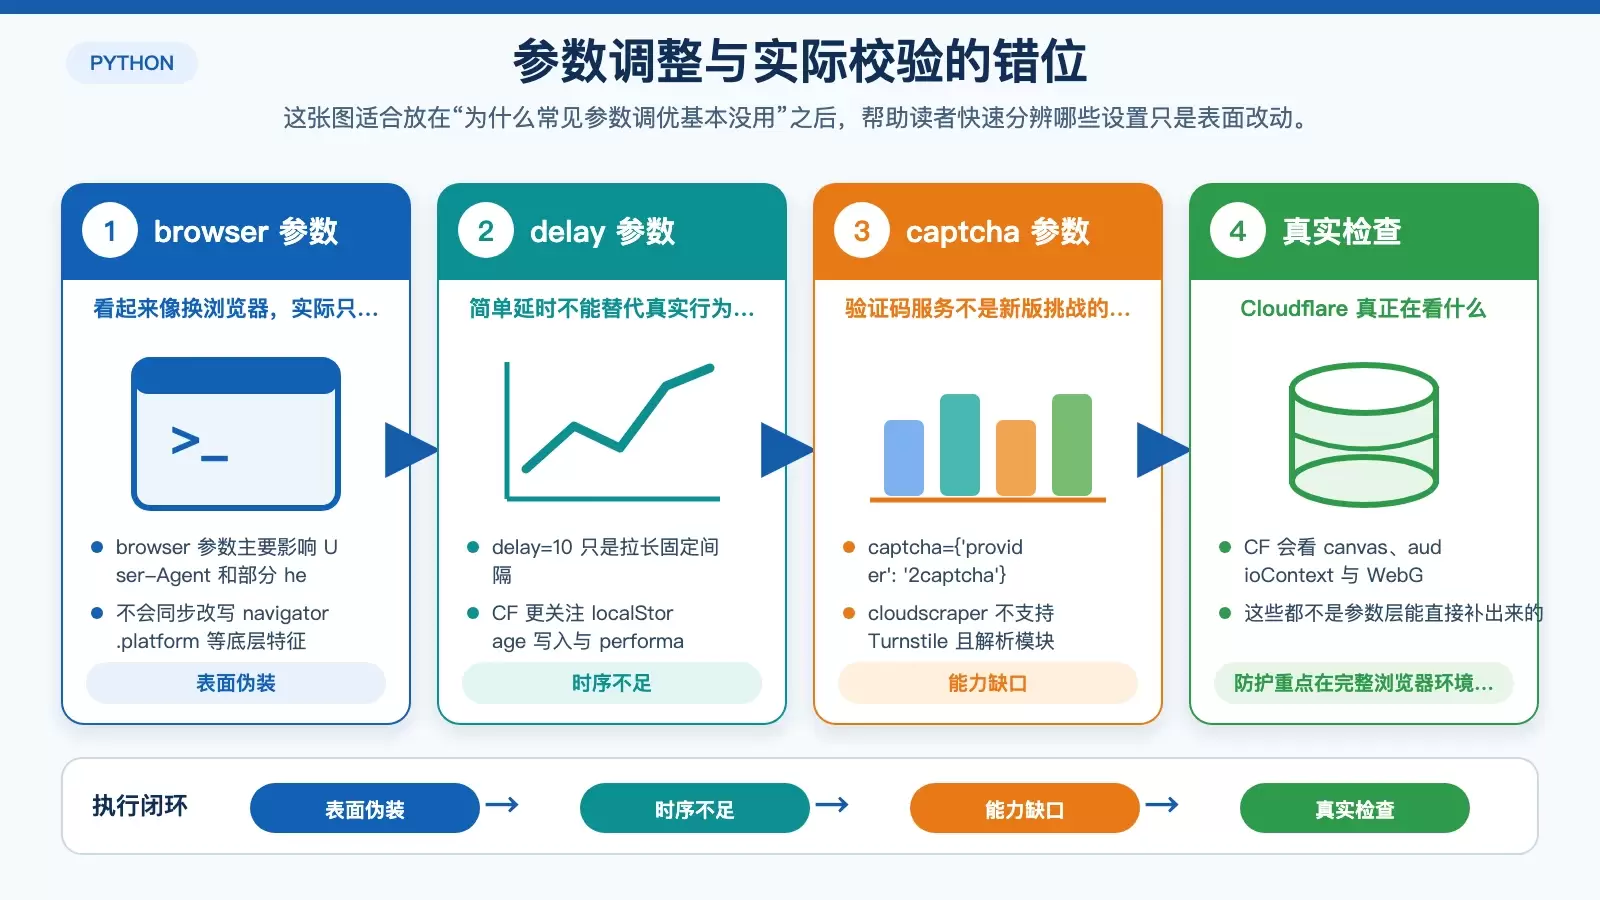
网上常见的 delay、browser、captcha 等参数,在高防护场景里大多只是表面调整,解决不了 Cloudflare 实际校验的重点。
browser 参数只能改表面标识
cloudscraper 的 browser 参数,本质上主要影响 User-Agent 和部分请求头,并不会真正补齐浏览器指纹环境。
scraper = cloudscraper.create_scraper(browser={'browser': 'firefox', 'platform': 'windows'})这类写法看起来像是“伪装成 Firefox on Windows”,但实际并不会同步改写 navigator.platform、navigator.hardwareConcurrency、WebGL vendor、canvas 渲染结果或 audioContext 特征。Cloudflare 真正看的,恰恰是这些更底层的环境信号。
delay 不是 Cloudflare 速率限制的关键
delay=10 这种设置也经常被误用。Cloudflare 的速率限制和风控判断并不只是看“间隔够不够长”,而是会结合行为链分析,例如 localStorage 写入、performance.timing 序列、资源加载顺序、事件循环延迟等细节。单纯把请求间隔拉长,无法让一个不真实的执行环境突然变得可信。
captcha 参数也补不上 Turnstile 缺口
类似下面的配置,在新版站点上也很难起作用:
captcha={'provider': '2captcha'}原因很明确:cloudscraper 本身并不支持 Turnstile,而且其 JS challenge 解析模块已经明显滞后。即便补了验证码服务,也无法替代完整浏览器环境对挑战逻辑的执行。
目前真正能跑通的替代方案
当前更稳定的思路,不是“绕过 Cloudflare”,而是尽量“不触发异常特征”——让访问行为看起来和真实 Chrome 浏览器手动打开页面一致。落到实现上,真正可行的路线基本只剩两类:复用真实 Chromium,并主动抹除自动化痕迹。
方案一:Playwright 复用真实 Chromium
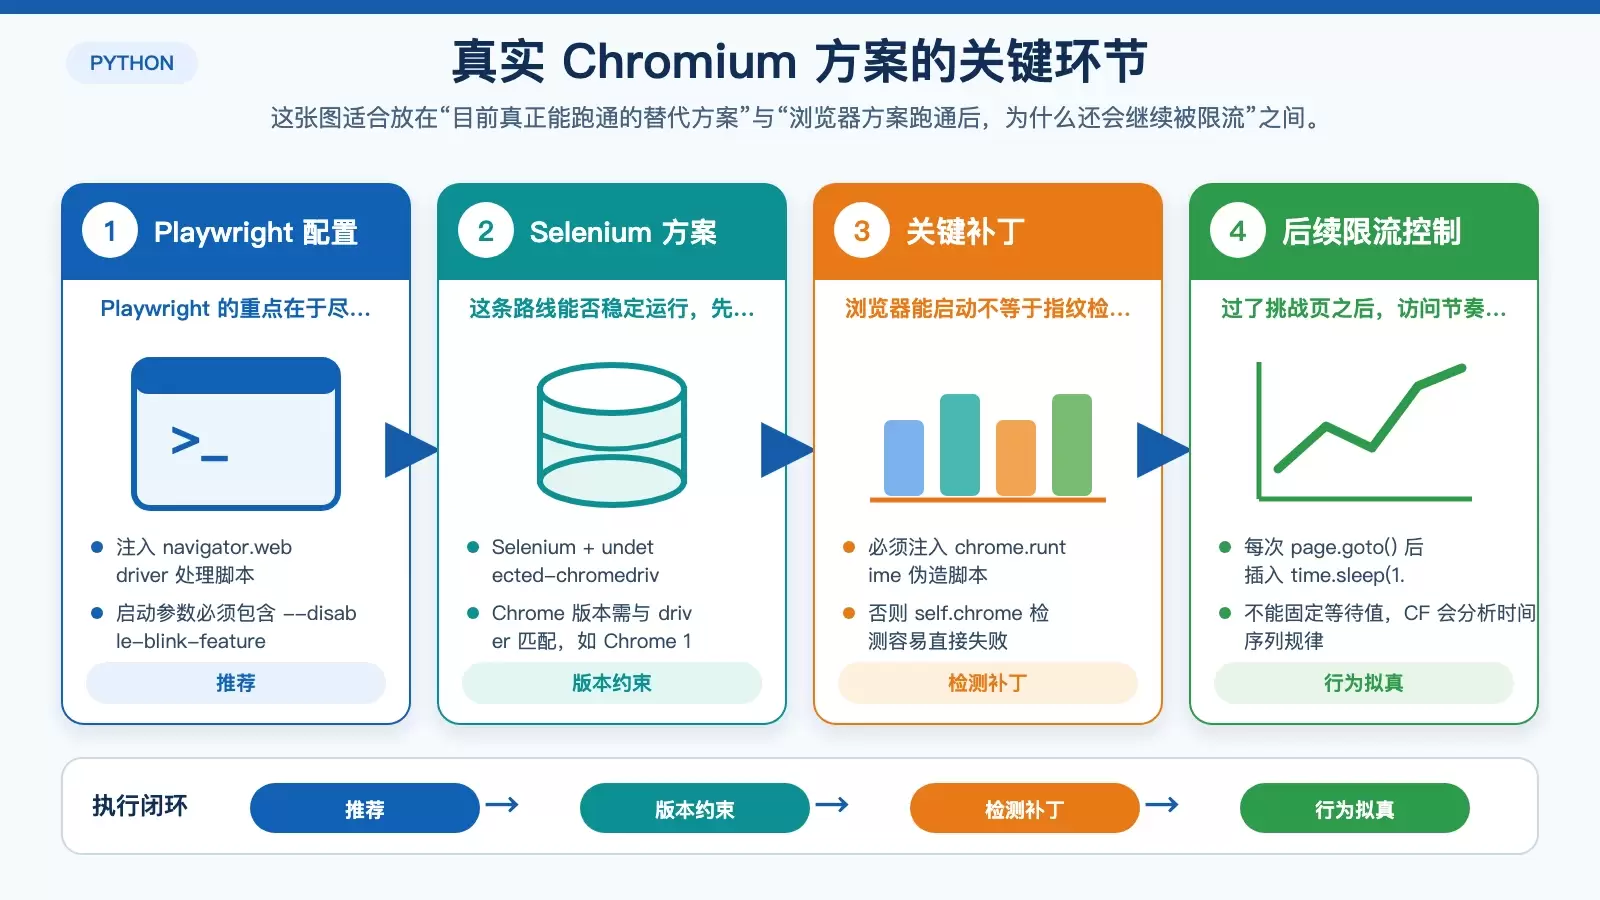
如果优先考虑轻量和维护成本,Playwright 往往是更容易落地的选择。原文里提到的关键配置有三点:
- 注入脚本,把
navigator.webdriver处理为不可见 - 启动时必须添加
--disable-blink-features=AutomationControlled - 避免使用
--no-sandbox,否则某些 WebGL 检测可能直接失败
page.add_init_script("Object.defineProperty(navigator, 'webdriver', {get: () => undefined})")这里的重点不是“随便隐藏一个字段”,而是让页面启动后的初始环境更接近真实浏览器。Cloudflare 会在非常早的阶段读取环境特征,等页面脚本都跑起来之后再补救,通常已经晚了。
方案二:Selenium + undetected-chromedriver2
另一条可用路线是 Selenium + undetected-chromedriver2。需要注意的是,文中明确指出 v2 仍可用,而 v3 已弃用,因此版本匹配要格外小心。
- Chrome 版本必须与 driver 匹配,例如
Chrome 124对应ucd v3.5.x - 必须注入
chrome.runtime伪造脚本,否则self.chrome检测会失败
这条路线能不能跑通,往往不取决于“代码能不能启动浏览器”,而取决于浏览器版本、驱动版本和指纹补丁是不是完整对齐。少一个点,Cloudflare 的检测就可能直接命中。
不建议继续投入的方案
文中还点名了两类应尽量避免的方向:
FlareSolverr:Docker 依赖重,容易形成单点故障- 自研 JS 执行沙盒:Cloudflare challenge 逻辑更新频繁,维护成本非常高
这两条路的问题都不是“完全不能用”,而是长期维护收益太差。前者在工程上偏重,后者则会被 Cloudflare 每月更新的挑战逻辑持续追着跑。
浏览器方案跑通后,为什么还会继续被限流
这是实战里最容易被忽略的一环:即使已经换成浏览器方案,能打开页面也不代表后续请求就稳定。连续访问、固定节奏访问,仍然可能被扔进 Cloudflare 的等待队列。
原文给出的关键建议是:每次 page.goto() 后都要插入 time.sleep(1.5–3),而且不能使用固定值。原因在于 Cloudflare 会分析时间序列规律,过于机械的停顿模式本身就是风险信号。
更准确地说,真正的“拟真”不只是请求头和 User-Agent,而是整条访问链都要接近真实用户,包括:
- 请求之间的时间分布
- 资源加载顺序
- 事件循环延迟
- 页面交互后的时序反馈
如果前面的挑战能过,后面的行为链却像脚本批量执行,Cloudflare 仍然可能在后续阶段继续收紧策略。
结论:先放弃“补参数”,再谈稳定抓取
把问题归纳起来,其实判断标准很清楚:只要目标站点启用了当前主流 Cloudflare 防护,尤其是 I'm Under Attack 或新版 Turnstile,cloudscraper 这类基于 execjs + Node.js 的方案就很难继续承担主力角色。它失败的核心不是配置细节,而是运行时能力和浏览器指纹两边都不够像真的 Chrome。
如果只是偶尔碰到低强度防护网站,cloudscraper 也许还能继续用;但只要目标是更稳定地处理当前 Cloudflare 挑战,工程上更现实的做法已经是转向真实 Chromium,并把自动化痕迹、版本匹配和行为时序一起纳入设计。















