


Python+Selenium实现验证码识别与自动登录实战

本文介绍使用Python结合Selenium和Tesseract实现网站自动登录的方法。通过定位验证码URL并截取图片,利用PIL进行预处理后调用Tesseract识别字符。文中提供了完整的代码示例及处理像素点背景验证码的具体步骤,适用于需要绕过简单图形验证码的自动化测试场景。
因业务需求,部分网站登录环节包含验证码验证。此前曾尝试研究验证码识别技术,但始终无法准确获取目标验证码。直至本周五重新梳理该需求,并于昨日成功解决了相关问题。
以下是具体的实现方案:
Python运行环境版本为3.4.3
依赖的核心库包括PIL、selenium以及tesseract
首先展示相关代码实现:
#coding:utf-8
import subprocess
from PIL import Image
from PIL import ImageOps
from selenium import webdriver
import time,os,sys
def cleanImage(imagePath):
  image = Image.open(imagePath)  #打开图片
  image = image.point(lambda x: 0 if x<143 else 255) #处理图片上的每个像素点,使图片上每个点“非黑即白”
  borderImage = ImageOps.expand(image,border=20,fill='white')
  borderImage.save(imagePath)

def getAuthCode(driver, url="http://localhost/"):
  captchaUrl = url + "common/random"
  driver.get(captchaUrl)
  time.sleep(0.5)
  driver.save_screenshot("captcha.jpg")  #截屏,并保存图片
  #urlretrieve(captchaUrl, "captcha.jpg")
  time.sleep(0.5)
  cleanImage("captcha.jpg")
  p = subprocess.Popen(["tesseract", "captcha.jpg", "captcha"], stdout=\
             subprocess.PIPE,stderr=subprocess.PIPE)
  p.wait()
  f = open("captcha.txt", "r")

  #Clean any whitespace characters
  captchaResponse = f.read().replace(" ", "").replace("\n", "")
  print("Captcha solution attempt: " + captchaResponse)
  if len(captchaResponse) == 4:
    return captchaResponse
  else:
    return False

def withoutCookieLogin(url="http://org.cfu666.com/"):
  driver = webdriver.Chrome()
  driver.maximize_window()
  driver.get(url)
  while True:
    authCode = getAuthCode(driver, url)
    if authCode:
      driver.back()
      driver.find_element_by_xpath("//input[@id='orgCode' and @name='orgCode']").clear()
      driver.find_element_by_xpath("//input[@id='orgCode' and @name='orgCode']").send_keys("orgCode")
      driver.find_element_by_xpath("//input[@id='account' and @name='username']").clear()
      driver.find_element_by_xpath("//input[@id='account' and @name='username']").send_keys("username")
      driver.find_element_by_xpath("//input[@type='password' and @name='password']").clear()
      driver.find_element_by_xpath("//input[@type='password' and @name='password']").send_keys("password")
      driver.find_element_by_xpath("//input[@type='text' and @name='authCode']").send_keys(authCode)
      driver.find_element_by_xpath("//button[@type='submit']").click()
      try:
        time.sleep(3)
        driver.find_element_by_xpath("//*[@id='side-menu']/li[2]/ul/li/a").click()
        return driver
      except:
        print("authCode Error:", authCode)
        driver.refresh()
  return driver
driver = withoutCookieLogin("http://localhost/")
driver.get("http://localhost/enterprise/add/")
关键步骤在于如何准确获取目标验证码
在获取验证码的过程中,曾遇到诸多困难并参考了大量资料。许多教程仅侧重识别算法,却未详细说明如何从当前页面获取验证码图片,导致实际操作中难以落地。
针对上述问题,采用的处理流程如下:
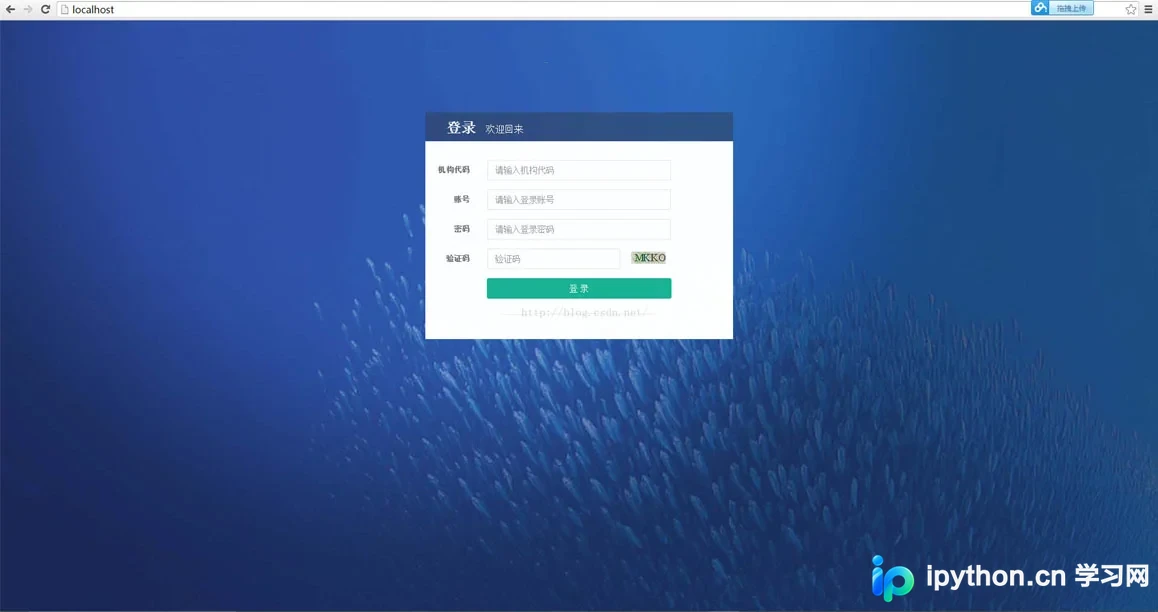
1. 使用Selenium驱动浏览器打开目标登录页面(记为url1)
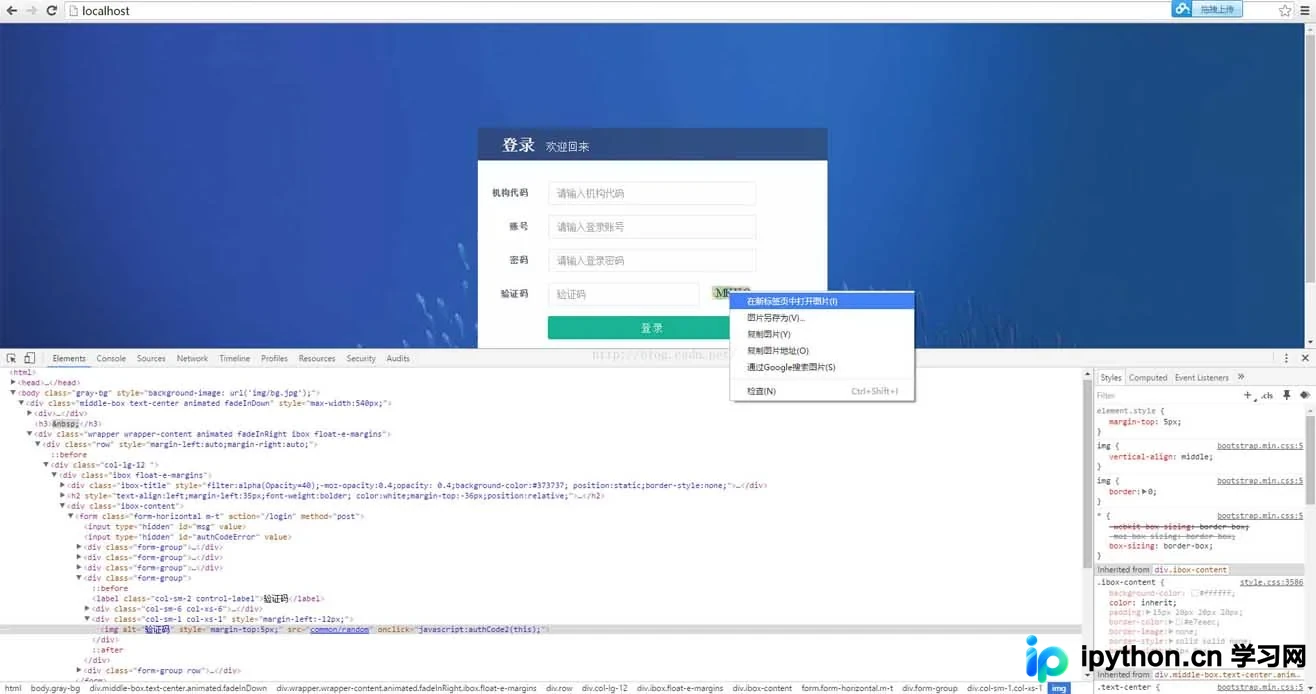
2. 通过检查网页元素定位验证码图片的链接地址(记为url2);实际操作中,也可通过右键菜单选择‘在新标签页打开’直接获取该地址
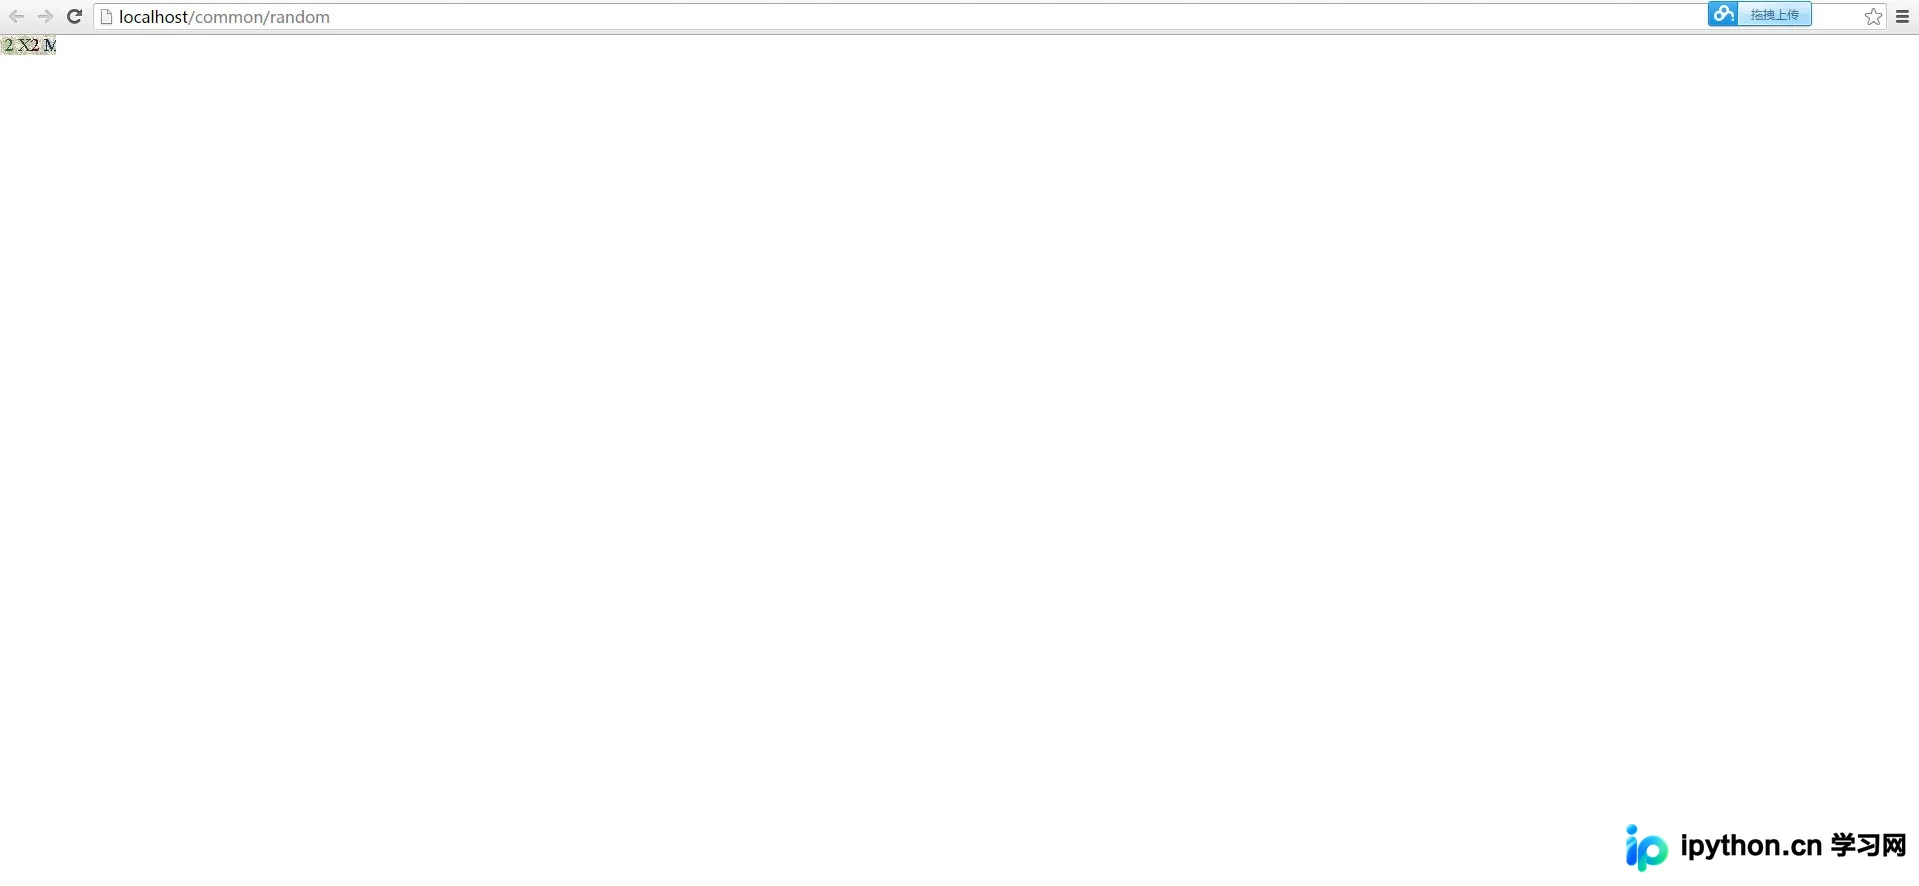
3. 在url1页面中,通过构造请求访问url2以加载验证码图片,随后对当前浏览器窗口进行截屏并保存验证码区域图片
4. 对保存的图片进行识别处理,获取验证码字符串。之后点击浏览器后退按钮,返回至url1登录页面
5. 在登录表单中输入账号信息及识别得到的验证码
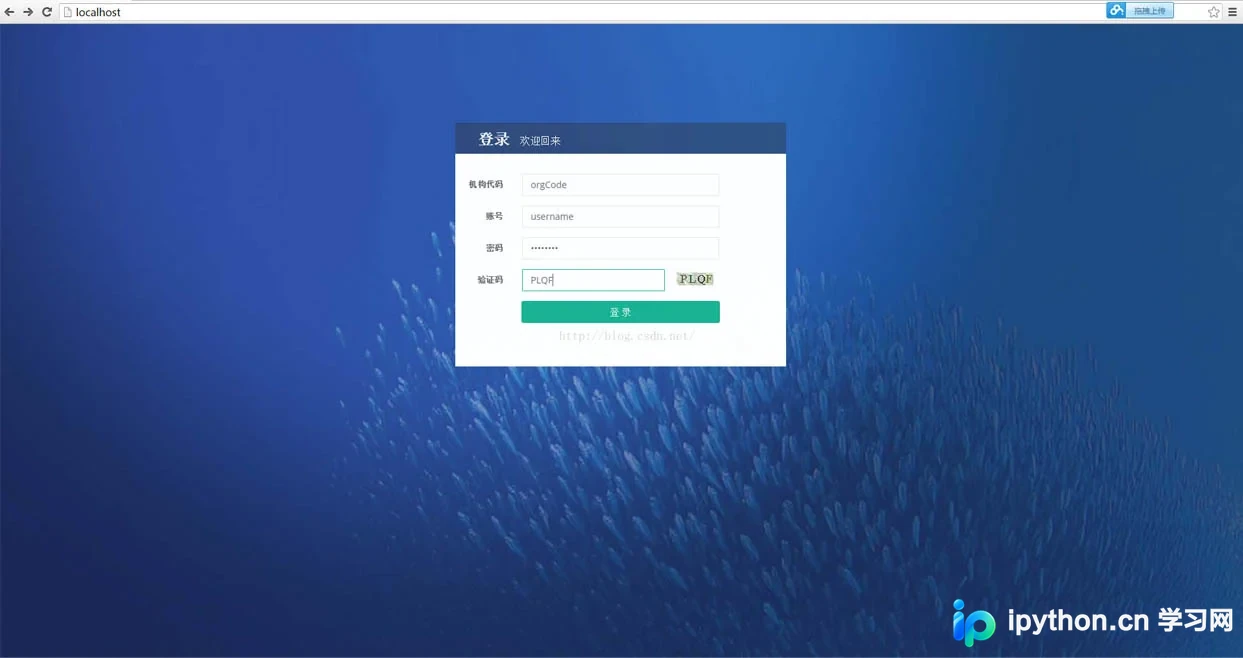
6. 点击登录按钮提交表单
7. 验证登录后的页面状态以确认是否成功。若登录失败,则需重复步骤1至7的操作
出于信息安全考虑,此处演示使用的是本地搭建的服务环境。该方法已在伯乐在线注册页面验证通过,确认可获取验证码。需注意,此处理方法仅适用于背景为像素点的简单验证码;若验证码包含干扰线条,则需额外增加图像预处理步骤。
以上内容为本文的全部分享,希望能为读者的学习提供有益参考,同时也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















