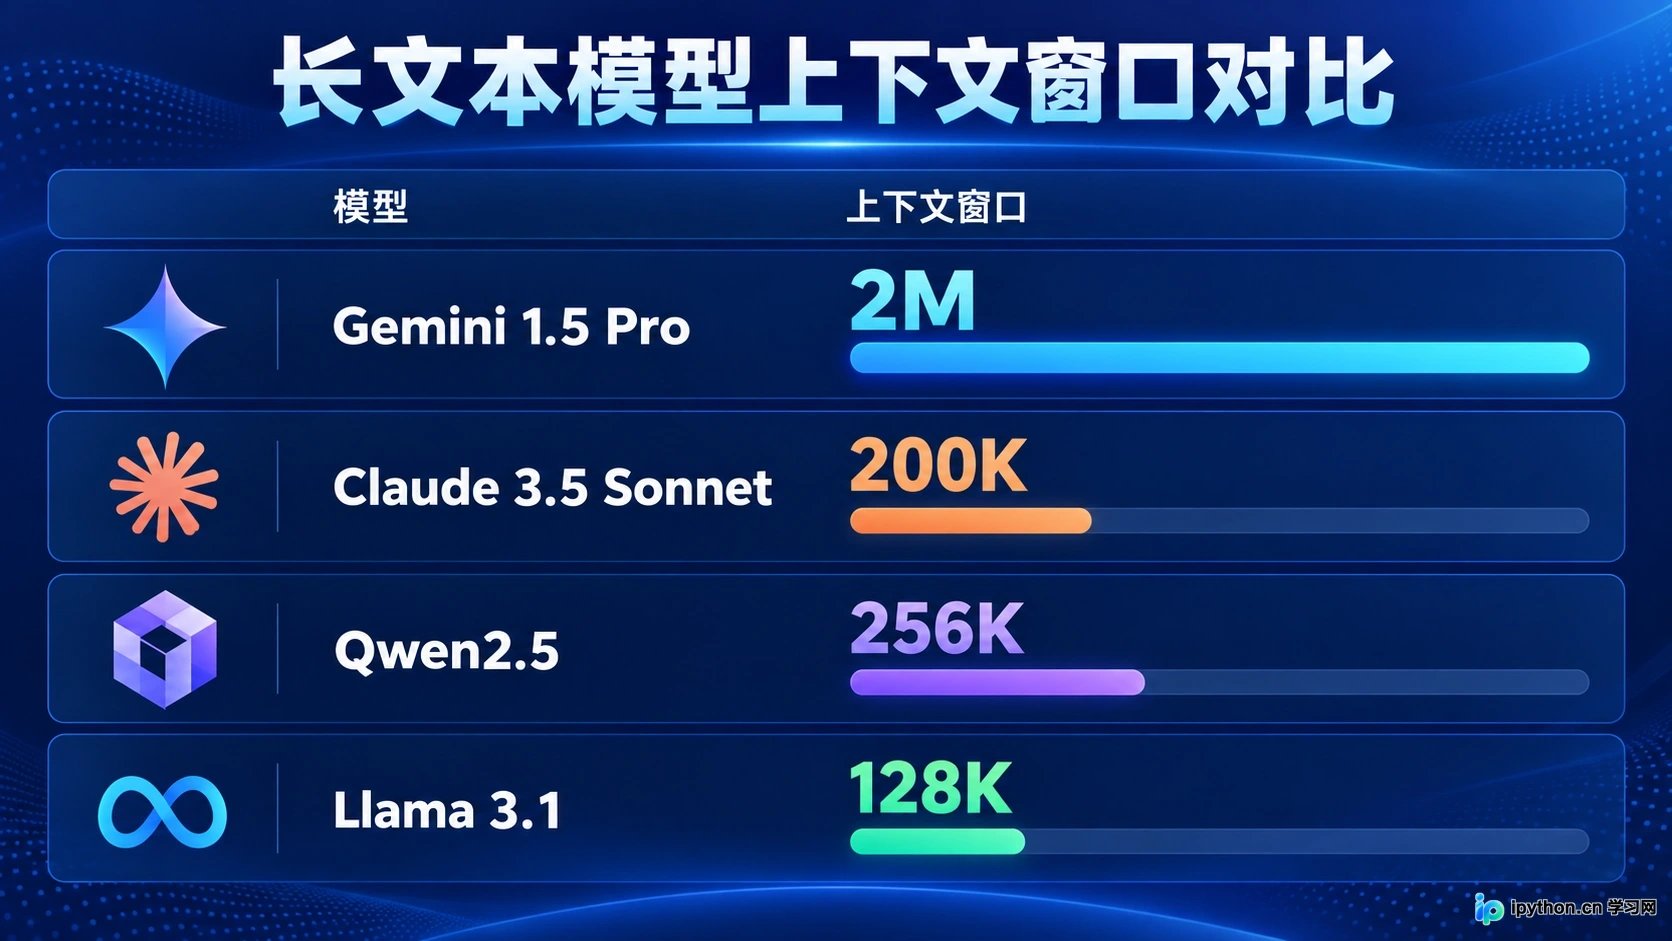
长文本处理大模型排名:支持百万级Token上下文的模型有哪些
本文梳理当前支持超长上下文(100K-1M+ Token)的主流大模型,基于官方参数与“大海捞针”测试表现进行对比。重点分析Claude 3.5 Sonnet、Gemini 1.5 Pro、Qwen2.5等模型在长文档检索中的准确率差异,帮助开发者根据实际业务需求选择最合适的基座模型。
09-20
4




本文梳理当前支持超长上下文(100K-1M+ Token)的主流大模型,基于官方参数与“大海捞针”测试表现进行对比。重点分析Claude 3.5 Sonnet、Gemini 1.5 Pro、Qwen2.5等模型在长文档检索中的准确率差异,帮助开发者根据实际业务需求选择最合适的基座模型。
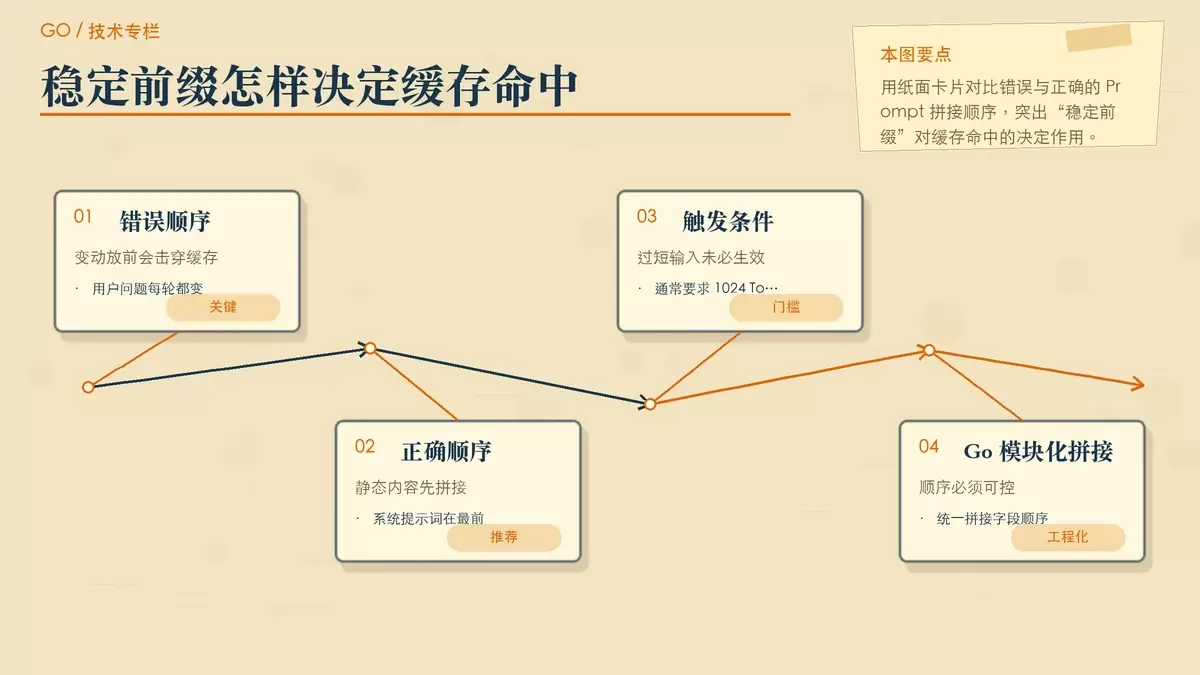
Prompt Caching 已经从“可选优化”变成 AI 后端的常规能力。对 Go 开发者来说,真正影响成本和延迟的,往往不是模型参数,而是 Prompt 顺序、动态字段位置、RAG 排序稳定性,以及是否把缓存逻辑封装进请求结构。
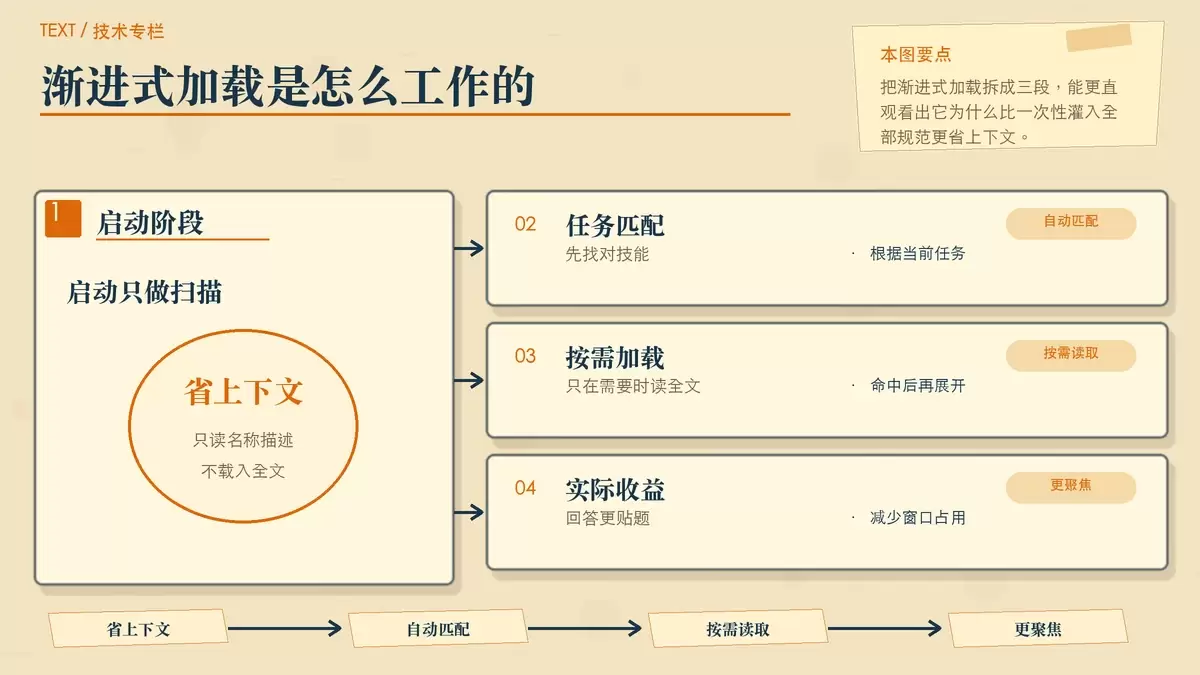
npx skills 把 AI 助手需要的领域知识做成可安装、可更新的技能包,让 Claude Code、Cursor、Codex 等工具在具体任务里按需加载规范与流程。本文从原理、命令、安装范围到实战流程梳理它的使用方式,帮助你判断它是否适合团队落地。
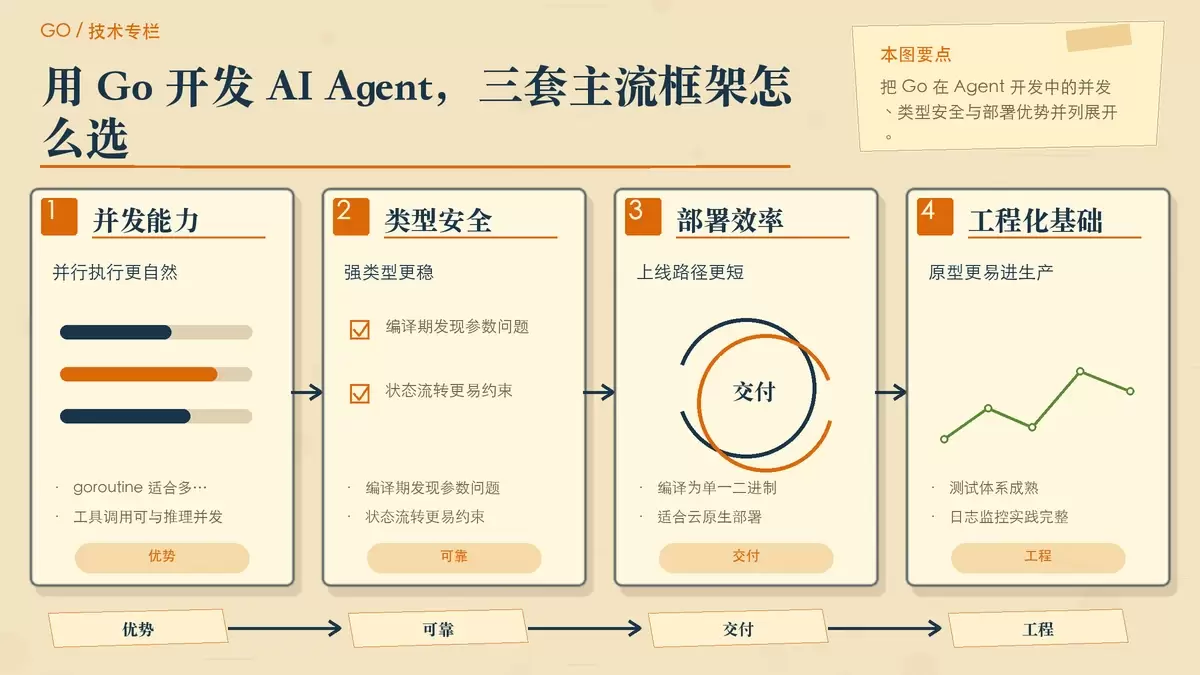
Go 不只是高并发后端语言,也开始成为构建 AI Agent 的现实选择。本文从并发、类型安全和部署效率切入,对比 LangChainGo、Google ADK-Go、Eino 三个代表性框架,并给出按团队栈、项目复杂度和生态诉求做判断的选型思路。
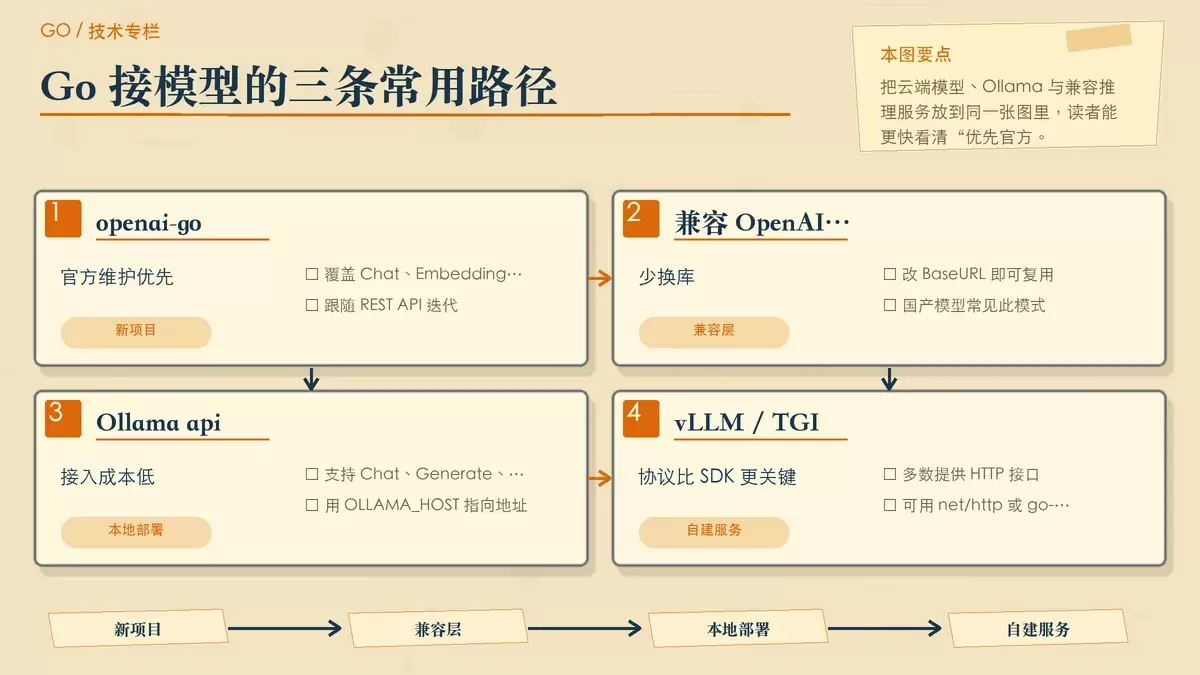
Go 接入大模型并不缺方案,难点在于生态分散、库的定位不同。本文按云端模型、MCP、本地推理和 RAG 四类场景梳理主流 Go 库,保留各自适用边界,并给出新项目与存量项目的选型建议,方便快速判断该直接上官方 SDK,还是走兼容接口或自建链路。
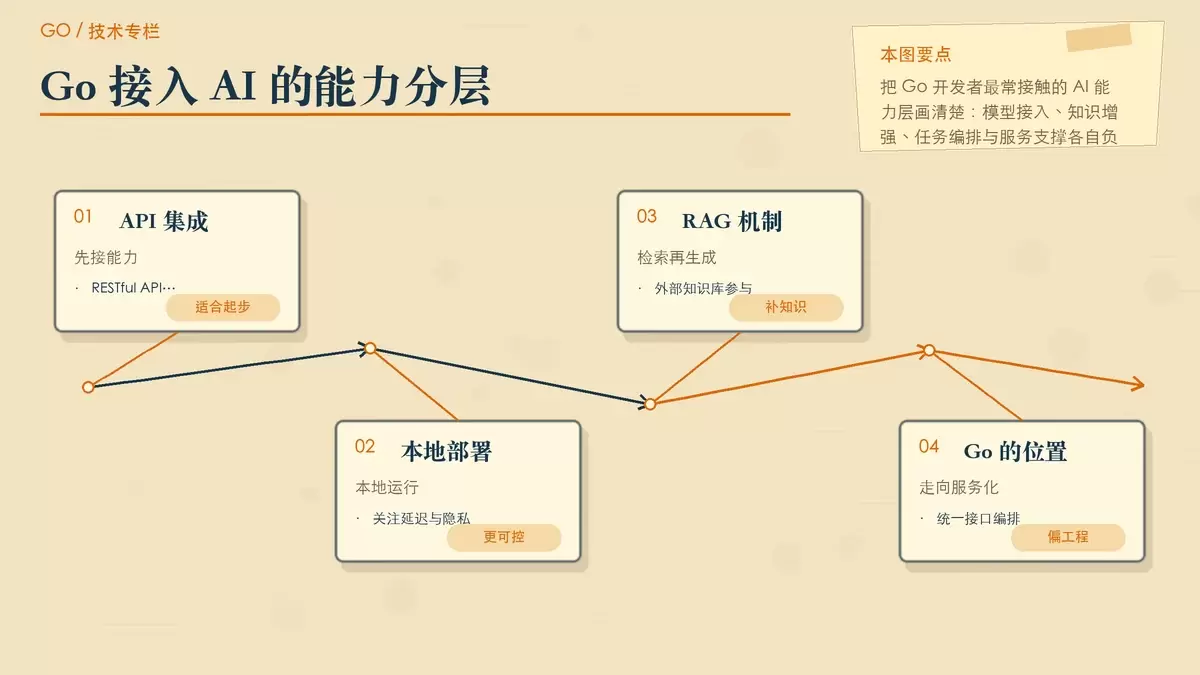
这篇文章从 Go 开发者的实际工作出发,梳理 AI 时代最值得掌握的几类核心概念:大模型、RAG、智能体、提示词工程,以及落地时常见的并发与服务化实践。重点不在“追热点”,而在判断 Go 适合切入 AI 的哪些层、该先学什么、又该怎样把能力接到真实系统里。