利用Python的pandas数据处理包将宽表变成窄表
本文介绍如何使用Python的pandas库将宽表转换为窄表。通过pd.melt函数重塑数据结构,并结合dropna处理空值,最终导出为Excel文件。该方法简化了数据分析流程,提升了办公效率。
2026-10-16
0



本文介绍如何使用Python的pandas库将宽表转换为窄表。通过pd.melt函数重塑数据结构,并结合dropna处理空值,最终导出为Excel文件。该方法简化了数据分析流程,提升了办公效率。
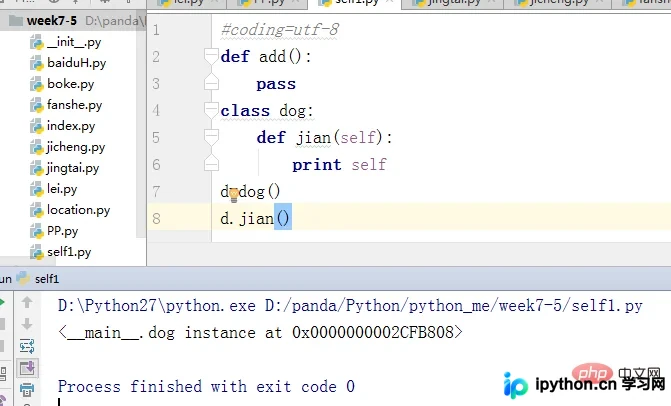
本文深入解析Python中self关键字的本质,阐明其作为类实例引用的核心作用。通过代码示例展示self在__init__及普通方法中指向同一内存地址的特性,解释Python如何将实例方法调用自动转换为类方法并传入self参数。文章结合具体对象a与b的对比,说明self如何区分不同实例的特征与状态,帮助开发者掌握面向对象编程中对象状态管理的底层逻辑。
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
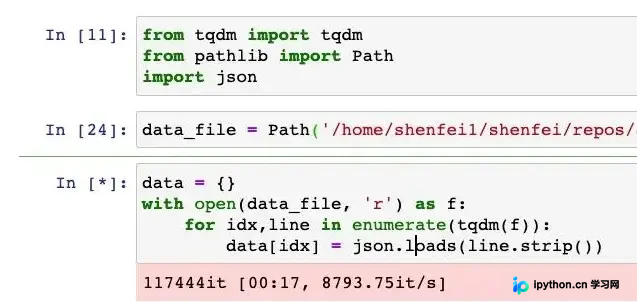
本文分析 Python 中使用 tqdm 模块处理大文件读取时进度条不显示的原因,指出因文件迭代器无法提供总长度导致的问题。通过预计算文件行数的方法,将结果赋值给 tqdm 的 total 参数,成功实现大文件读取进度的实时监控与显示。
本文详细解析Python中类对象的构造函数[[wp:a0]]与析构函数[[wp:a1]]的工作机制,并通过代码演示对象创建、引用更迭、函数内部生命周期及返回值处理时的内存分配与释放过程,帮助开发者深入理解Python对象的内存管理。
本文深入解析Python中re模块的核心用法,涵盖match、search、findall及sub等关键函数。详细讲解正则表达式语法、标志位控制、分组与命名分组技巧,以及compile编译优化和贪婪/非贪婪模式的区别,帮助开发者高效处理字符串匹配与替换任务。
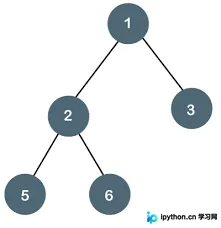
本文介绍Python3中二叉树前序遍历的迭代实现方案。通过利用栈(Stack)的LIFO特性,依次弹出节点并压入右子节点和左子节点,从而在不使用递归的情况下完成根、左、右的顺序访问。文章包含完整代码示例及详细步骤解析,适用于技术面试准备。
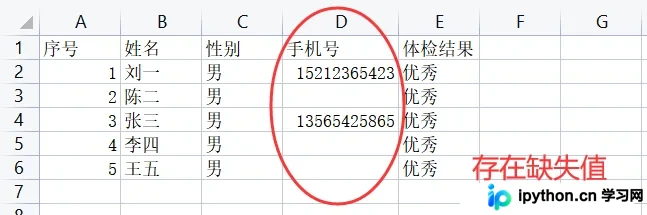
本文介绍如何使用Python的Pandas库读取和写入.xlsx格式文件。通过示例演示了如何指定Sheet名、表头及读取特定列,并展示了如何修改Excel数据后保存为新文件,确保原始数据不受影响。
本文详解Python requests库中post方法的data与json参数区别。data默认进行URL编码,Content-Type为application/x-www-form-urlencoded;json参数自动序列化字典并设置Content-Type为application/json。通过代码示例对比两种传参方式对请求头及数据格式的影响,帮助开发者正确选择参数。
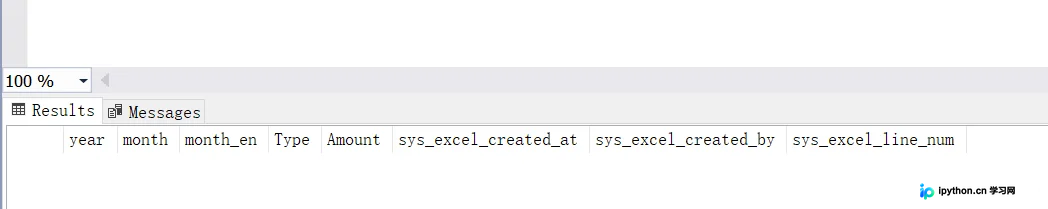
本文介绍在Python中连接SQL Server数据库并获取指定表所有列名的两种方法。第一种方法通过SysColumns系统视图获取,但结果无序;第二种方法利用INFORMATION_SCHEMA.COLUMNS视图,可精确提取COLUMN_NAME字段。文章提供了完整的连接代码、SQL语句及fetchall()等结果获取方式,帮助开发者实现数据库元数据查询。
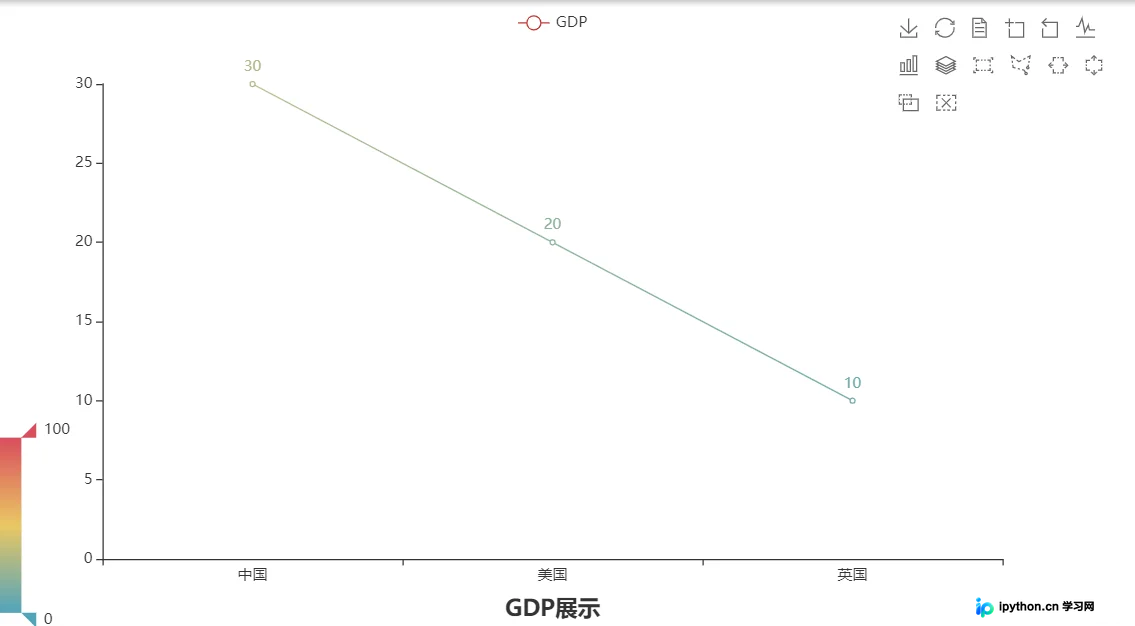
本文详细介绍Python第三方库pyecharts的使用方法,涵盖折线图、地图、柱状图及基础时间线柱状图的实现步骤。通过导包、创建对象、添加数据、设置全局配置及render渲染等核心环节,帮助开发者快速掌握动态图表生成技巧,适用于各类数据可视化场景。
本文详细介绍Python爬虫中requests库的安装方法及GET与POST请求的具体使用。涵盖通过pip或源码安装requests,演示如何构造带参数的GET请求、获取JSON数据、处理二进制文件下载,以及利用data和files参数进行POST请求和文件上传。同时解析响应状态码、异常抛出及JSON转换技巧,帮助开发者高效完成HTTP交互。