Python数据分析中shape()函数的核心用法与维度解析
本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
2026-10-16
0



本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
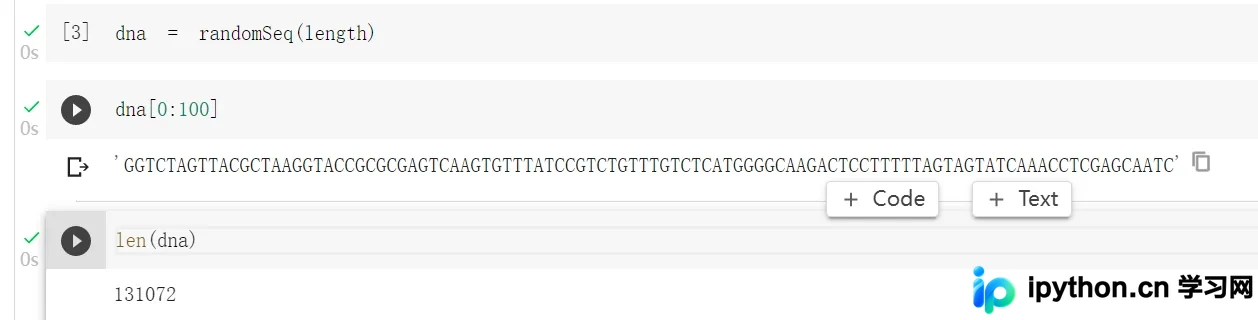
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
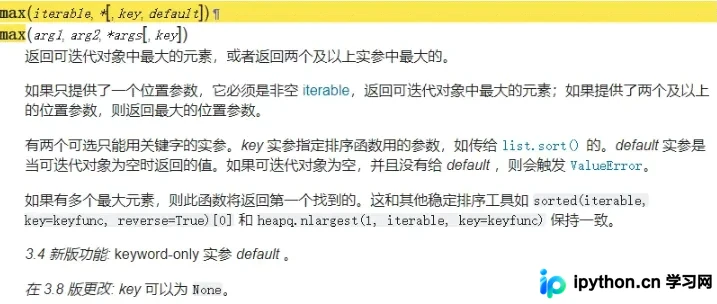
本文探讨在Python中如何优雅地获取最大值对应的变量名而非仅返回值。通过定义包含名称和值的自定义类,并重写__eq__、__gt__等比较魔法方法,使实例可直接参与max()函数比较。该方法避免了globals()遍历的冗余,结构清晰且逻辑顺畅,适用于需要同时获取极值及其标识符的场景。
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
本文详细解析Python中Matplotlib库绘制子图的两种核心方法:plt.subplot与plt.subplots。通过对比两者在参数设置、返回值及代码结构上的差异,深入讲解如何高效管理画布与坐标轴。同时,文章提供了修改子图坐标轴标签、刻度、范围及标题的具体代码示例,帮助开发者掌握独立控制每个子图样式的高级技巧。
本文介绍Python中向JSON文件追加数据的两种实现方式。第一种方法通过List Dump将JSON转换为列表后追加,但会改变原始结构,不推荐使用;第二种方法利用Dict Update直接更新字典对象,操作简洁高效,是推荐的最佳实践。文章详细对比了两种方法的步骤与优缺点,帮助开发者选择合适的数据处理方案。
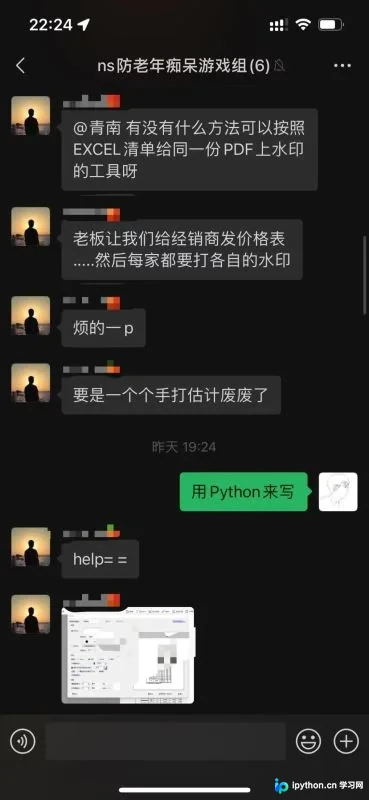
本文详解如何利用Python将Excel中的经销商名单批量转换为带有个人专属水印的PDF文件。通过Reportlab生成带透明度的旋转文字水印PDF,再使用Pikepdf将水印图层叠加至目标价目表,实现防泄露追踪。文章提供完整代码逻辑与参数配置说明,适合初学者学习模块化编程思路。
本文深入解析Python中类变量与实例变量的区别,重点讲解如何利用@classmethod和cls参数通过类名直接修改类变量的值。文章指出,通过实例对象修改类变量会创建同名实例变量,而通过cls或类名修改则会影响所有实例。同时提供了完整的代码示例,演示了类方法在模型加载等场景下的实际应用,并强调了类变量定义顺序的重要性。
本文分享使用Python异步库aiohttp爬取知乎热榜的完整流程。针对直接解析DOM无法获取摘要和详细链接的问题,通过审查JS代码定位数据源,利用正则表达式提取JSON数据并解析,最终实现标题、热度、摘要、链接及图片的高效抓取。
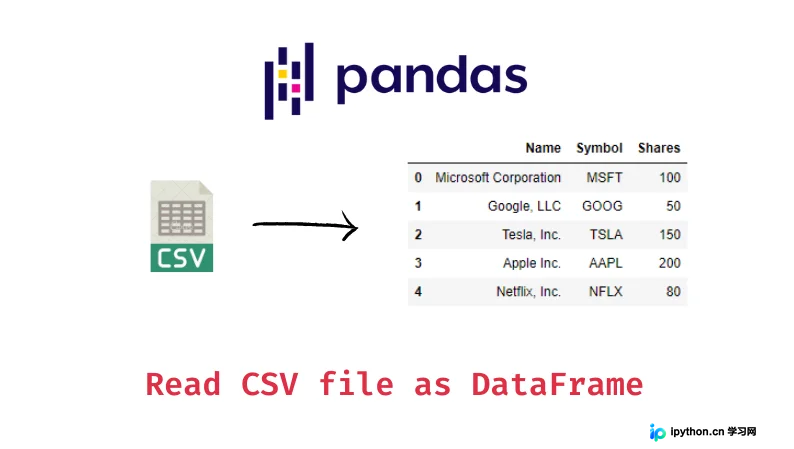
本文详细介绍Python中处理CSV文件的两种核心方式。首先解析内置csv库的reader与DictReader用法,涵盖delimiter、quotechar等关键参数及处理含逗号字段的技巧;随后深入Pandas库,演示如何快速读取、格式化日期及写入CSV文件,提供从基础到进阶的完整代码示例。
本文详细解析了使用Python开发MD5碰撞破解脚本的核心思路。通过string模块生成字符集,利用itertools进行全排列组合,并结合hashlib计算MD5值。为解决长字符串耗时问题,脚本采用多线程与多进程技术,针对5至18位字符串并行处理,显著提升了碰撞效率。
本文详细解析如何使用Python实现随机漫步模拟。通过构建RandomWalk类,利用random模块生成随机坐标,并结合Matplotlib进行可视化。内容涵盖基础路径绘制、颜色映射区分步序、高亮起点终点、增加采样点数以及调整图表尺寸以适应屏幕,提供完整的代码示例与效果说明。