


Python实现DNA序列One-Hot编码并存储为TFRecord文件及读取流程

本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
DNA序列数据处理背景与目标
近期导师布置了一项生物信息学方向的模型跑通任务,作为计算机专业的学生,我对部分领域知识尚不熟悉。目前的研究方向大致是利用深度学习模型来预测病毒感染人类的风险。
针对病毒研究,首要步骤是获取其DNA碱基序列,随后将这些由A、C、G、T组成的序列输入模型,以预测其是否具备感染人类的能力。坦白说,我对最终效果持保留态度,因为当前主流模型多基于Transformer架构,且我认为仅凭DNA序列很难做出准确的预测。
尽管存在疑虑,但仍需推进工作。目前我对数据的下载来源、所需数据类型以及下载后的处理流程仍感到困惑。假设上述数据准备工作已完成,接下来的步骤便是将数据输入模型进行训练。
目前已有初步进展,了解到需要使用FASTA格式的文件,从中提取长串的ACGT序列,并将其转换为模型可处理的数据格式。后续处理细节待进一步研究。
假设目前已拥有ACGT序列,接下来的目标是将这些序列转换为模型可处理的矩阵形式。
生成随机DNA序列与One-Hot编码实现
在此,我随机生成了一个长度为131072的基因序列。选择这个数字是因为参考论文中使用了该数值,因此暂时沿用此长度进行实验。
具体实现步骤如下:
首先导入必要的库文件。
import numpy as np
import random
import tensorflow as tf
import inspect
from typing import Any, Callable, Dict, Optional, Text, Union, Iterable
import os
接着,定义一个用于生成长度为131072bp序列的函数。
#随机生成131072的dna序列
length = 131072
def randomSeq(length):
  return ''.join([random.choice('ACGT') for i in range(length)])
该函数的返回结果是一个长度为length的字符串,格式类似于ACGTTGC。
由于序列模型无法直接处理原始字符串,需要将其转换为矩阵形式,这里采用One-Hot编码方式。
以ACGT序列为例,其编码结果如下:
[ [1,0,0,0],
[0,1,0,0],
[0,0,1,0],
[0,0,0,1]]
这种矩阵转换方式在网络上已有大量参考资料,此处不再赘述。
随后,我从其他代码中借鉴了一个非常实用的函数。
#DNA序列转为one-hot编码,可以直接拿来用
def one_hot_encode(sequence: str,
                   alphabet: str = 'ACGT',
                   neutral_alphabet: str = 'N',
                   neutral_value: Any = 0,
                   dtype=np.float32) -> np.ndarray:
  """One-hot encode sequence."""
  def to_uint8(string):
    return np.frombuffer(string.encode('ascii'), dtype=np.uint8)
  hash_table = np.zeros((np.iinfo(np.uint8).max, len(alphabet)), dtype=dtype)
  hash_table[to_uint8(alphabet)] = np.eye(len(alphabet), dtype=dtype)
  hash_table[to_uint8(neutral_alphabet)] = neutral_value
  hash_table = hash_table.astype(dtype)
  return hash_table[to_uint8(sequence)]
这是一个嵌套函数,经过仔细研究是可以理解的,这里主要关注其使用方法。
简要说明该函数的参数含义:
sequence:字符串类型,代表输入的碱基序列。
alphabet: str = ‘ACGT’:定义词表,仅需包含这四个字符。
neutral_alphabet: str = ‘N’,
neutral_value: Any = 0,
上述两个参数配合使用,意味着当遇到N碱基时,其编码向量将为[0,0,0,0]。
dtype=np.float32:指定内部元素的数据类型。
简单生成示例如下:
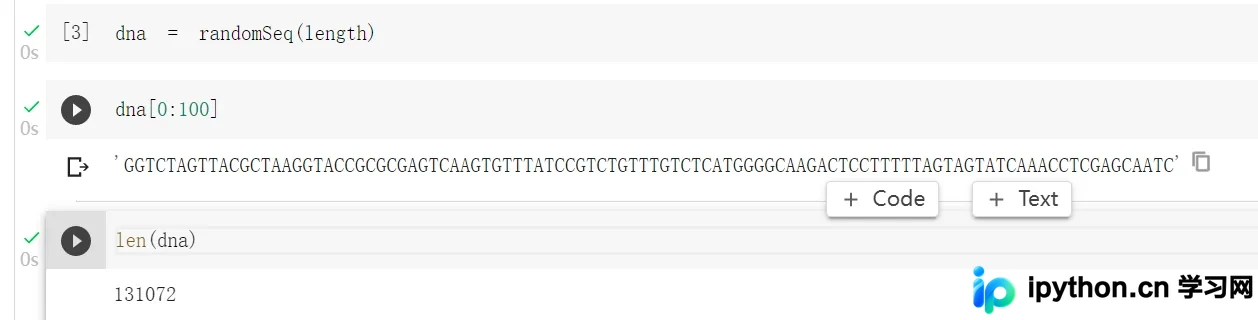
若输入序列长度为131072bp,则生成的矩阵维度为131072x4,现在执行序列到矩阵的转换。
将其编码为One-Hot矩阵。
dnaVec = one_hot_encode(dna)
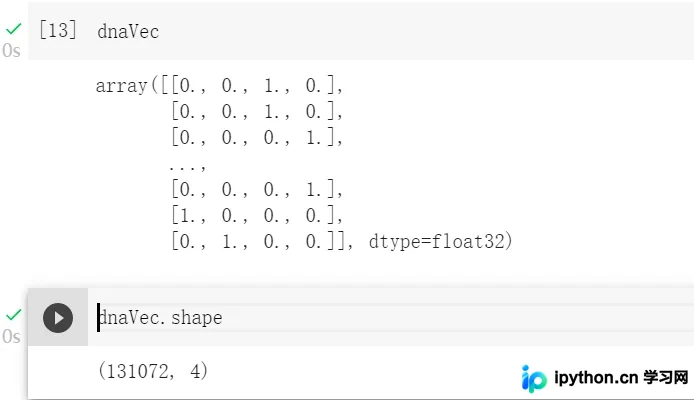
构建TFRecord文件与数据写入
此时DNA序列已转换为矩阵,接下来需要将这条序列(即一个样本数据)转换为TensorFlow中的TFRecord文件格式。TFRecord是TensorFlow专用的数据集存储格式,将数据集整理为此格式后,TensorFlow能够高效地读取和处理数据,从而支持大规模模型训练。
关于TFRecord文件的具体处理细节不再展开,当前的核心任务是构建Example对象。
在此之前,需要执行以下操作:
#给出结果的tfr文件的路径
path = '/content/drive/MyDrive/test_Enformer/result.tfr'
#dna的numpy数组转成字节流,这样才能存储
dnaVec = dnaVec.tobytes()
接下来将字节流数据写入TFRecord文件,同时写入该数据的标签。我的问题是基于DNA序列预测是否为病毒的二分类问题,因此将对应的真实标签也写入文件,标签值从0和1中随机选择。
from tensorflow.core.example.feature_pb2 import BytesList
with tf.io.TFRecordWriter(path) as writer:
  feature = {
      #序列使用的是tf.train.BytesList类型
      'sequence':tf.train.Feature(bytes_list=tf.train.BytesList(value=[dnaVec])),
      #label是随机生成的0,或者1
      'label':tf.train.Feature(int64_list=tf.train.Int64List(value=[np.random.choice([0,1])]))
  }
  example = tf.train.Example(features=tf.train.Features(feature=feature))
  writer.write(example.SerializeToString())
这部分代码执行完毕后,DNA序列及其对应标签已写入TFRecord文件。该文件中目前仅包含一个Example,实际应用中可以写入更多数据。
上述操作生成的TFRecord文件状态如下:

读取TFRecord文件与数据解析
至此,数据准备工作完成,接下来进行数据读取。
#从刚才的路径中加载数据集
dataset = tf.data.TFRecordDataset(path)
#定义Feature结构,告诉解码器每个Feature的类型是什么
feature_description = {"sequence": tf.io.FixedLenFeature((), tf.string),
              "label": tf.io.FixedLenFeature((), tf.int64)}
 #将 TFRecord 文件中的每一个序列化的 tf.train.Example 解码
def parse_example(example_string):
  #解析之后得到的example
  example = tf.io.parse_single_example(example_string,feature_description)
  #example['sequence']还是字节流的形式,重新转为数字向量
  sequence = tf.io.decode_raw(example['sequence'], tf.float32)
  sequence = tf.reshape(sequence,(length,4))  #形状需要重塑,不然就是一个长向量
  label = tf.cast(example['label'],tf.int64)  #标签对应的类型转换
#每一天example解析后返回对应的一个字典
  return {
      'sequence':sequence,
      'label': label
  }
#把parse_example函数映射到dataset中的每个example,
#这里的dataset中只有一个example
dataset = dataset.map(parse_example)
此时的dataset是一个可遍历对象,其内部元素可视为解析后的Example。
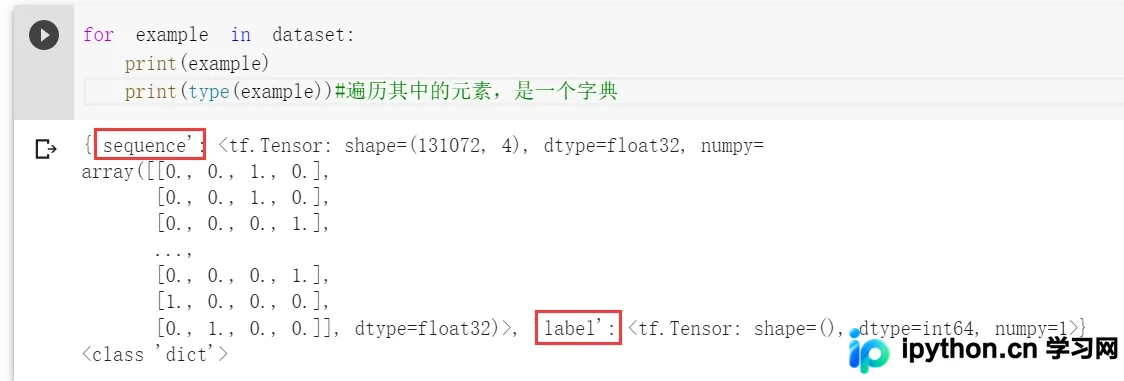
该字典包含两个键:sequence和label,分别对应序列矩阵和标签值。
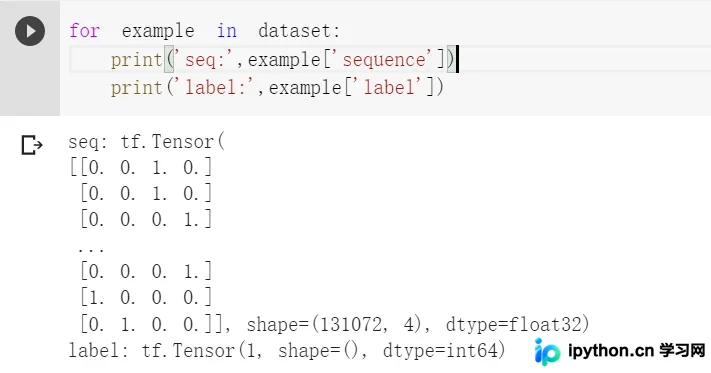
这就是可用于训练的数据格式。
本文关于Python实现DNA序列存储为TFRecord文件并读取流程的介绍到此结束,更多相关Python存储TFRecord文件的内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















