SQL MySQL LIMIT 语法详解:偏移量与数量查询
在 MySQL 中,LIMIT 子句用于限制返回数据的行数。本文详细解析其两种核心用法:单参数直接获取前 N 行;双参数从指定位置开始取数据。同时重点说明 OFFSET 关键字与双参数的区别及对应的行号计算逻辑,帮助开发者实现精准的数据提取与页面分页。
2026-10-15
0



在 MySQL 中,LIMIT 子句用于限制返回数据的行数。本文详细解析其两种核心用法:单参数直接获取前 N 行;双参数从指定位置开始取数据。同时重点说明 OFFSET 关键字与双参数的区别及对应的行号计算逻辑,帮助开发者实现精准的数据提取与页面分页。
针对 MySQL 8.0+ 登录时报错 1045 Access denied for user 'root'@'localhost' 的问题,提供通过命令行跳过权限验证、重置 root 为空密码的完整步骤。同时包含解决 Navicat 等客户端连接时的 2059 错误(更改加密认证方式),助你恢复数据库正常访问。
深入解析MySQL InnoDB缓冲池配置,涵盖innodb_buffer_pool_size与instances参数的合理设置方法。通过监控Innodb_buffer_pool_pages_data等状态变量,结合数据使用率公式动态调整内存分配,有效提升数据库I/O性能并降低磁盘读写开销。
在MySQL中,使用COUNT(DISTINCT)或GROUP BY时,传统方式会导致全索引扫描。MySQL 5.1+引入Loose Index Scan技术,通过跳过重复键值大幅减少IO。本文详解其适用条件、执行计划特征(Using index for group-by),以及Index Condition Pushdown对非精确匹配场景的补充优化作用。
本文详细解析MySQL主从复制中实现数据过滤的两种核心思路。重点讲解为何推荐在从库而非主库进行过滤,并通过CHANGE REPLICATION FILTER命令展示具体的过滤配置步骤(包括库级与表级过滤)。同时提供GTID模式下解决因表结构不一致导致的SQL线程报错及自动恢复方案。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
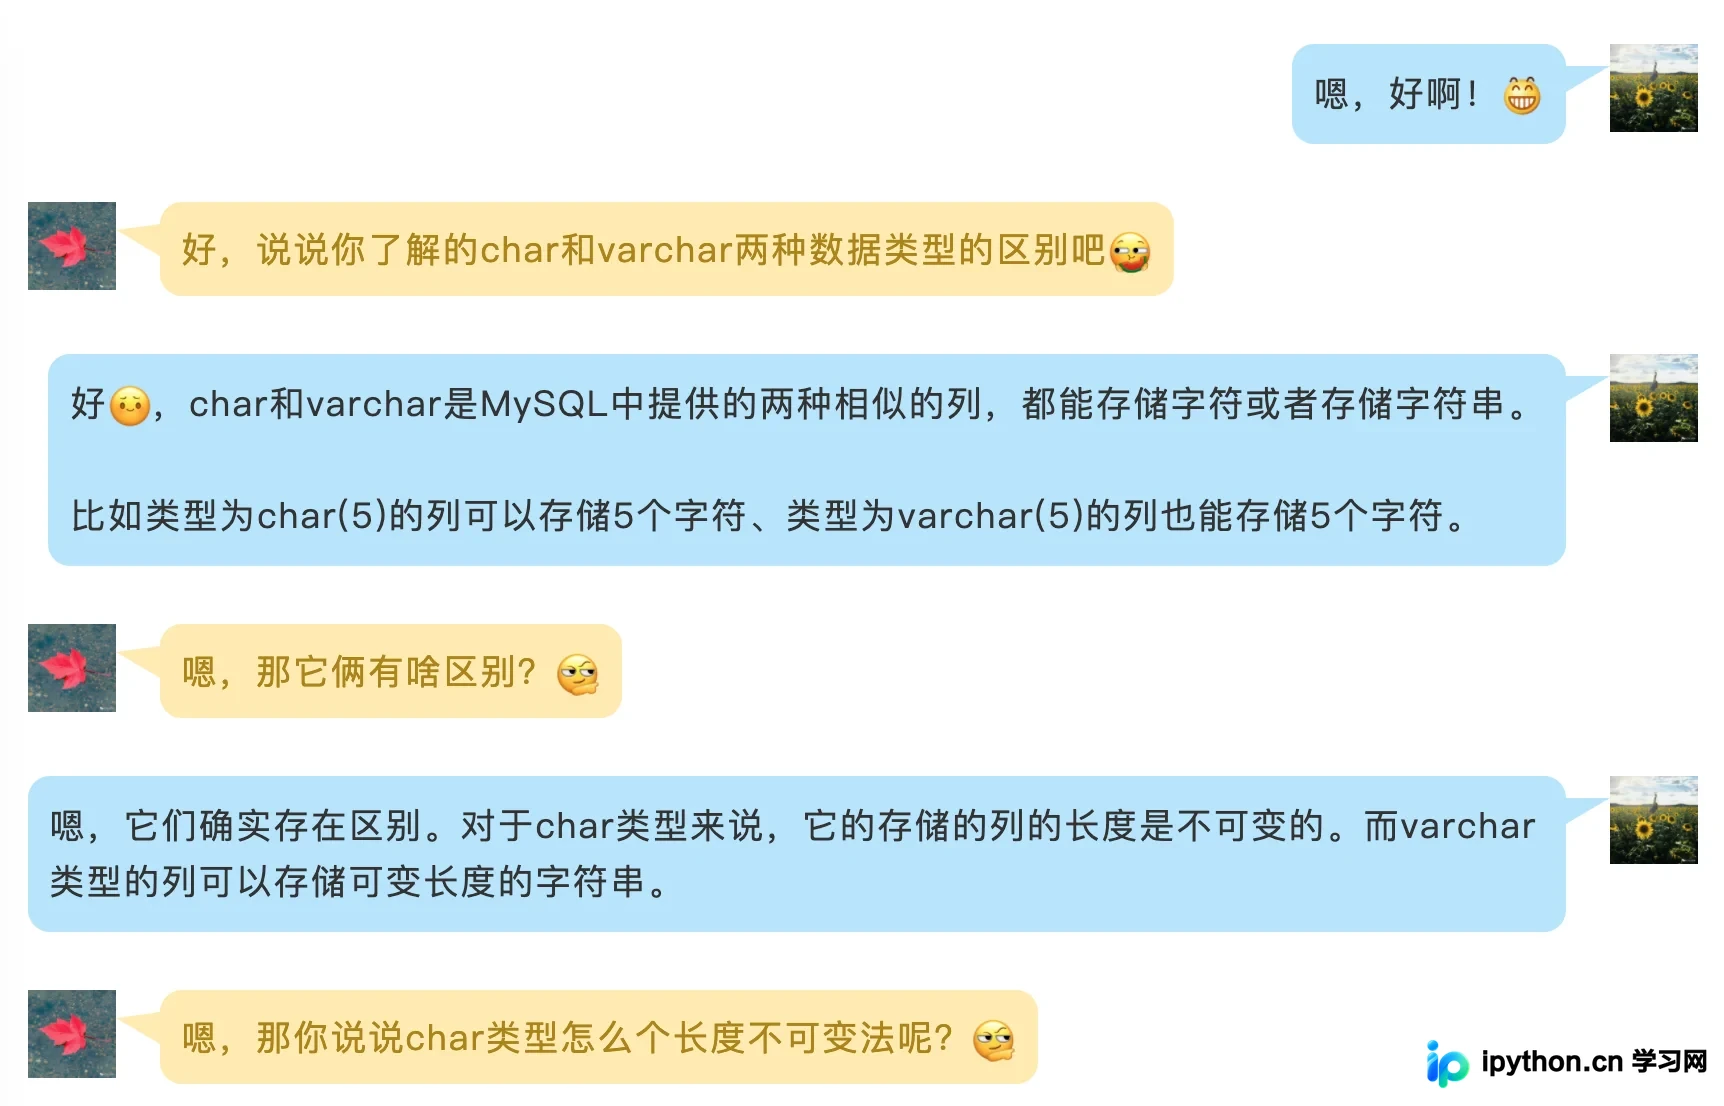
在MySQL中,CHAR是固定长度字符类型,不足补空格;VARCHAR是可变长度,仅存实际内容加1-2字节头信息。CHAR适合定长且短小的数据如MD5哈希,查询速度快;VARCHAR适合不定长文本以节省空间。合理选择能显著提升存储空间利用率与I/O效率,避免不必要的资源浪费。
MySQL 自增主键出现断号是常见现象,主要由唯一键冲突、事务回滚及批量插入策略导致。InnoDB 引擎将自增值保留在内存中,插入失败或事务回滚时已分配的 ID 不会复用;批量写入时更会成倍预分配 ID。理解这一机制有助于合理设计数据库结构。
当MySQL Slave节点的Slave_SQL_Running状态为No导致主从不同步时,可根据数据一致性要求选择不同修复方案。若业务允许短暂数据差异,可通过设置sql_slave_skip_counter跳过报错语句快速恢复;若需严格数据一致,则需锁定主库、备份并重置从库同步点(CHANGE MASTER TO),重新建立复制链路。
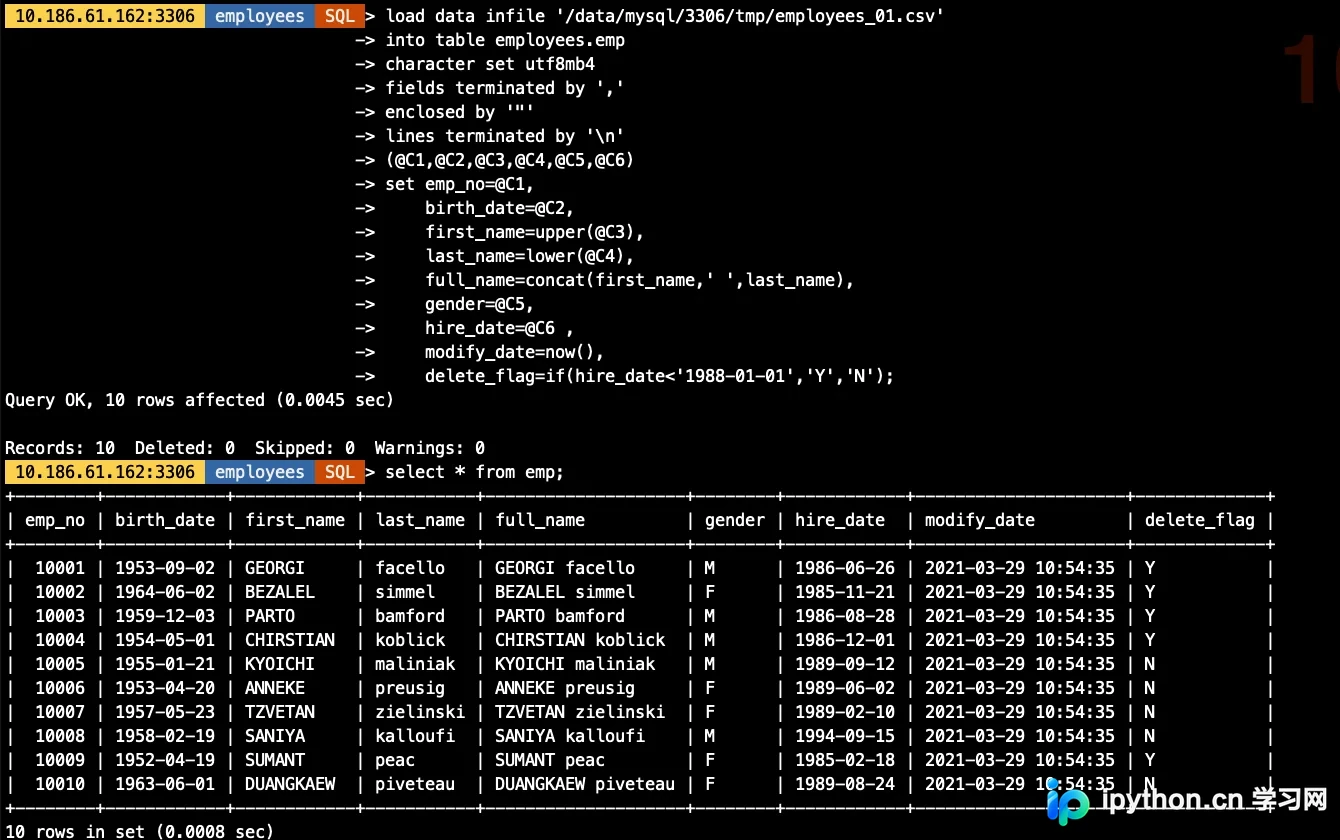
本文详解MySQL Shell中Parallel Table Import Utility(import_table)的使用。该工具支持8.0.23及以上版本,具备并发导入、多文件通配符匹配、限速及压缩文件处理等核心功能。通过具体代码示例,展示如何利用decodeColumns实现字段映射、函数处理及逻辑判断,并与传统LOAD DATA INFILE进行性能对比,证明其在大数据量导入场景下的显著效率优势。
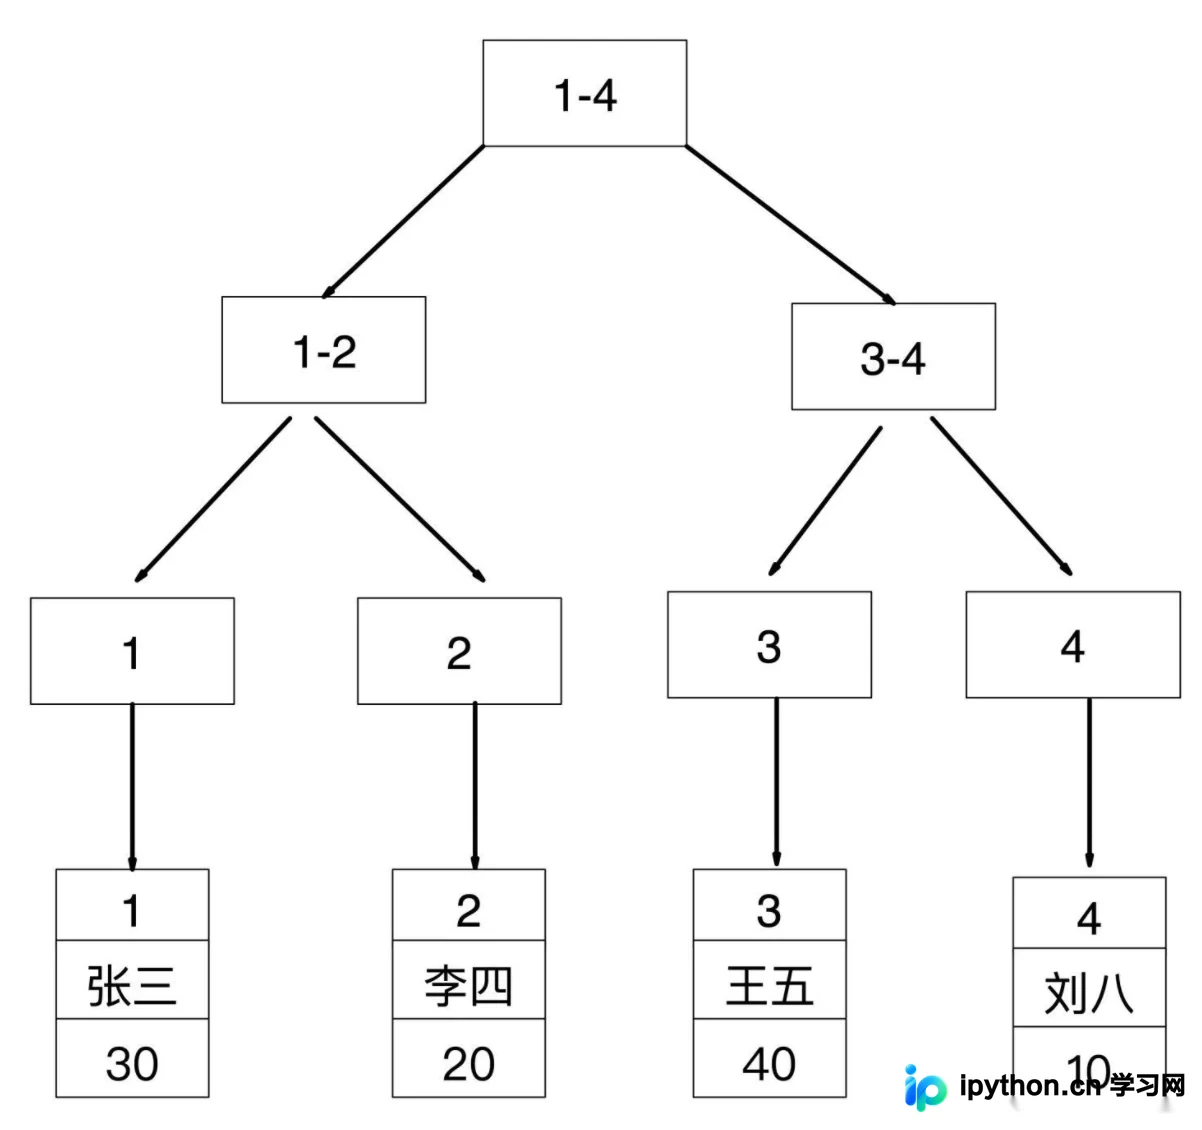
本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
本文详细对比MySQL常用存储引擎InnoDB与MyISAM的核心特性。重点分析两者在并发控制(行锁vs表锁)、事务支持、外键约束及索引类型上的差异,帮助开发者根据业务场景选择最适合的存储引擎以优化数据库性能。