Python高效处理大文件的方法详解
本文深入解析Python处理大型数据集的性能优化方案。通过对比串行处理、多进程池(multiprocessing)、joblib并行处理及批处理技术,展示如何显著缩短280万行数据的清洗耗时。重点介绍利用tqdm实现可视化进度监控,并提供从基础到高级的并行处理代码示例与性能数据对比。
2026-10-16
0



本文深入解析Python处理大型数据集的性能优化方案。通过对比串行处理、多进程池(multiprocessing)、joblib并行处理及批处理技术,展示如何显著缩短280万行数据的清洗耗时。重点介绍利用tqdm实现可视化进度监控,并提供从基础到高级的并行处理代码示例与性能数据对比。
本文详细介绍在 C# WinForm 应用程序中,如何通过 DataSet、TableAdapter 和 BindingSource 将 SQL Server 数据库表数据绑定到 DataGridView 控件。涵盖从创建数据集、配置 TableAdapter 连接指定表,到界面拖拽组件完成可视化绑定,以及编写 Load 事件加载数据和按钮点击执行 UpdateAll 保存修改的完整流程。
本文介绍了五个使用Python进行数据清理的实用脚本,涵盖从PDF提取表格、合并多个CSV文件、删除重复行、拆分列以及合并不同数据集等常见场景。通过Pandas库实现自动化处理,显著提升机器学习前的数据准备效率,适用于Tableau等可视化工具及各类模型训练前的数据预处理环节。
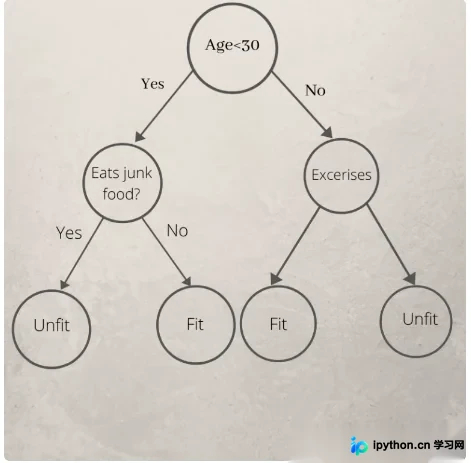
本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
本文详细讲解如何在R语言中实现前向逐步回归算法进行特征选择。通过构建自定义函数,从空集开始迭代添加对模型RMSE贡献最大的变量,最终筛选出最优子集。文章包含数据预处理、核心逻辑实现及基于可视化指标的效果评估全流程。
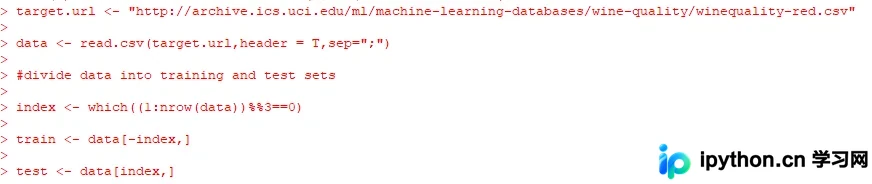
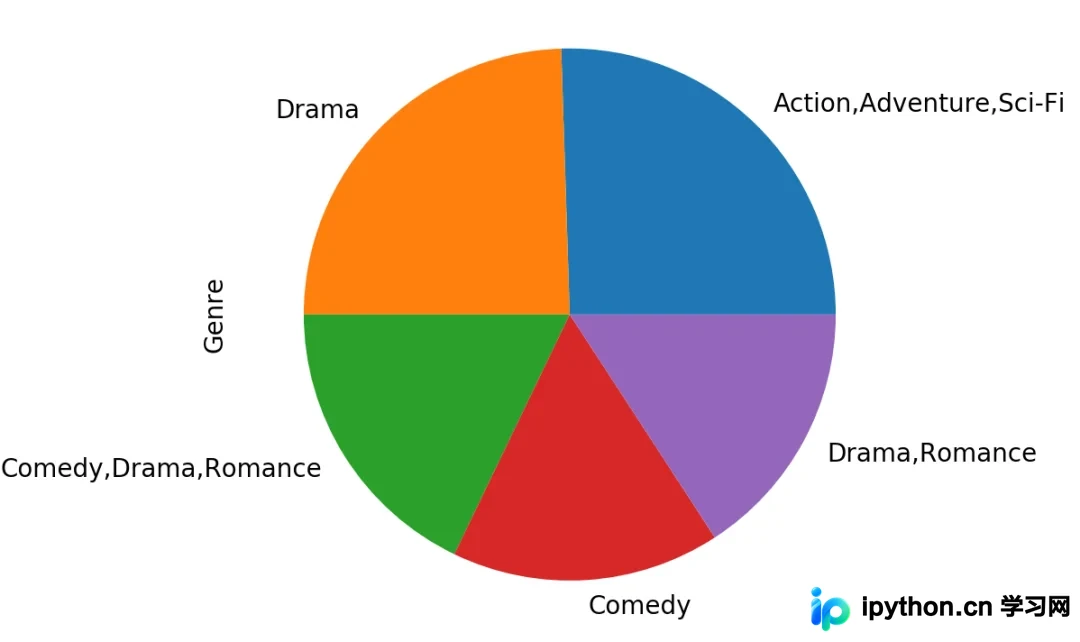
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。
本文深入解析Python中scipy.optimize.curve_fit函数的用法,对比其与numpy polyfit在拟合范围上的差异。通过二次多项式拟合示例,展示如何定义目标函数、获取拟合参数a,b,c及协方差矩阵,并演示利用拟合结果进行数据预测与可视化绘图,帮助开发者掌握更灵活的数据建模技巧。

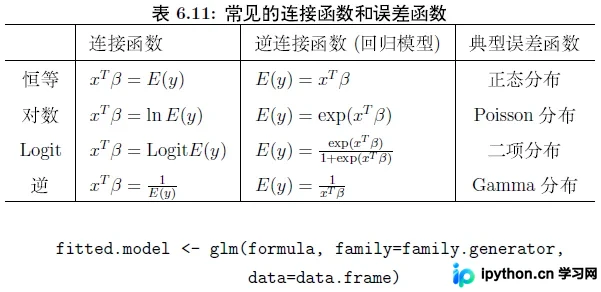
本文介绍如何使用R语言的glm()函数拟合广义线性模型(GLM)。通过解析family参数中的正态分布与二项分布,重点演示了Logistic回归在二元分类问题中的应用。结合电流对动物影响的实际案例,展示了数据准备、模型构建、预测概率计算及可视化绘制的完整流程。
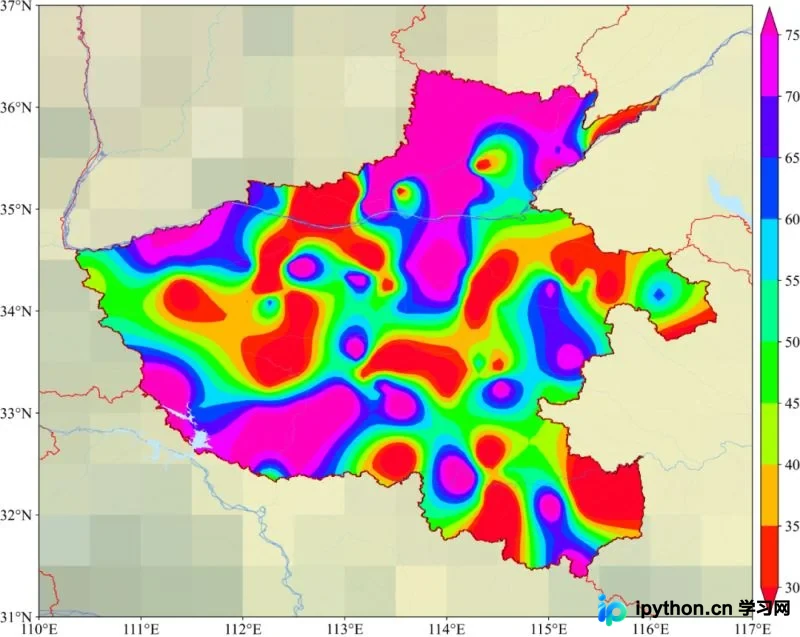
本文介绍如何使用Python的Cartopy库绘制具有Matlab风格的地图边框。内容涵盖色斑图绘制、经纬度插值、比例尺与指南针的添加方法,以及自定义边框样式的实现。通过具体代码示例,展示如何配置字体、处理地理数据并生成高清地图输出,适用于地理信息可视化需求。
本文以某地1958-2021年降水量数据为例,使用R语言进行时间序列建模。通过时序图、自相关图及Ljung-Box检验判断序列平稳性与纯随机性,利用auto.arima自动定阶选择最优MA(1)模型,完成参数估计与残差诊断后,对未来5年降水趋势进行可视化预测。
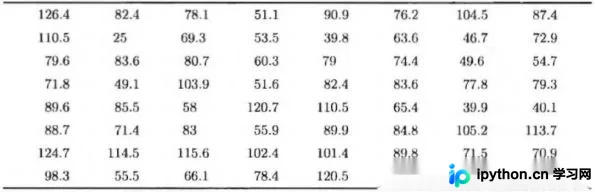
本文详细介绍如何使用Python实现梯度下降法进行线性回归。内容涵盖数据读取、参数初始化、均方误差代价函数的定义与求导,以及通过迭代更新斜率和截距的核心算法。附带完整Python代码及多轮迭代可视化结果,帮助开发者理解梯度下降原理并应用于实际模型训练。
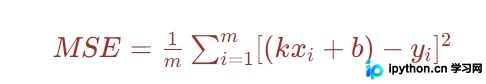
本文详解R语言中多元线性回归的实现流程。首先使用内置数据集进行探索性分析,通过`cor()`函数和散点矩阵图检查多重共线性。接着利用`lm()`函数构建基础模型,观察显著性与拟合优度。最后引入交互项并结合`mtcars`数据集优化模型,通过可视化手段筛选最佳拟合参数,解决单一变量解释力不足的问题。