


R语言实现前向逐步回归:从原理到代码落地

前向逐步回归是一种常用的特征选择方法。本文将深入解析其工作原理,并提供在R语言中从零实现该算法的完整代码与步骤说明,包括数据划分、迭代筛选特征以及结果可视化评估。
前向逐步回归的工作原理
前向逐步回归(Forward Stepwise Regression)的核心思想是“贪心”策略。它不是一次性尝试所有可能的特征组合,而是从空集开始,每次只增加一个最能提升模型性能的变量。具体流程如下:
- 初始化:初始特征集合为空。
- 遍历候选:对于每一个尚未加入集合的特征,单独或组合当前已选特征训练模型。
- 择优录取:选择在测试集上误差最小(如RMSE最低)的那个新特征,将其添加到当前特征集合中。
- 循环终止:当没有新的特征能带来显著改善,或达到预设的最大特征数量时,停止迭代。
这种方法相比穷举法极大地减少了计算量,同时能有效剔除无关噪声变量。
第一阶段:数据导入与预处理
在进行建模之前,首先需要将原始数据划分为训练集和测试集,并将特征矩阵(X)与目标标签(y)分离,以便后续进行独立的模型拟合与评估。
第1步:读取数据并划分数据集
通常使用70%的数据作为训练集来寻找最优特征,剩余30%作为测试集用于验证模型的泛化能力。特征数据与标签数据需分别存储。
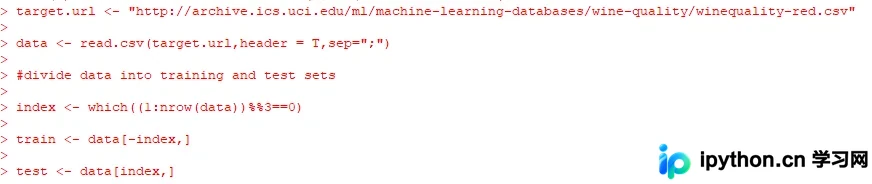
执行上述操作后,可查看划分结果。此时应确认训练集与测试集的维度符合预期,且样本比例大致为7:3。
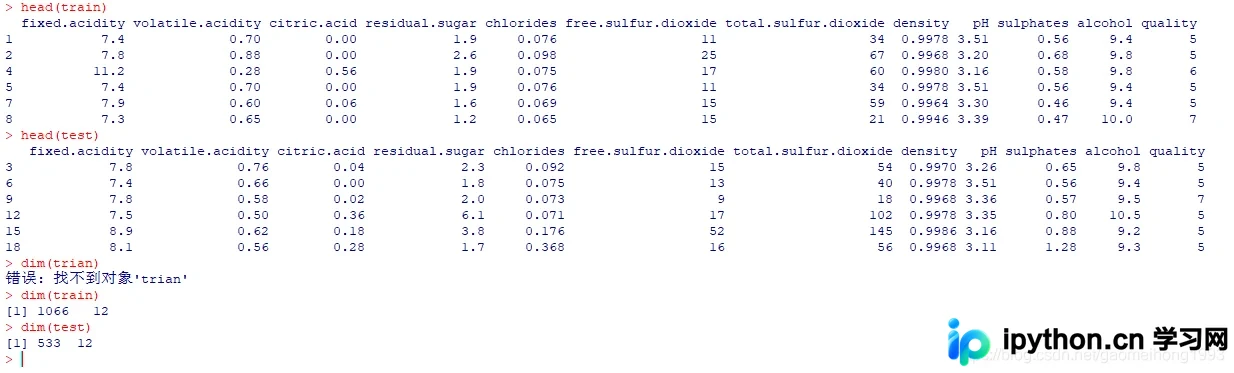
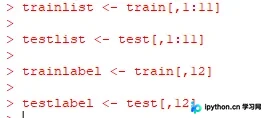
第2步:分离特征与标签
为了便于调用`lm`函数进行线性回归分析,需将目标变量从数据框中移除,单独存放。同时保存各列名称,以便后续输出特征名称列表。
第二阶段:构建前向回归核心逻辑
R语言本身并未直接提供通用的前向逐步回归包供用户轻松定制,因此我们需要编写一个自定义函数来实现这一过程。核心在于通过`for`循环控制迭代次数,并在每次迭代中寻找最优特征。
第3步:实现迭代特征选择函数
该函数的输入为完整的特征矩阵、标签向量以及预定义的测试集数据。算法启动时,`best_features`参数初始化为空向量,表示开始时没有任何特征被选中。
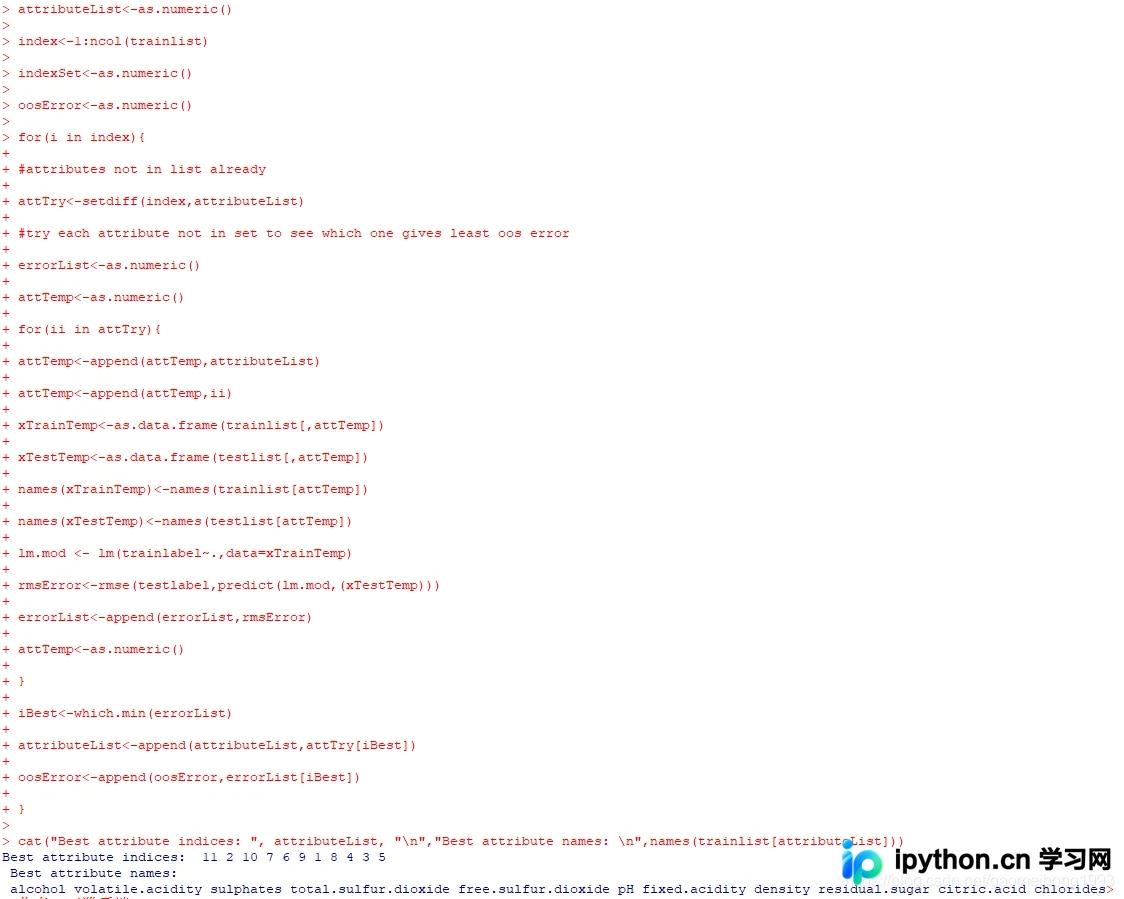
代码逻辑解析:
- 循环结构: 外层循环控制需要选入多少个特征(由用户指定或通过交叉验证确定)。
- 内层遍历: 每次循环遍历所有未入选的特征。
- 模型评估: 临时构建包含当前`best_features`加上新候选特征的公式,利用训练数据拟合线性模型(`lm`),并计算在测试集上的预测误差(通常使用均方根误差RMSE)。
- 更新最优解: 比较所有候选特征带来的误差大小,选择使误差最小的那个特征索引,永久加入`best_features`。
第三阶段:模型效果评估与可视化
特征选择完成后,需要通过量化指标和图表来判断选择出的特征子集是否合理。主要关注三个维度:误差随特征数量的变化、残差分布形态以及预测值与真实值的吻合度。
第4步:生成评估指标图
我们需要绘制以下三组关键图表以全面评估模型性能:
- RMSE vs 特征个数: 观察随着特征增加,误差是否呈现下降趋势。如果曲线趋于平缓,说明增加了冗余特征,应停止选择。
- 预测误差直方图: 检查残差是否符合正态分布,判断模型是否存在系统性偏差。
- 散点图 (真实值 vs 预测值): 数据点越贴近$y=x$直线,说明模型拟合效果越好。
在R语言中可使用基础绘图功能或ggplot2包实现这些可视化。以下是结合前文逻辑生成的多幅对比图示例:

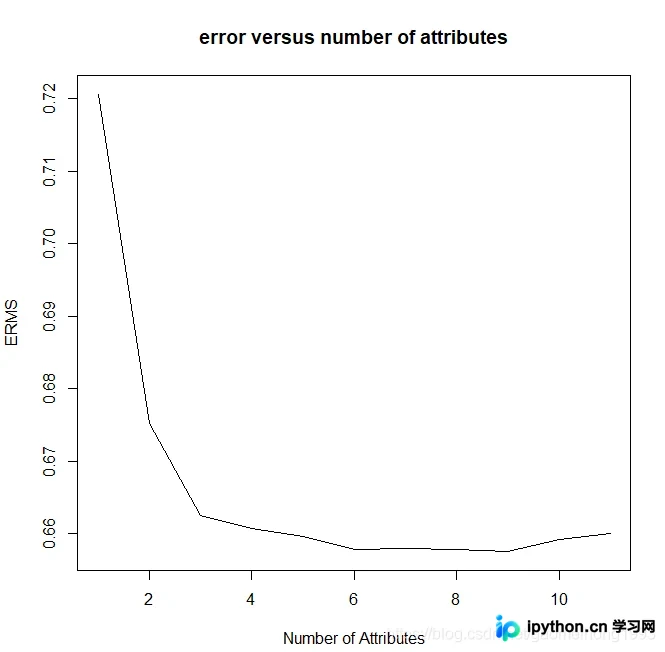
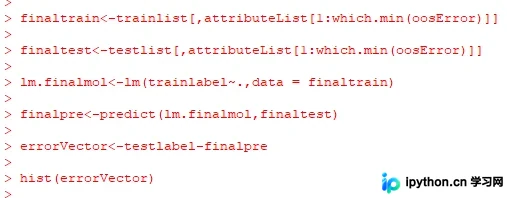
上图展示了不同阶段下各项指标的变化情况。值得注意的是,如果在增加特定数量特征后,RMSE不再显著下降,或者残差分布出现明显的长尾,可能需要重新调整正则化参数或考虑其他非线性模型。
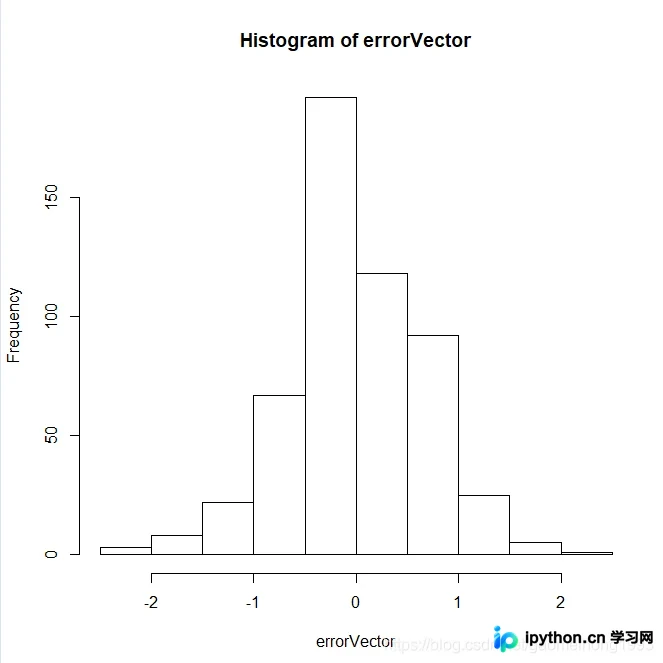

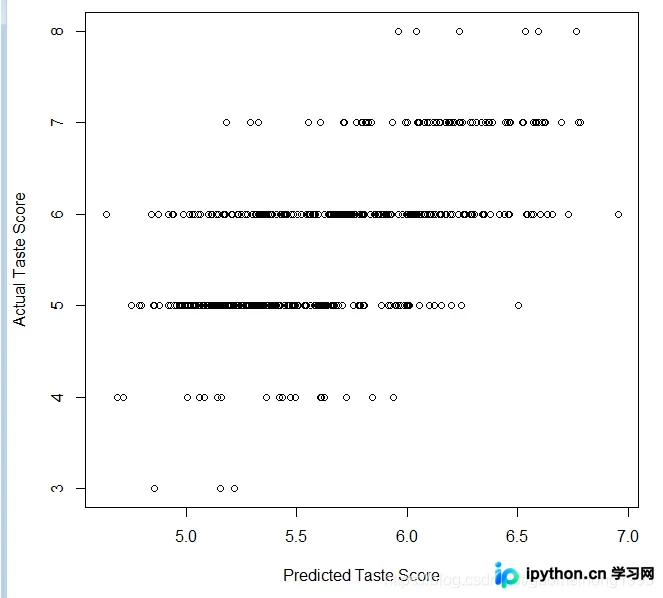
通过上述可视化结果,我们可以清晰地看到特征选择的过程以及对模型精度的影响。最终输出的特征列表即为前向逐步回归得到的最优子集。
以上就是R语言实现前向逐步回归的详细内容,更多关于R语言 前向逐步回归的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















