


Python实现梯度下降法线性回归完整教程

本文详细介绍如何使用Python实现梯度下降法进行线性回归。内容涵盖数据读取、参数初始化、均方误差代价函数的定义与求导,以及通过迭代更新斜率和截距的核心算法。附带完整Python代码及多轮迭代可视化结果,帮助开发者理解梯度下降原理并应用于实际模型训练。
1.首先读取数据集
导入必要的Python库并加载数据。用户需自行准备数据文件,确保数据包含两列,分别对应自变量x和因变量y即可。
import numpy as np
import matplotlib.pyplot as plt

data = np.loadtxt("data.csv", delimiter=",")

x_data = data[:, 0]
y_data = data[:, 1]
2.初始化相关参数
# 初始化 学习率 即每次梯度下降时的步长 这里设置为0.0001
learning_rate = 0.0001

# 初始化 截距b 与 斜率k
b = 0
k = 0

# 初始化最大迭代的次数 以50次为例
n_iterables = 50
3.定义计算代价函数–>MSE
采用均方误差(MSE,Mean Square Error)作为模型性能的评估标准。
假设数据集中共有m个样本,则均方误差的计算公式如下:
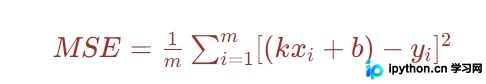
将该公式定义为代价函数。为了方便后续求导计算,在原始MSE的基础上乘以1/2。
def compute_mse(b,  k,  x_data, y_data):
    total_error = 0
    for i in range(len(x_data)):
        total_error += (y_data[i] - (k * x_data[i] + b)) ** 2

    # 为方便求导:乘以1/2
    mse_ = total_error / len(x_data) / 2
    return mse_
4.梯度下降
分别对乘以1/2后的MSE表达式关于斜率k和截距b求偏导数,
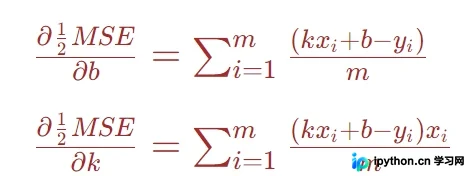
在更新b和k时,使用当前的b、k值分别减去对应偏导数与学习率的乘积。关于为何使用减号,可以这样理解:以斜率k为例,当其偏导数大于零时,表明均方误差随斜率增大而增大,为了使误差减小,应减小斜率;反之,若偏导数小于零,则应增大斜率。此外,由于导数衡量的是均方误差的变化而非参数本身的变化,因此引入学习率来调节偏导数与学习率乘积的大小,从而控制截距和斜率的更新步长。
def gradient_descent(x_data, y_data, b,  k,  learning_rate,  n_iterables):
    m = len(x_data)
    # 迭代
    for i in range(n_iterables):
        # 初始化b、k的偏导
        b_grad = 0
        k_grad = 0

        # 遍历m次
        for j in range(m):
            # 对b,k求偏导
            b_grad += (1 / m) * ((k * x_data[j] + b) - y_data[j])
            k_grad += (1 / m) * ((k * x_data[j] + b) - y_data[j]) * x_data[j]

        # 更新 b 和 k  减去偏导乘以学习率
        b = b - (learning_rate * b_grad)
        k = k - (learning_rate * k_grad)
        # 每迭代 5 次  输出一次图形
        if i % 5 == 0:
            print(f"当前第{i}次迭代")
            print("b_gard:", b_grad, "k_gard:", k_grad)
            print("b:", b, "k:", k)
            plt.scatter(x_data, y_data, color="maroon", marker="x")
            plt.plot(x_data, k * x_data + b)
            plt.show()
    return b, k
5.执行
print(f"开始:截距b={b},斜率k={k},损失={compute_mse(b,k,x_data,y_data)}")
print("开始迭代")
b, k = gradient_descent(x_data, y_data, b, k, learning_rate, n_iterables)
print(f"迭代{n_iterables}次后:截距b={b},斜率k={k},损失={compute_mse(b,k,x_data,y_data)}")
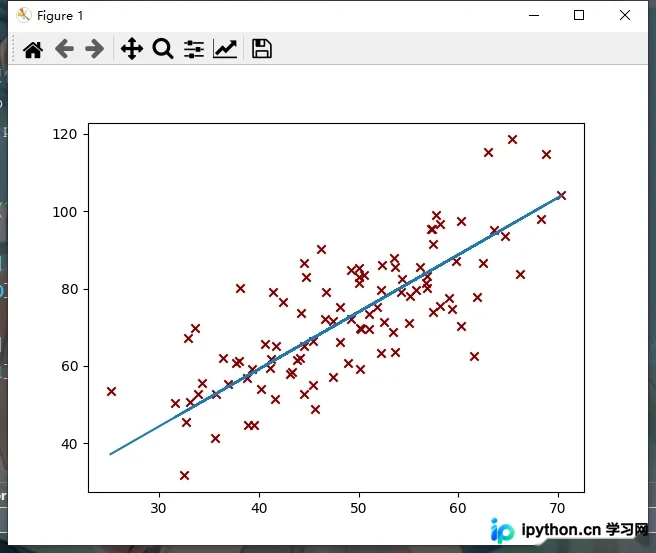
代码运行过程中生成了一系列图像,部分结果如下图所示。随着迭代次数增加,代价函数逐渐减小,最终达到预期效果,具体表现如下:
第5次迭代:
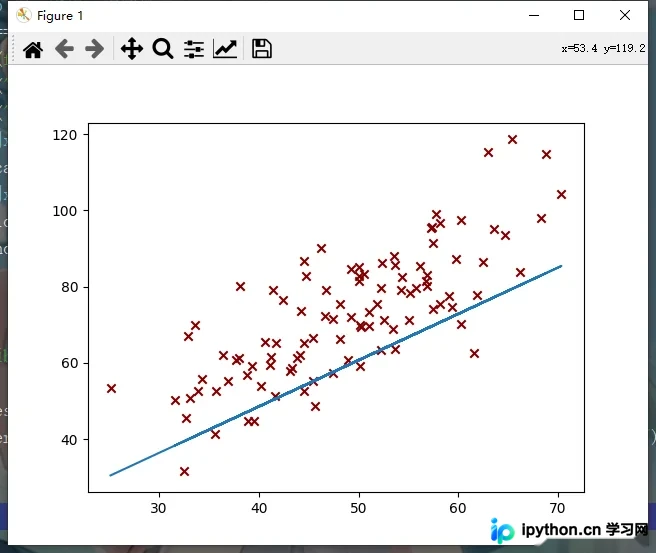
第10次迭代:
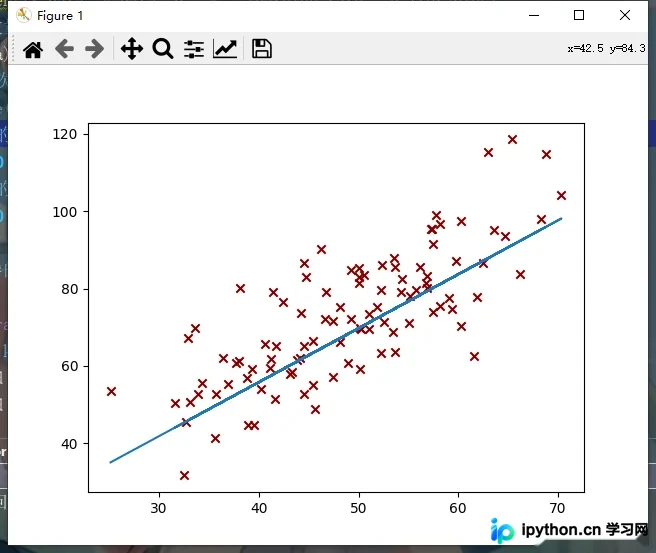
第50次迭代:
执行过程的输出结果如下图所示:
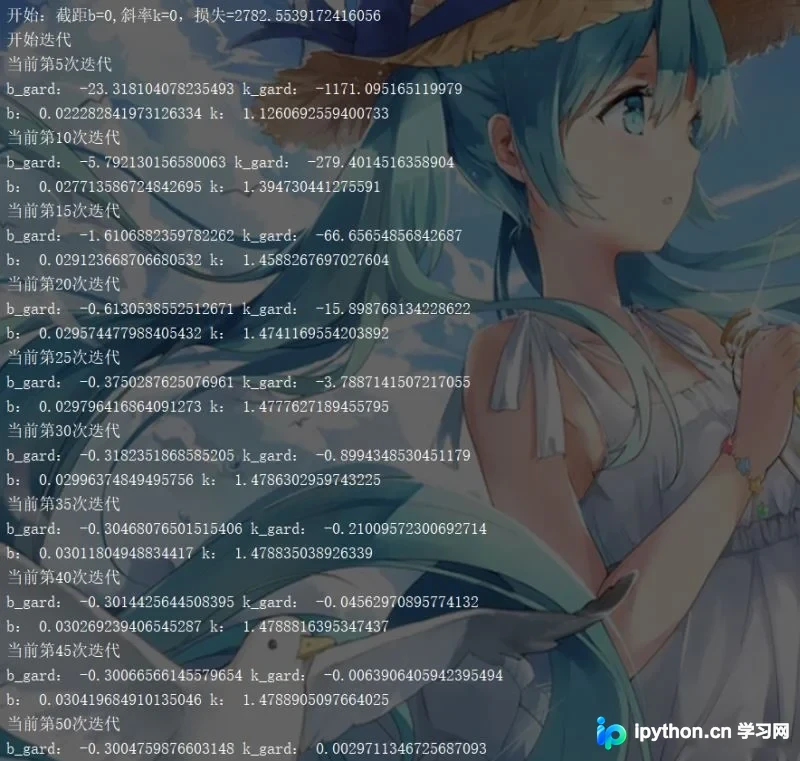
可以看出,随着偏导数逐渐趋近于零,斜率与截距的变化幅度也变得越来越小。
到此这篇关于Python实现梯度下降法的示例代码的文章就介绍到这了,更多相关Python梯度下降法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















