


Python数据处理实战:Pandas移除列、统计词数与频次分析

发布时间:2026-10-16 |
4人浏览过
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。
首先确认当前使用的Pandas库版本,并导入该库以便后续操作。
>>> import pandas as pd
>>> pd.__version__
'0.25.1'
在开始处理之前,需确保Python解释器的工作目录与数据集存放目录一致。
>>> import os
>>> os.chdir('D://source/dataset') # 这是我的数据集所在目录
>>> os.listdir() # 确认此目录已经存在 IMDB-Movie-Data 数据集
['drinksbycountry.csv', 'IMDB-Movie-Data.csv', 'movietweetings', 'titanic_eda_data.csv', 'titanic_train_data.csv']
完成上述环境准备后,即可开始进行具体的数据处理操作。
1 Pandas 移除某列
首先加载CSV格式的数据集。
>>> df = pd.read_csv("IMDB-Movie-Data.csv")
>>> df.head(1) # 导入并显示第一行
   Rank                    Title                    Genre  ...   Votes Revenue (Millions) Metascore
0     1  Guardians of the Galaxy  Action,Adventure,Sci-Fi  ...  757074             333.13      76.0

[1 rows x 12 columns]
利用pop方法可以直接移除指定的列,该方法会返回被移除的列数据。
>>> meta = df.pop("Title").to_frame() # 移除 Title 列
检查移除后的DataFrame结构,确认目标列已不存在。
>>> df.head(1) # df 变为 11列
   Rank                    Genre  ... Revenue (Millions) Metascore
0     1  Action,Adventure,Sci-Fi  ...             333.13      76.0

[1 rows x 11 columns]
2 统计标题单词数
使用pop移除Title列后,将结果转换为DataFrame并查看前3行数据。
>>> meta.head(3)
                     Title
0  Guardians of the Galaxy
1               Prometheus
2                    Split
标题字符串由单词构成,单词之间通常以空格分隔。
# .str.count(" ") + 1 得到单词个数
>>> meta["words_count"] = meta["Title"].str.count(" ") + 1
>>> meta.head(3) # words_count 列代表单词个数
                     Title  words_count
0  Guardians of the Galaxy            4
1               Prometheus            1
2                    Split            1
3 Genre 频次统计
接下来对电影Genre列进行频次统计。
>>> vc = df["Genre"].value_counts()
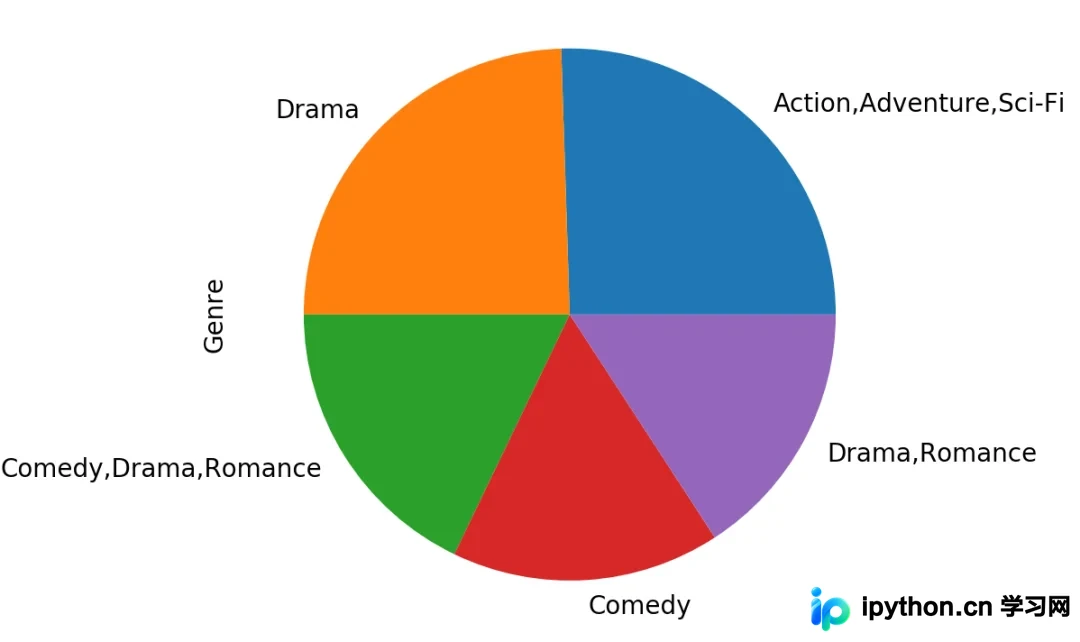
展示Genre出现频率最高的前5项,其中Action,Adventure,Sci-Fi类出现次数最多,为50次,其次是Drama类,出现48次。
>>> vc.head()
Action,Adventure,Sci-Fi    50
Drama                      48
Comedy,Drama,Romance       35
Comedy                     32
Drama,Romance              31
Name: Genre, dtype: int64
绘制Top5 Genre的饼状图以直观展示分布情况。
>>> import matplotlib.pyplot as plt
>>> vc[:5].plot(kind='pie')
<matplotlib.axes._subplots.AxesSubplot object at 0x000001D65B114948>
>>> plt.show()
以上就是关于Python数据处理三个实用技巧的分享,更多Python相关内容可参考本站往期文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















