Python实现疫情数据爬虫与可视化分析
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
2026-10-16
0



本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
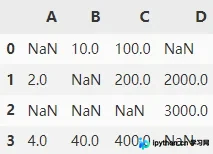
本文详解Python Pandas中缺失值的检测与处理技巧。通过info()、isnull()等方法识别NaN数据,并深入解析dropna()删除策略(axis、how、thresh、subset参数)及fillna()填充方法(直接指定、ffill/bfill前向/后向填充、limit限制)。掌握这些核心参数,高效完成数据清洗。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。
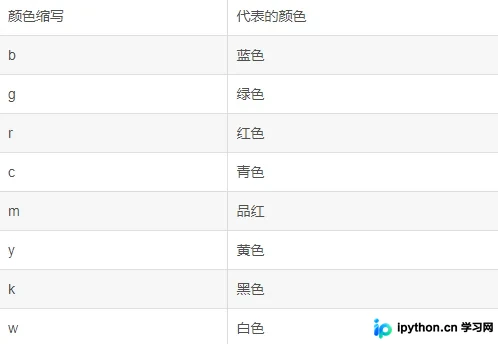
本文详细介绍使用Python Matplotlib库绘制十一种常见数据分析图表的方法,涵盖折线图、散点图、直方图、饼图、箱线图、概率图、雷达图、流向图、极坐标图、词云图及表格嵌入。通过具体代码示例与参数说明,帮助开发者快速掌握各类图表的绘制技巧与核心配置。
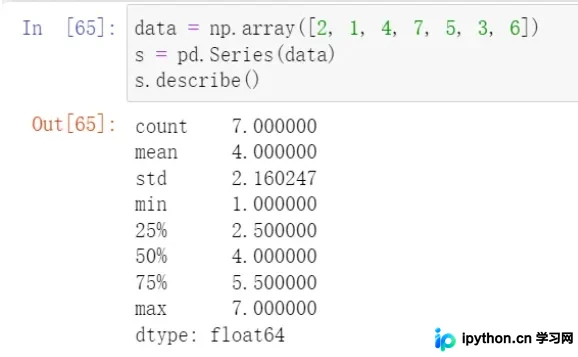
本文详细介绍Python数据分析库Pandas中Series对象的核心用法。涵盖从列表、字典及NumPy数组创建Series的方法,解析index与values等常用属性。深入讲解元素获取、修改、删除及切片操作,并演示head、tail、排序、去空等常用函数。最后通过describe统计与四则运算示例,展示Series在数据清洗与分析中的实际应用。
本文详细介绍在Python数据分析中,如何利用Pandas库对DataFrame高效应用自定义函数。重点解析apply方法按行或列处理数据、applymap方法逐元素处理数据,以及map方法在Series中的应用,通过具体代码示例展示如何替代低效的for循环,提升数据处理效率。
本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
本文介绍Python数据分析中常用的Matplotlib可视化库。通过具体代码示例,详细讲解直方图、堆叠图、饼图、散点图、箱线图及雷达图等多种图表的绘制方法。内容涵盖参数设置、中文显示处理及数据呈现技巧,帮助读者快速掌握数据可视化基础技能。
本文深入解析MySQL元数据锁(Metadata Lock)的工作原理,阐明DML操作如何自动获取共享锁,以及DDL操作所需的独占锁互斥机制。通过多事务并发场景演示,展示SELECT、UPDATE与ALTER TABLE的执行交互,指导用户如何利用performance_schema.metadata_locks视图定位因元数据锁冲突导致的SQL阻塞问题,确保数据库结构与数据操作的安全性与一致性。
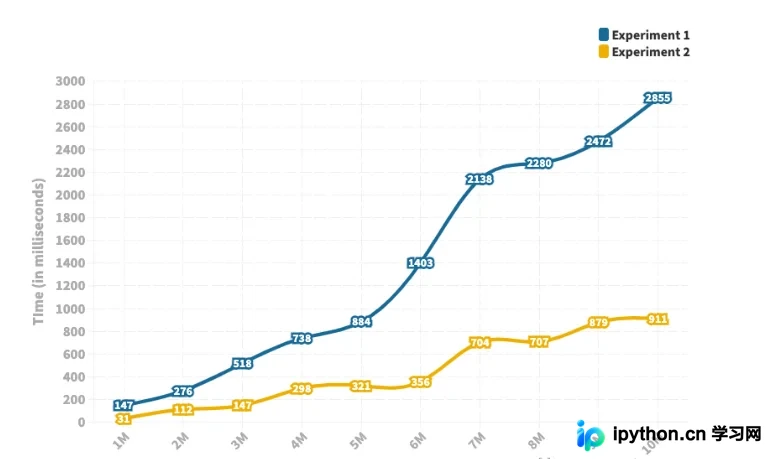
本文深入对比Pandas中Merge、Join和Concat三种数据合并方法的执行效率。通过从100万至1000万行的实验数据发现,Join操作在处理大规模数据时耗时显著低于Merge,且随数据量增长线性增加的速度更慢。建议处理海量数据时优先使用Join以提升性能。
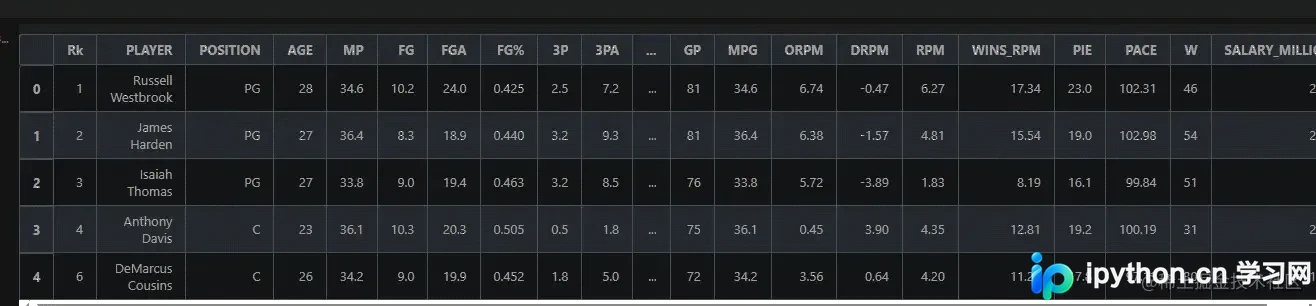
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
本文详解Pandas中groupby的核心用法,涵盖单列与多列分组、多种聚合函数应用及自定义聚合。通过遍历groupby对象深入理解执行流程,并结合北京天气数据实例,演示如何计算月度最高温、均质指数等统计指标,帮助开发者掌握高效的数据分组处理技巧。



