


使用Seaborn进行NBA球员数据可视化与相关性分析

发布时间:2026-10-16 |
4人浏览过
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
本案例基于Jupyter Notebook环境进行演示,选取NBA球员信息数据集作为分析对象,旨在展示完整的数据分析流程。
1. 数据介绍
- 该数据集包含342名球员的样本,共涉及38个特征字段,数据规模表现为342行乘以38列。
- 数据集的核心信息汇总如下表所示:
| 球员姓名 | 位置 | 身高 | 体重 | 年龄 | 球龄 | 上场次数 | 场均时间 | 进攻能力 | 防守能力 | 是否入选过全明星 | 球员薪金 |
|---|
- 此数据集适用于数据处理、数据挖掘以及数据可视化等应用场景。
- 本节将对NBA球员数据集执行初步的统计学分析,并绘制相关性热力图以展示变量间的关系。
2. 案例演示
2.1 获取数据
首先导入必要的Python库,并执行以下代码以加载本地数据集。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# 获取数据集
NBA = pd.read_csv("nba_2017_nba_players_with_salary.csv")
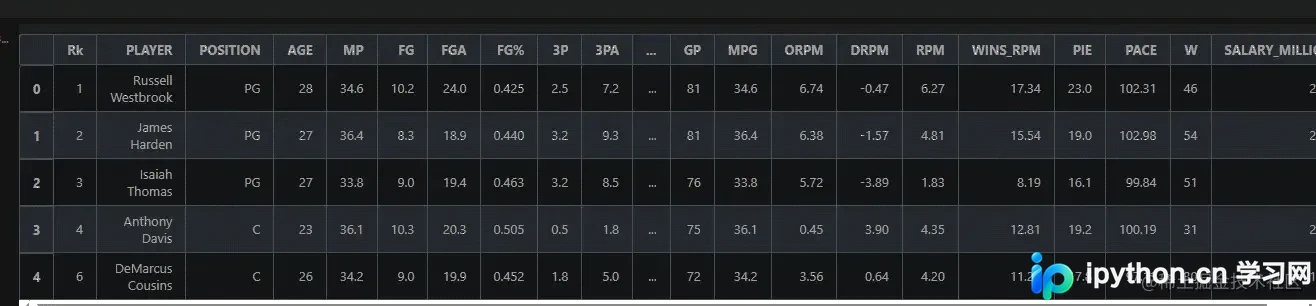
NBA.head()
代码运行后的输出结果如下:
2.2 查看数据基本信息
首先进行基础的统计学分析,通过查看标准差、中位数、方差等指标来了解数据分布情况。
# 看一下数据有多少
NBA.shape
# 查看基本统计信息
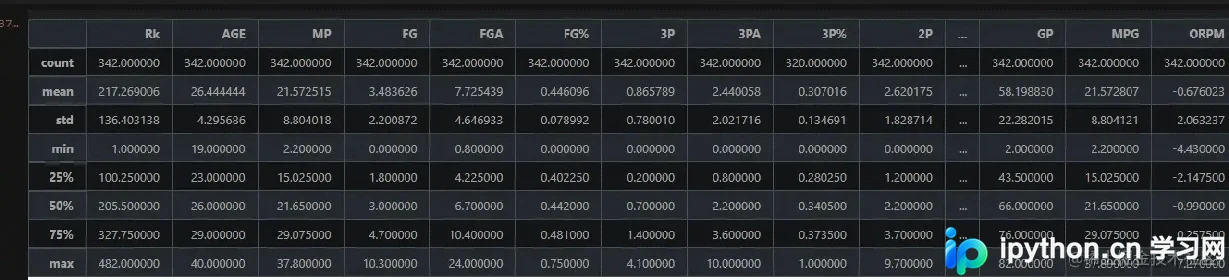
NBA.describe()
部分运行结果展示如下:
2.3 数据分析
2.3.1 效率值相关性分析
在诸多数据指标中,RPM(Real Plus-Minus)代表球员的效率值,该指标反映了球员在场时对球队获胜的贡献度,是衡量球员综合实力的关键数据。我们可以进一步分析该指标与其他数据的相关性。
首先,选取几个具有代表性的特征进行分析,并绘制热力图以直观展示关系。
# 2. 数据分析
## 2.1 效率值相关性分析
NBA_1 = NBA.loc[:, ['RPM','AGE','SALARY_MILLIONS','ORB','DRB','TRB','AST','AST','STL','BLK','TOV','PF','POINTS','GP','MPG','ORPM','DRPM']]
NBA_1.head()
随后,使用以下代码计算具体的相关性数值表。
# 计算相关性
# 获取两列之间的相关性
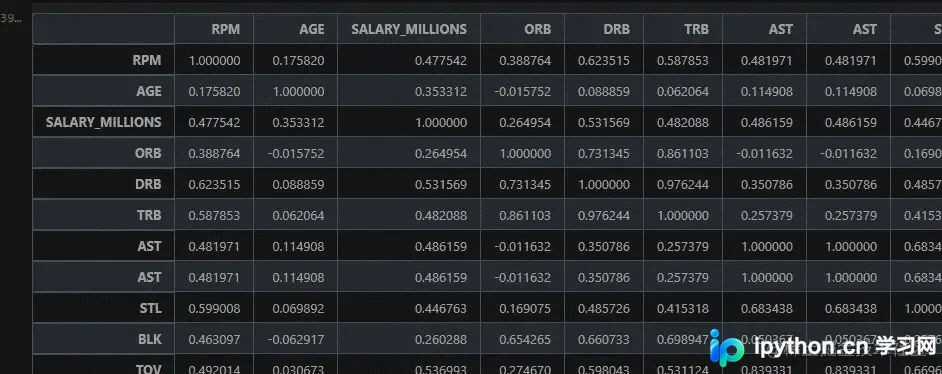
corr = NBA_1.corr()
corr
部分运行结果如下图所示:
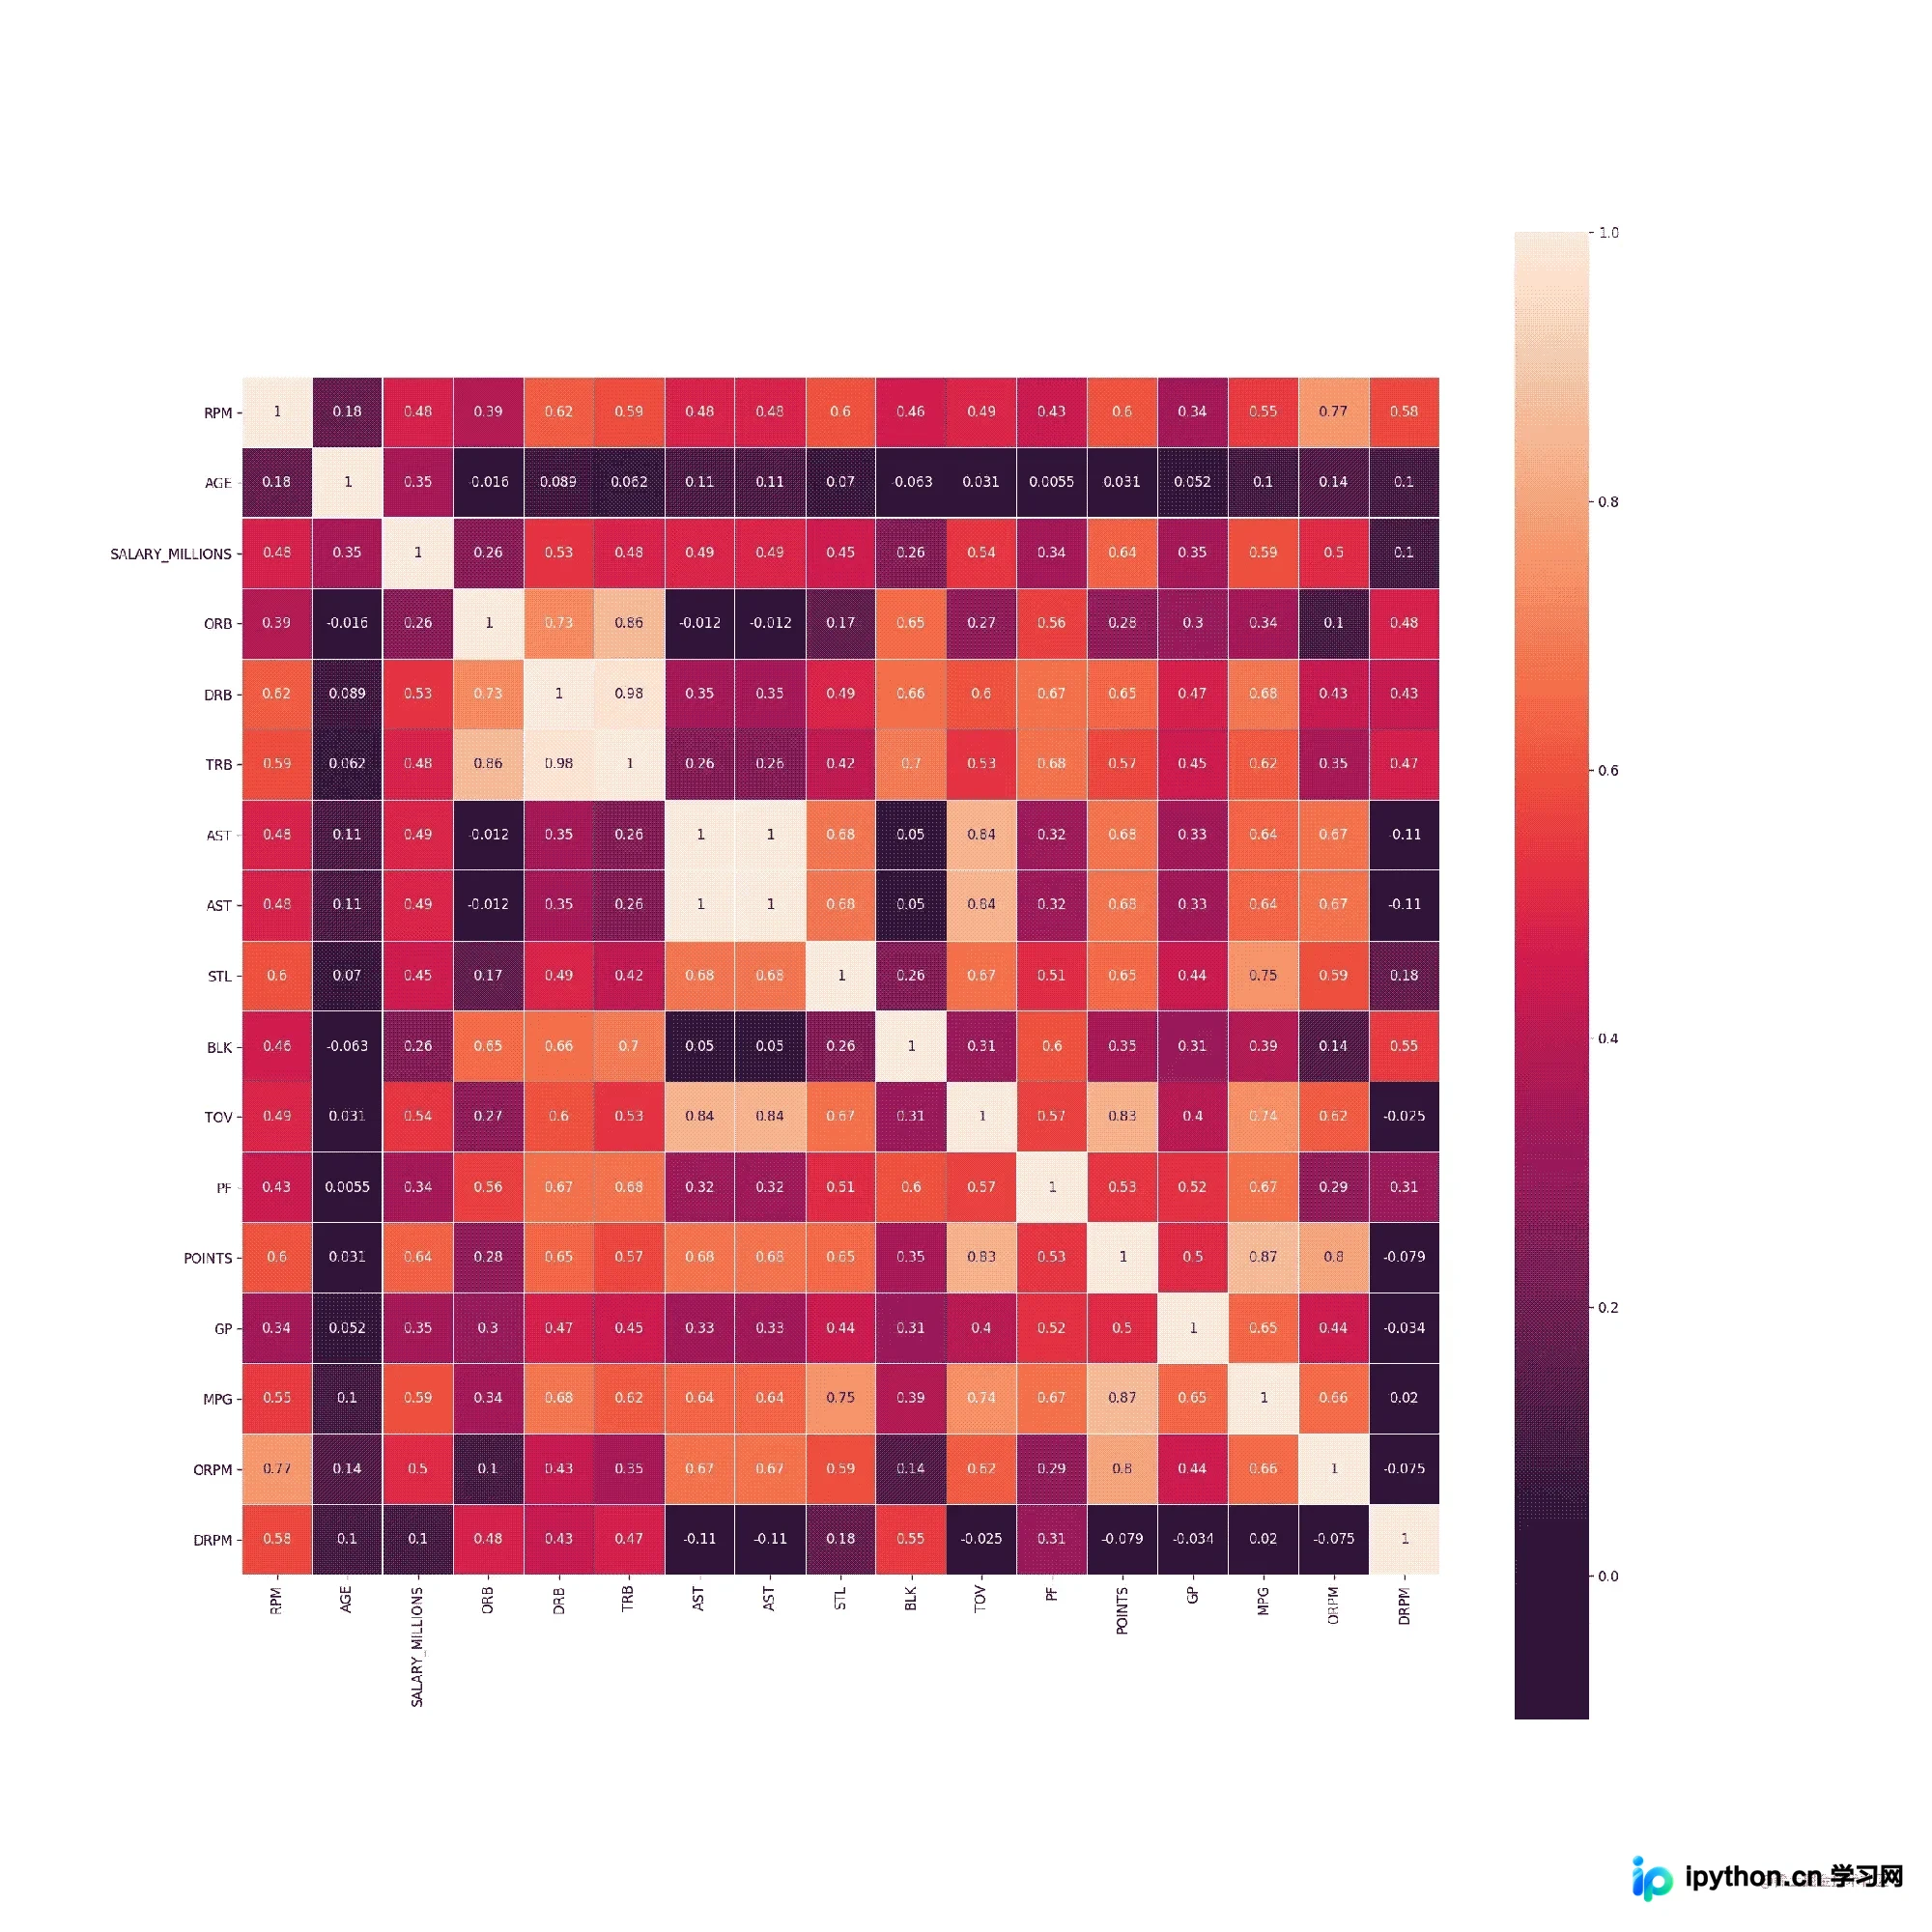
最后,利用前述计算得到的相关性表,绘制相关性关系热力图。
# 调用热力图绘制相关性关系
plt.figure(figsize=(20,20),dpi=120)
sns.heatmap(corr, square=True, linewidths=0.1, annot=True)
# 保存图像
plt.savefig("./test.png")
# 颜色越深:相关性越弱
# 颜色越浅:相关性越强
运行结果如下图所示:
以上即为使用Seaborn对NBA球员信息数据集进行数据分析的完整内容,更多相关技术资料请参阅本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















