


Python数据分析之缺失值检测与处理详解

本文详解Python Pandas中缺失值的检测与处理技巧。通过info()、isnull()等方法识别NaN数据,并深入解析dropna()删除策略(axis、how、thresh、subset参数)及fillna()填充方法(直接指定、ffill/bfill前向/后向填充、limit限制)。掌握这些核心参数,高效完成数据清洗。
检测缺失值
首先,我们需要构建一个包含缺失值的数据框来演示后续操作(DataFrame)。
import pandas as pd

df = pd.DataFrame(
    {'A': [None, 2, None, 4],
     'B': [10, None, None, 40],
     'C': [100, 200, None, 400],
     'D': [None, 2000, 3000, None]})
df
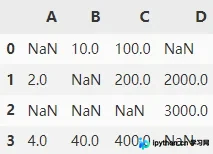
在数值型数据中,Pandas将缺失值统一标识为 NaN(Not A Number)。接下来我们将介绍如何快速定位数据框中存在缺失值的列或行。
1. 使用 info() 方法
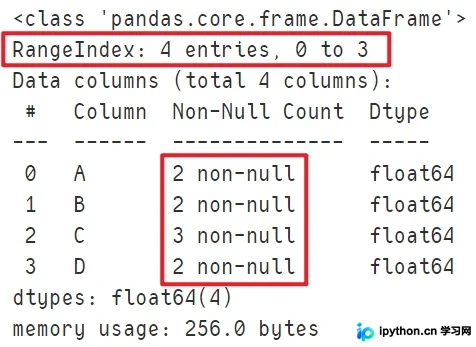
调用 info() 后,重点检查每一列对应的 Non-Null Count(非空计数)是否与 RangeIndex(索引范围总数)一致。若两者不相等,则说明该列存在缺失值。
2. 使用 isnull() 方法
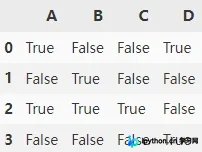
isnull() 会返回一个与原 DataFrame 维度完全一致的数据框,其中每个位置的值表示该单元格是否为缺失值。
df.isnull()
结合 sum() 函数,可以统计每一列中缺失值的总数量。
df.isnull().sum()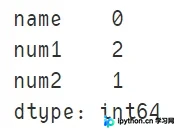
利用 .T 属性对 DataFrame 进行转置,随后再次使用 sum(),即可统计每一行中缺失值的数量。
df.isnull().T.sum()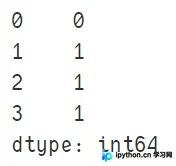
缺失值处理
删除缺失值
如果包含缺失值的行或列对分析结果影响较小,可以直接调用 dropna() 函数来移除这些含有缺失值的行或列。
df.dropna(axis=0,
          how='any',
          thresh=None,
          subset=None,
          inplace=False)
参数含义
- axis:控制操作维度的参数,0 表示按行操作,1 表示按列操作。
- how:决定删除条件的参数,设置为 any 时,只要行或列中包含任意一个 NaN 即被删除;设置为 all 时,仅当行或列中所有值均为 NaN 时才被删除。
- thresh:指定非空值的最低数量阈值,只有当非 NaN 值的数量达到该设定值时,该行或列才会被保留(反之,若未达标则被删除)。
- subset:指定参与判断的数据范围,例如在删除行时,可通过 subset 指定仅参考特定的几列,若未指定则默认检查所有列。
- inplace:控制是否直接修改原数据,设置为 True 时直接修改原数据框并返回 None,设置为 False 时返回处理后的新数据框而不修改原数据。
设置 axis = 1,表示若某列中包含缺失值,则直接删除该列。
df.dropna(axis=1, how='any')
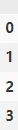
由于示例中每列都包含缺失值,执行后仅剩索引列。
设置 axis = 0(默认值),表示若某行中包含缺失值,则直接删除该行。
df.dropna(axis=0, how='any')
以 ABC 三列为参照范围,仅当这三列同时为缺失值时才删除该行。
df.dropna(axis=0, subset=['A', 'B', 'C'], how='all')
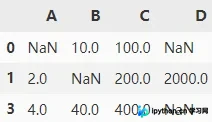
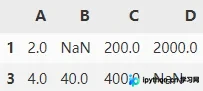
保留非 NaN 值数量至少为 3 的行。
df.dropna(axis=0, thresh=3)
填补缺失值
另一种常见的缺失值处理策略是使用 fillna() 函数进行填充。
df.fillna(value=None,
          method=None,
          axis=0,
          inplace=False,
          limit=None)
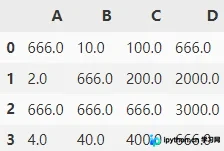
1. 直接指定填充值
df.fillna(666)
2. 使用缺失值前/后的值进行填充
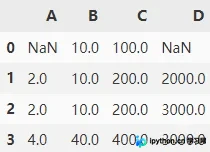
按前一个值填充
当 method 参数设置为 ffill 或 pad 时,系统将按前一个非缺失值进行填充。
当 axis = 0 时,使用缺失值所在列的上一个非缺失值进行填充;若缺失值位于第一行,则不进行填充。
当 axis = 1 时,使用缺失值所在行的上一个非缺失值进行填充;若缺失值位于第一列,则不进行填充。
df.fillna(axis=0, method='pad')
按后一个值填充
当 method 参数设置为 backfill 或 bfill 时,系统将按后一个非缺失值进行填充。
当 axis = 0 时,使用缺失值所在列的下一个非缺失值进行填充;若缺失值位于最后一行,则不进行填充。
当 axis = 1 时,使用缺失值所在行的下一个非缺失值进行填充;若缺失值位于最后一列,则不进行填充。
df.fillna(axis=0, method='bfill')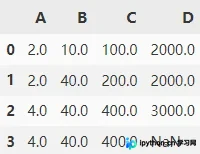
指定相应的填充方法
df.fillna(df.mean())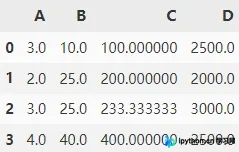
利用 limit 参数限制填充的次数。
在 ABCD 各列上,每列仅填充第一个遇到的空值。
df.fillna(value=666, axis=1, limit=1)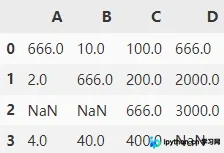
以上就是Python数据分析之缺失值检测与处理详解的详细内容,更多关于Python 缺失值检测处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















