


Python数据分析与AI开发:十大核心库详解

本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
01、Pandas
在数据分析师的日常工作中,70%到80%的时间都耗费在理解与清理数据上,这主要涉及数据探索和数据挖掘环节。
Pandas是Python中最常用的数据分析库之一,专注于数据探索、清理与分析。它提供了强大的工具集,支持加载、预处理、操作及分析各类结构化数据。
02、NumPy
NumPy的核心功能是支持N维数组,其多维数组的稳健性比Python原生列表高出50倍,因此深受众多数据科学家的青睐。
作为TensorFlow等库的底层基础,NumPy用于张量的内部计算,并提供快速预编译的数值例程函数,这些函数若手动实现则极为复杂。通过面向数组的计算方式,NumPy显著提升了处理多类别数据的效率。
03、Scikit-learn
Scikit-learn被视为Python中最重要的机器学习库。在利用Pandas或NumPy完成数据清理与处理后,开发者可使用Scikit-learn构建机器学习模型,因其内置了大量用于预测建模和分析的工具。
使用Scikit-learn具有多重优势:支持构建监督与非监督等多种机器学习模型,能够进行交叉验证以评估模型准确性,并执行特征重要性分析。
04、Gradio
Gradio仅需三行代码即可为机器学习模型构建并部署Web应用程序。其功能类似于Streamlit或Flask,但在模型部署速度与易用性上更具优势。
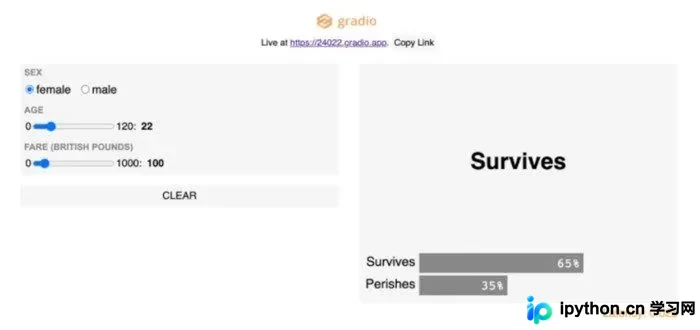
Gradio的主要优势包括:
- 支持进一步的模型验证,允许通过交互方式测试模型中的不同输入。
- 便于进行演示。
- 易于实现与分发,任何人均可通过公共链接访问Web应用程序。
05、TensorFlow
TensorFlow是Python中实现神经网络最流行的库之一。它利用多维数组(即张量)对特定输入执行多种操作。
由于其高度并行的特性,TensorFlow能够训练多个神经网络并利用GPU加速,从而构建高效且可扩展的模型。这一特性也被称为流水线处理。
06、Keras
Keras主要用于创建深度学习模型,特别是神经网络。它建立在TensorFlow和Theano之上,使得构建神经网络变得简单。然而,由于Keras通过后端基础设施生成计算图,其运行速度相比其他库相对较慢。
07、SciPy
SciPy主要提供科学函数及从NumPy派生的数学函数,涵盖统计、优化和信号处理功能。为求解微分方程并提供优化支持,它包含了用于数值积分计算的函数。SciPy的优势体现在:
- 多维图像处理能力。
- 解决傅里叶变换和微分方程的能力。
- 凭借优化算法,能够进行稳健且高效的线性代数计算。
08、Statsmodels
Statsmodels是擅长核心统计计算的库。该多功能库融合了多个Python库的功能:从Matplotlib获取图形特性与函数,进行数据处理,利用Pandas处理类似R语言的公式,使用Patsy,并基于NumPy和SciPy构建。
具体而言,它在创建OLS等统计模型以及执行统计测试方面非常有用。
09、Plotly
Plotly绝对是构建可视化的必备工具,它功能强大、易于使用,且支持交互式可视化。
与Plotly配合使用的还有Dash,这是一个利用Plotly可视化构建动态仪表板的工具。Dash作为基于Web的Python接口,解决了此类分析Web应用程序中对JavaScript的需求,并支持在线和离线状态下的绘图操作。
10、Seaborn
Seaborn建立在Matplotlib之上,是一个能够创建多种可视化效果的库。
Seaborn最重要的功能之一是创建放大的数据视觉效果,使最初不明显的相关性得以突显,帮助数据工作人员更准确地理解模型。
此外,Seaborn提供可定制的主题和界面,生成具有设计感的数据可视化效果,从而更好地辅助数据汇报。
总结
本文到此结束,希望能为读者带来帮助,也欢迎大家关注本站以获取更多相关内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















