C#异常重试:Polly实战与手动实现详解
在C#开发中,处理临时性故障的关键在于合理的重试策略。本文介绍如何利用成熟的Polly库实现快速重试、带退避的重试及熔断机制,同时提供手动实现重试模式的核心代码逻辑,帮助开发者理解底层原理并选择合适的解决方案以保障系统稳定性。
2026-10-16
0



在C#开发中,处理临时性故障的关键在于合理的重试策略。本文介绍如何利用成熟的Polly库实现快速重试、带退避的重试及熔断机制,同时提供手动实现重试模式的核心代码逻辑,帮助开发者理解底层原理并选择合适的解决方案以保障系统稳定性。
本文详细解析PHP中两种基本输出方式echo与print的差异。通过对比参数数量、返回值特性及使用性能,说明为何echo在实际开发中更受推荐。文中提供显示文本、HTML标记、变量及数组元素的完整代码实例,帮助开发者快速掌握用法。
本文介绍C#实现抢红包算法的两种核心逻辑:确保公平性的二倍均值法和适合并发场景的线段切割法。通过具体代码示例,展示如何使用Random类生成随机金额,并解决伪随机数种子重复问题。同时包含边界条件处理(如最小金额限制),适用于游戏开发或活动系统中的金额分配需求。
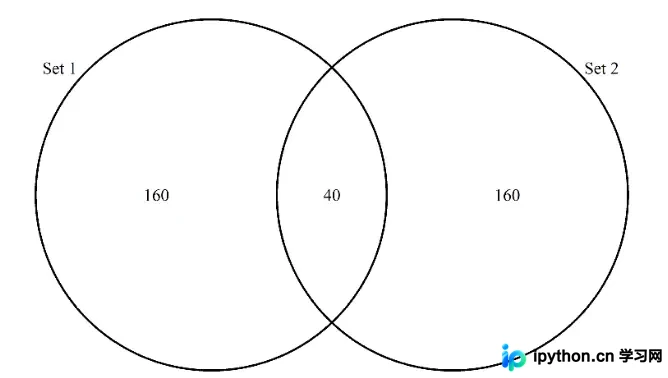
本文详细介绍如何使用R语言VennDiagram包快速绘制2至5组数据的韦恩图。涵盖从安装依赖、模拟数据集生成,到通过设置线条粗细、填充颜色、标签位置及字体等参数实现图表个性化定制的全过程。此外,还演示了如何将绘图对象保存为矢量PDF或高分辨率PNG图片,满足科研论文发表对图像清晰度的要求。
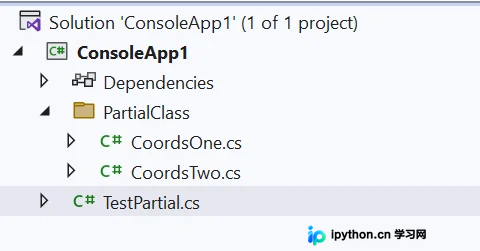
本文详细解析C#中partial关键字的用法,涵盖分部类、结构体、接口及方法的定义与限制。通过代码示例说明如何利用partial实现大型项目协作和自动生成代码分离,并对比其与this扩展方法的区别,帮助开发者更清晰地组织C#代码。
深入解析MySQL InnoDB缓冲池配置,涵盖innodb_buffer_pool_size与instances参数的合理设置方法。通过监控Innodb_buffer_pool_pages_data等状态变量,结合数据使用率公式动态调整内存分配,有效提升数据库I/O性能并降低磁盘读写开销。
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。

本文介绍如何使用Python实现多元线性回归,重点讲解梯度下降算法。通过定义代价函数与偏导数计算,迭代更新参数theta0、theta1和theta2。示例展示从数据读取、模型训练到可视化拟合平面的完整流程,1000次迭代后损失值显著降低,适用于机器学习入门与模型部署参考。
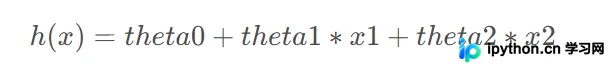
本文深入剖析ASP.NET 5中ApplicationBuilder类的底层实现,解读其如何利用代理链(Middleware Pipeline)替代传统的IHttpModule。通过分析_components列表、Use与Build方法的执行逻辑,以及Run扩展方法的作用,结合代码示例展示中间件的注册顺序与调用流向,帮助开发者掌握自定义HTTP管道的核心机制。
本文详解Go语言中JSON的序列化(json.Marshal)与反序列化(json.Unmarshal)操作,包含基础数据结构转换、格式美化技巧、指针传递注意事项,以及实现Marshaler与TextMarshaler接口的自定义序列化方法,附带完整代码示例。
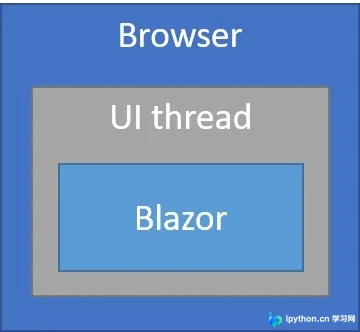
本文深入解析微软推出的Blazor框架,阐述其使用C#编写Web UI的核心优势。重点对比Blazor WebAssembly(客户端运行)与Blazor Server(服务端运行)两种托管模型的运行机制、优缺点及浏览器兼容性,帮助开发者根据项目需求选择最佳部署方案。
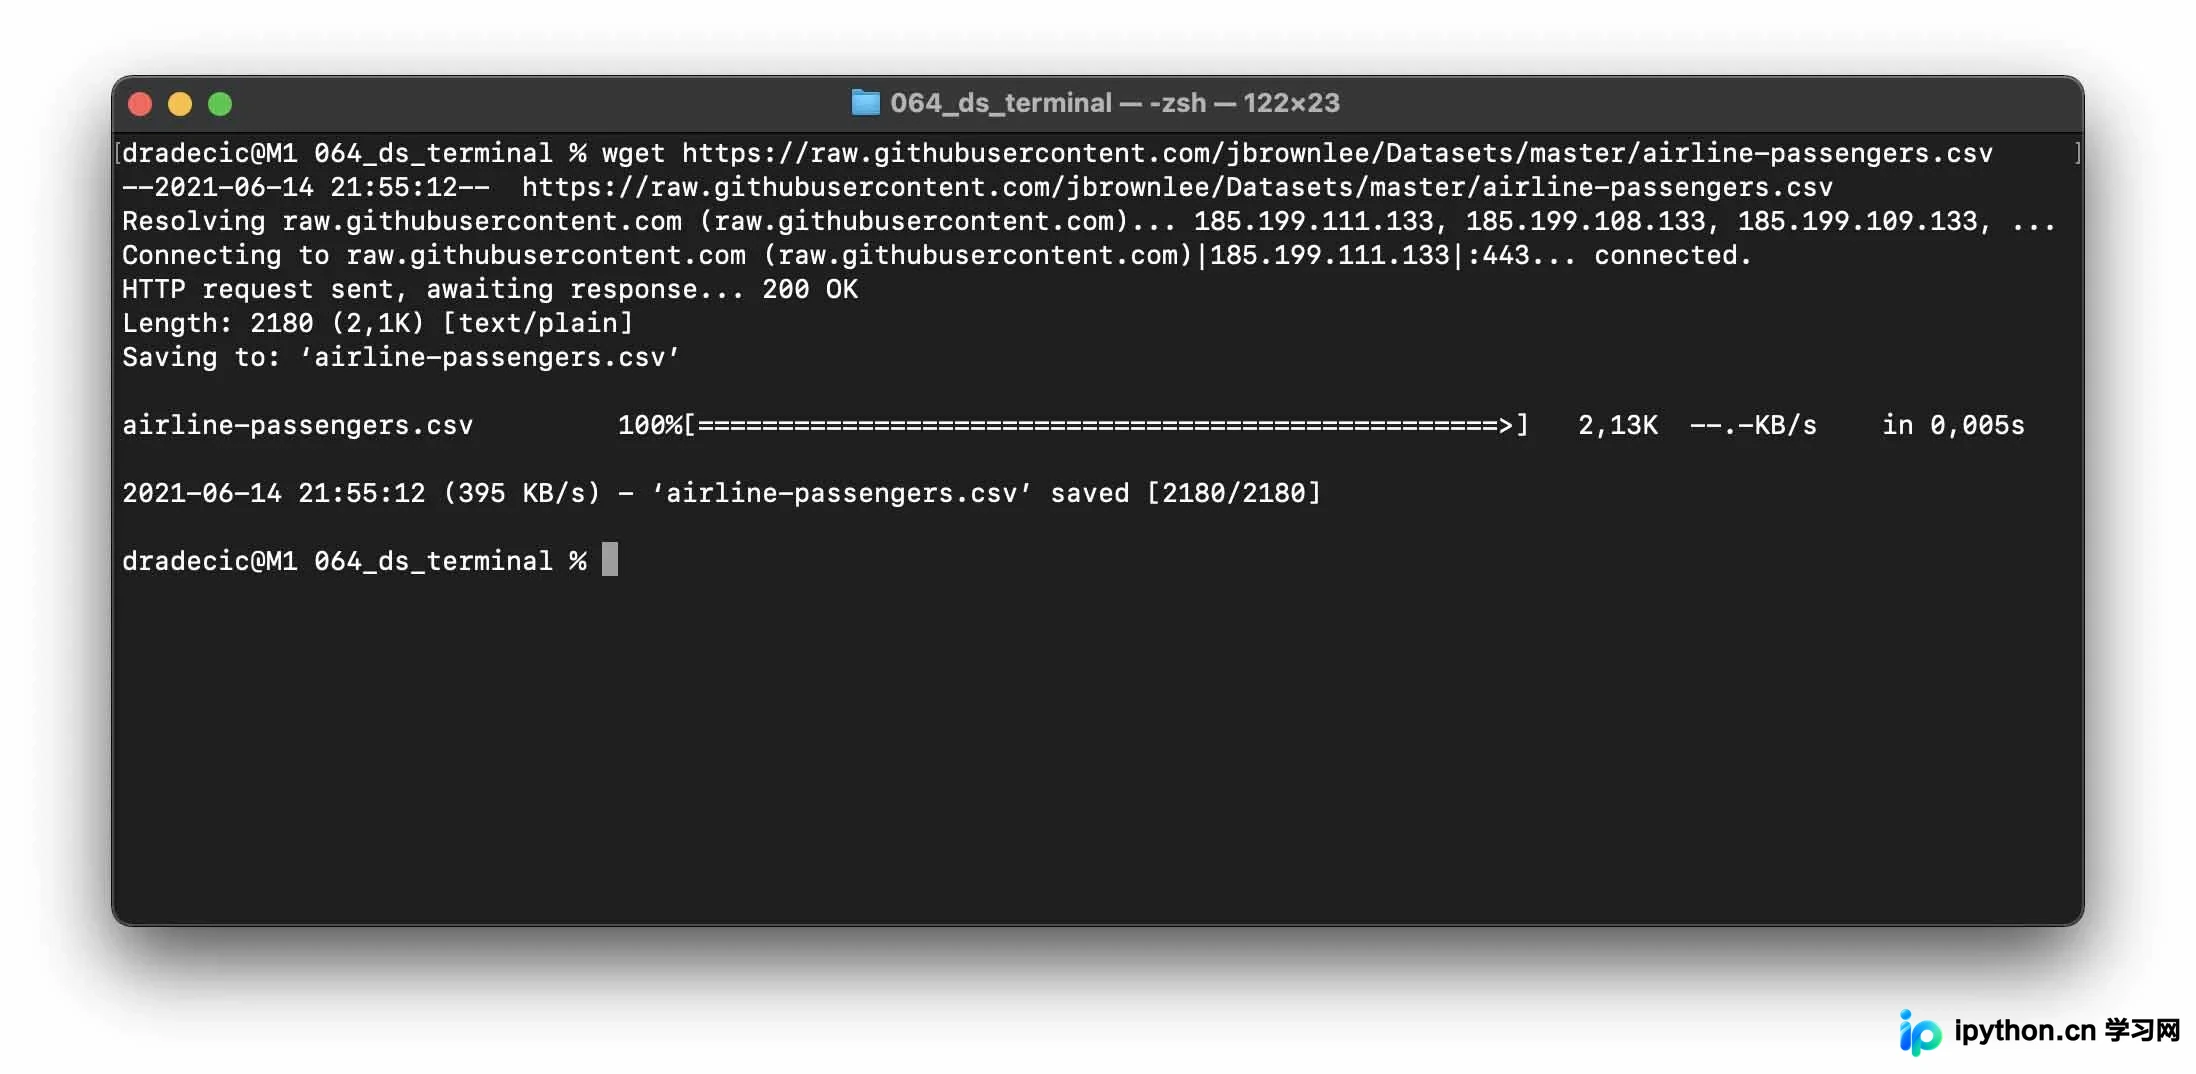
本文介绍了Python数据科学家在部署模型和处理数据管道时常用的10个终端命令。涵盖wget下载、head/tail查看文件、wc统计行数、grep筛选数据、cat查看内容、find查找文件、sort排序、nano编辑代码以及变量使用。这些基础命令能显著提升数据处理效率,是入门数据挖掘的必备技能。