


Python OpenCV利用ANN神经网络实现手写数字识别

发布时间:2026-10-15 |
10人浏览过
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。
环境配置与数据预处理
OpenCV提供了一套类似于Keras的神经网络接口,称为ANN(人工神经网络),其使用方式与Keras高度相似。在数据准备阶段,虽然可以自行编写代码解析MNIST数据集,但为了简化流程并聚焦于算法本身,本文直接调用Keras提供的MNIST解析模块。本示例的运行环境配置如下:Python版本为3.6.8,OpenCV核心库版本为4.4.0.46,OpenCV扩展库版本同样为4.4.0.46。
以下是使用ANN进行模型训练的核心代码实现:
ANN模型训练实现
from keras.datasets import mnist
from keras import utils
import cv2
import numpy as np
#opencv中ANN定义神经网络层
def create_ANN():
    ann=cv2.ml.ANN_MLP_create()
    #设置神经网络层的结构 输入层为784 隐藏层为80 输出层为10
    ann.setLayerSizes(np.array([784,64,10]))
    #设置网络参数为误差反向传播法
    ann.setTrainMethod(cv2.ml.ANN_MLP_BACKPROP)
    #设置激活函数为sigmoid
    ann.setActivationFunction(cv2.ml.ANN_MLP_SIGMOID_SYM)
    #设置训练迭代条件
    #结束条件为训练30次或者误差小于0.00001
    ann.setTermCriteria((cv2.TermCriteria_EPS|cv2.TermCriteria_COUNT,100,0.0001))
    return ann
#计算测试数据上的识别率
def evaluate_acc(ann,test_images,test_labels):
    #采用的sigmoid激活函数,需要对结果进行置信度处理
    #对于大于0.99的可以确定为1 对于小于0.01的可以确信为0
    test_ret=ann.predict(test_images)
    #预测结果是一个元组
    test_pre=test_ret[1]
    #可以直接最大值的下标 (10000,)
    test_pre=test_pre.argmax(axis=1)
    true_sum=(test_pre==test_labels)
    return true_sum.mean()
if __name__=='__main__':
    #直接使用Keras载入的训练数据(60000, 28, 28) (60000,)
    (train_images,train_labels),(test_images,test_labels)=mnist.load_data()
    #变换数据的形状并归一化
    train_images=train_images.reshape(train_images.shape[0],-1)#(60000, 784)
    train_images=train_images.astype('float32')/255
    test_images=test_images.reshape(test_images.shape[0],-1)
    test_images=test_images.astype('float32')/255
    #将标签变为one-hot形状 (60000, 10) float32
    train_labels=utils.to_categorical(train_labels)
    #测试数据标签不用变为one-hot (10000,)
    test_labels=test_labels.astype(np.int)

    #定义神经网络模型结构
    ann=create_ANN()
    #开始训练
    ann.train(train_images,cv2.ml.ROW_SAMPLE,train_labels)
    #在测试数据上测试准确率
    print(evaluate_acc(ann,test_images,test_labels))

    #保存模型
    ann.save('mnist_ann.xml')
    #加载模型
    myann=cv2.ml.ANN_MLP_load('mnist_ann.xml')
经过100次迭代训练后,模型在测试集上的准确率为0.9376。若需进一步提升识别精度,可增加训练迭代次数或加深神经网络的结构层次。由于ANN模型仅保存权重参数,其结构非常精简。

对比不同算法的模型文件大小可知,ANN模型文件仅为1MB,而SVM模型约为十多兆,KNN模型则高达几百兆。因此,ANN神经网络在资源受限的客户端设备上具有更高的部署优势。接下来,我们将使用训练好的ANN模型进行图片识别测试:
模型测试与识别结果
import cv2
import numpy as np
if __name__=='__main__':
    #读取图片
    img=cv2.imread('shuzi.jpg',0)
    img_sw=img.copy()
    #将数据类型由uint8转为float32
    img=img.astype(np.float32)
    #图片形状由(28,28)转为(784,)
    img=img.reshape(-1,)
    #增加一个维度变为(1,784)
    img=img.reshape(1,-1)
    #图片数据归一化
    img=img/255
    #载入ann模型
    ann=cv2.ml.ANN_MLP_load('minist_ann.xml')
    #进行预测
    img_pre=ann.predict(img)
    #因为激活函数sigmoid,因此要进行置信度处理
    ret=img_pre[1]
    ret[ret>0.9]=1
    ret[ret<0.1]=0
    print(ret)
    cv2.imshow('test',img_sw)
    cv2.waitKey(0)
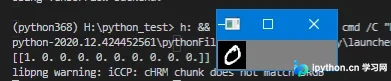
运行测试程序后,结果显示模型成功识别出图像中的数字0。
至此,关于利用Python OpenCV的ANN神经网络进行手写数字识别的教程介绍完毕。如需了解更多相关技术内容,建议查阅本站过往文章或关注后续更新,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















