MySQL数据库库、表管理及视图创建详解
本文详细讲解MySQL中数据库和表的基本管理操作,包括创建、修改和删除数据库及表的语法。重点介绍了列名变更、类型修改、添加或删除列、表重命名等关键步骤。同时阐述视图的概念、作用及创建方法,帮助开发者简化复杂查询并提高数据管理的规范性与效率。
2026-10-15
0



本文详细讲解MySQL中数据库和表的基本管理操作,包括创建、修改和删除数据库及表的语法。重点介绍了列名变更、类型修改、添加或删除列、表重命名等关键步骤。同时阐述视图的概念、作用及创建方法,帮助开发者简化复杂查询并提高数据管理的规范性与效率。
本文详细讲解如何使用Python的SQLAlchemy框架进行对象关系映射(ORM)以操作MySQL数据库。内容涵盖安装配置、连接创建、模型声明及表结构同步,解决少写SQL即可实现高效数据库交互的需求,适合希望快速掌握Python数据库操作的开发者。
本文深入解析MySQL触发器在数据库管理中的实际应用,以学校数据库(School)为例,演示如何创建BEFORE INSERT/UPDATE触发器。重点解决成绩范围(0-100)校验、学分上限(30分)控制、不及格记录保护、默认年龄填充以及自动计算学生平均成绩与等级评定等需求,确保数据的实时一致性与业务逻辑的自动化执行。
本文梳理MySQL中复杂的日期区间查询技巧,重点指出DATE_FORMAT导致索引失效的问题并提供优化方案。汇总now、curdate等时间获取函数,以及date_format、str_to_date转换方法,并结合date_add、datediff计算周期数据,提升SQL查询效率。
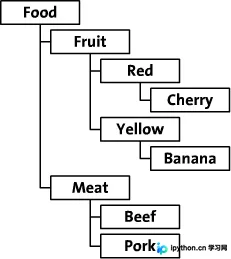
在关系型数据库中存储树形结构通常面临查询效率与数据冗余的权衡。本文对比两种主流方案:直观的邻接表模型适合小规模数据,而基于前序遍历的扩展预排序遍历树(左右值编码)通过数字区间优化了深层递归查询。文章详细解析了左右值模型的SQL CRUD操作逻辑及存储过程实现,帮助开发者根据业务场景选择最佳存储策略。
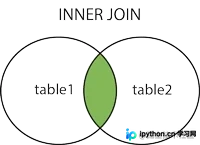
本文详细解析MySQL中的表联结与集合操作。涵盖CROSS、INNER及LEFT/RIGHT OUTER JOIN的原理与示例,讲解UNION与UNION ALL合并结果集的规则与差异,通过具体SQL代码演示如何在开发中正确应用这些核心查询语法以获取精准数据。
本文深入解析 MySQL 性能优化的十大核心场景,涵盖最左匹配原则、隐式转换陷阱、大分页延迟关联、IN 查询临界值及范围查询阻断等常见问题。通过 explain、show profile 和 optimizer_trace 工具定位执行计划瓶颈,提供从索引设计到 SQL 重构的实操方案,帮助开发者有效解决慢查询与索引失效问题。
MySQL InnoDB引擎缺乏硬性限制记录数的参数。本文介绍三种实现方案:利用计数器表与触发器配合存储过程管理上限;使用Range分区表快速替换数据块;以及通过通用表空间控制磁盘容量达到报错停止写入。文末对比各方案优缺点及适用场景。
针对每日增量插入的大规模 MySQL 数据表,直接 ALTER TABLE 分区资源消耗过大。本文分享通过新建同名分区表、使用 mysqldump 导出导入数据进行无锁迁移的方案。该方案将主键调整为联合主键以符合分区要求,并在低资源占用下完成200万级数据平滑迁移,实现查询秒开。
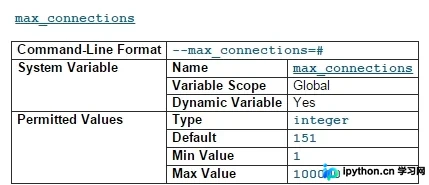
遇到 MySQL Too many connections (ERROR 1040) 报错时,通常因并发请求超过上限或配置过低。可通过 show variables 查看当前限制,show global status 分析负载,并通过 set global 临时生效或修改 my.cnf/my.ini 配置文件永久调整 max_connections 值,恢复服务稳定。
本文详细对比了C#中操作Excel的几种主流方式:通过OLEDB查询表快速读取、利用SqlBulkCopy实现数据库高速批量写入、使用Excel COM组件进行复杂的单元格样式与公式编辑,以及NPOI库的应用。文章涵盖了从基础数据导入导出到复杂报表生成的实际操作代码与注意事项,帮助开发者根据数据量级和交互需求选择最优方案。
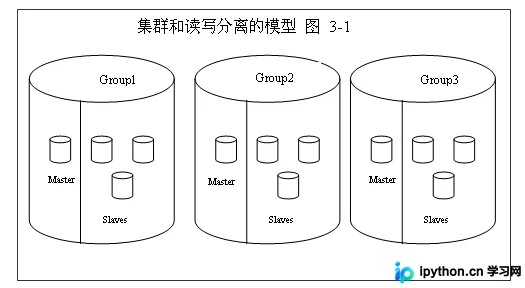
针对单一MySQL节点性能瓶颈,本文阐述基于ORM框架层的分布式数据访问解决方案。核心通过user_id等字段进行水平切分(Sharding),采用号段或Hash取模规则实现数据均匀分布。结合集群化部署实现Master写Slave读的读写分离,并引入负载均衡与节点心跳探测机制,以低硬件成本构建高可用、高扩展的海量数据存储系统。