


MySQL树形结构设计:邻接表与扩展预排序遍历树模型对比

在关系型数据库中处理分类、组织架构等层级数据时,传统的二维表难以直接映射树形结构。常用的设计方案包括保留父子ID引用的"邻接表"和使用区间编码的"扩展预排序遍历树"。前者实现简单但深层查询依赖递归,后者利用数值区间消除递归,大幅提升遍历效率,代价在于节点增删需要重新调整大量数据的索引。
树形结构的两种经典方案
程序设计中的树形结构(如部门层级、商品分类)通常需要持久化到数据库中。理想的设计需要在数据存储冗余、检索效率和CRUD操作性能之间取得平衡。我们主要通过以下两种Schema设计来实现:
方案一:邻接表(Adjacency List)
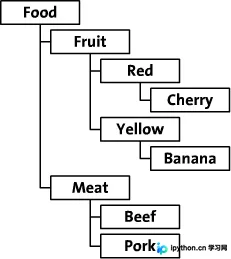
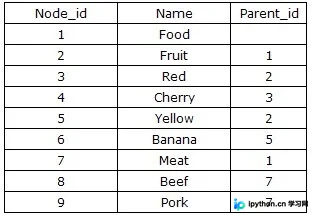
这是最直观的设计思路,通过在表中增加一个 parent_id 字段来记录当前节点的父节点ID。这种设计的优点是实现自然、逻辑简单,且在树规模较小时表现良好。
典型结构:
表通常包含主键 id 和外键 parent_id。例如在一个食品分类树中,可以直接看出哪个节点属于哪个父类。
局限性:
当树的层级加深时,获取子孙节点或整条路径往往需要进行多次数据库IO操作(即递归查询)。每次递归都会产生网络开销和数据库连接成本,导致性能随着树规模的扩大而显著下降。
方案二:扩展预排序遍历树(Extended Preorder Traversal Tree)
为了解决邻接表在复杂查询中的低效问题,可以采用基于前序遍历的“左右值”编码方案(也称为 Nested Set Model)。该方案不直接记录父子关系,而是通过给每个节点分配两个整数:左值(lft)和右值(rgt)来隐式表达层级关系。
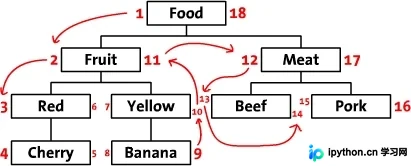
其核心原理是模拟对树进行深度优先搜索(前序遍历)的过程。从根节点的左侧开始标记为1,按顺序沿路径标记数字,最后回到根节点右侧标记最大值。这样,只要比较数值大小即可确定节点间的包含关系。
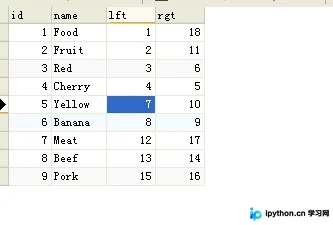
数据示例:
以Food为例,其 lft=1, rgt=18;子节点Fruit的范围被完全包裹在内(lft=2, rgt=11)。这种设计使得查询某一节点的所有后代只需一条SQL语句。
左右值模型的操作实现
为了将上述理论转化为可执行的数据库逻辑,我们需要定义基础的数据结构以及配套的增删改查算法。以下是基于MySQL的实现细节。
第一步:建立基础数据表与视图
首先创建存储节点信息的表,以及用于展示层次的视图和函数。这有助于直观验证数据的正确性。
1. 创建基础表
使用 InnoDB 引擎,包含四个关键字段。
CREATE TABLE `tree` (
  `id` int(11) NOT NULL,
  `name` varchar(255) DEFAULT NULL,
  `lft` int(255) DEFAULT NULL,
  `rgt` int(11) DEFAULT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
2. 插入测试数据
以下数据构成了一个典型的三层分类树结构。
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('1', 'Food', '1', '18');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('2', 'Fruit', '2', '11');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('3', 'Red', '3', '6');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('4', 'Cherry', '4', '5');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('5', 'Yellow', '7', '10');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('6', 'Banana', '8', '9');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('7', 'Meat', '12', '17');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('8', 'Beef', '13', '14');
INSERT INTO `jpa`.`tree` (`id`, `name`, `lft`, `rgt`) VALUES ('9', 'Pork', '15', '16');
3. 创建计数函数与视图
为了方便查看每一层级的深度,定义自定义函数并创建视图。
CREATE FUNCTION `CountLayer` (`node_id` INT) RETURNS INT (11)
BEGIN
    DECLARE result INT (10) DEFAULT 0 ;
    DECLARE lftid INT;
    DECLARE rgtid INT;
    SELECT lft,rgt INTO lftid, rgtid FROM tree WHERE id = node_id;
    SELECT COUNT(*) INTO result  FROM tree WHERE lft <= lftid AND rgt >= rgtid;
    RETURN (result);
END
CREATE VIEW `treeview` AS
SELECT
  `a`.`id` AS `id`,
  `a`.`name` AS `name`,
  `a`.`lft` AS `lft`,
  `a`.`rgt` AS `rgt`,
  `CountLayer` (`a`.`id`) AS `layer`
FROM
  `tree` `a`
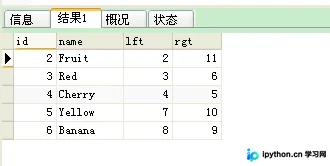
第二步:实现核心CRUD存储过程
左右值模型的优势在于读取极快,但修改(增删)需要维护区间的一致性。我们通过事务来处理这些复杂的计算更新。
1. 获取所有子孙节点
这是该方案最显著的优势。只需判断 lft 和 rgt 是否在被查询节点的区间内即可。
CREATE PROCEDURE `GetChildrenNodeList`(IN `node_id` INT)
BEGIN
DECLARE lftid INT;
DECLARE rgtid INT;
SELECT lft,rgt INTO lftid,rgtid FROM tree WHERE id= node_id;
SELECT * FROM treeview WHERE lft BETWEEN lftid AND rgtid ORDER BY lft ASC;
END
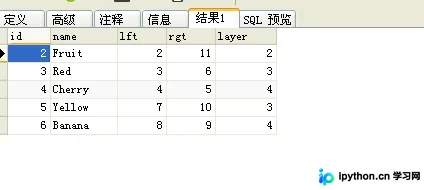
2. 获取族谱路径(祖先链)
同理,通过反向区间判断可以找出所有父级节点。
CREATE PROCEDURE `GetParentNodePath`(IN `node_id` INT)
BEGIN
DECLARE lftid INT;
DECLARE rgtid INT;
SELECT lft,rgt INTO lftid,rgtid FROM tree WHERE id= node_id;
SELECT * FROM treeview WHERE lft < lftid AND rgt > rgtid ORDER BY lft ASC;
END
3. 添加新的子节点
插入新节点时,必须将该节点右侧所有的 lft 和 rgt 值加 2,腾出空间。这是一个原子操作,必须在事务中完成以防数据不一致。
CREATE PROCEDURE `AddSubNode`(IN `node_id` INT, IN `node_name` VARCHAR(64))
BEGIN
   DECLARE rgtid INT;
   DECLARE t_error INT DEFAULT 0;
   DECLARE CONTINUE HANDLER FOR SQLEXCEPTION SET t_error=1;
   SELECT rgt INTO rgtid FROM tree WHERE id= node_id;
   START TRANSACTION;
        UPDATE tree SET rgt = rgt + 2 WHERE rgt >= rgtid;
        UPDATE tree SET lft = lft + 2 WHERE lft >= rgtid;
        INSERT INTO tree (NAME,lft,rgt) VALUES(node_name,rgtid,rgtid+1);
    IF t_error = 1 THEN
     ROLLBACK;
    ELSE
      COMMIT;
    END IF;
END
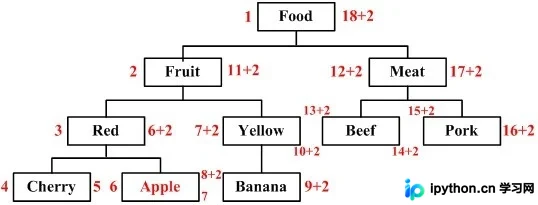
4. 删除指定节点及其所有子孙
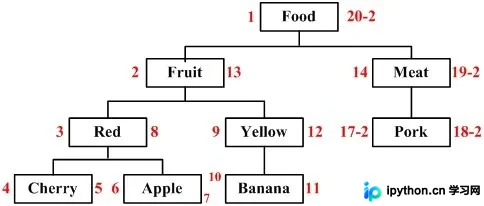
删除逻辑相对复杂。首先需要计算被删除节点占用的空间大小 (rgt - lft + 1)。然后物理删除该范围内的记录,并将后续所有节点的数值减去这个大小,以保持区间的连续性。
CREATE PROCEDURE `DelNode`(IN `node_id` INT)
BEGIN
   DECLARE lftid INT;
     DECLARE rgtid INT;
   DECLARE t_error INT DEFAULT 0;
   DECLARE CONTINUE HANDLER FOR SQLEXCEPTION SET t_error=1;
   SELECT lft,rgt INTO lftid,rgtid FROM tree WHERE id= node_id;
   START TRANSACTION;
       DELETE FROM tree WHERE lft >= lftid AND rgt <= rgtid;
       UPDATE tree SET lft = lft -(rgtid - lftid  + 1) WHERE lft > lftid;
       UPDATE tree SET rgt = rgt -(rgtid - lftid  + 1) WHERE rgt > rgtid;
    IF t_error =1 THEN
     ROLLBACK;
    ELSE
      COMMIT;
    END IF;
END
总结与选型建议
在设计支持无限分组或深层级关系的业务系统时,选择合适的存储模型至关重要:
- 邻接表(Adjacency List): 代码实现简单,修改节点位置成本低(只需改
parent_id),但不适合频繁进行大范围查询的系统。 - 扩展预排序(Nested Set): 极大地优化了读取性能,一次查询即可获取完整的分支树,消除了数据库层面的递归消耗。但其主要缺点在于写操作昂贵——每增加或删除一个节点,都可能需要更新表中半数以上的其他节点的
lft/rgt值。
对于大多数现代Web应用,如果树状数据的变动频率不高且查询频繁,左右值编码方案是一个高效的选择;反之,如果树结构动态变化极其剧烈且层级极深,也可以考虑使用专门的图数据库或在应用层构建缓存结构来辅助处理。
以上就是 MySQL 树形结构数据库表的详细内容,更多关于 SQL 树形模型设计优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















