


Python SQLAlchemy ORM操作MySQL数据库入门指南

使用Python的SQLAlchemy框架通过对象关系映射(ORM)技术操作MySQL数据库,无需编写复杂SQL语句即可实现数据表的增删改查。本文将介绍环境准备、数据库连接配置、ORM模型定义及表同步等核心步骤。
什么是ORM
ORM(Object Relational Mapping,对象关系映射)是一种编程技术,用于将面向对象编程语言中的对象映射到关系型数据库的表中。它充当了应用程序代码与数据库之间的桥梁,使开发者能够像操作普通对象一样处理数据库记录,从而简化数据存储逻辑。
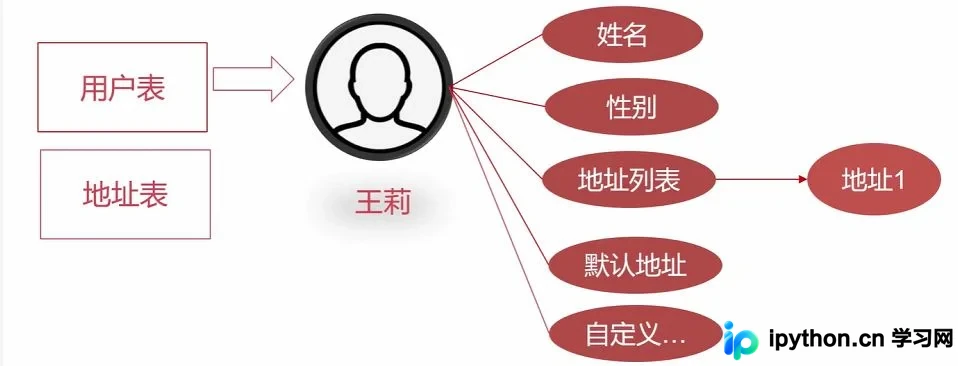
ORM的重要特性
- 面向对象编程思想:符合现代开发习惯,便于代码扩充与维护。
- 提升开发效率:大幅减少甚至避免手写SQL语句,降低出错率。
- 数据库无关性:支持多种数据库后端(如MySQL、PostgreSQL、Oracle等),切换底层数据库较为便捷。
- 成熟的技术体系:能解决绝大多数常规的数据持久化需求。
选择SQLAlchemy框架
在众多ORM框架中,SQLAlchemy是Python生态中最具影响力且功能完备的选择之一。它不仅提供了面向过程的核心库,还包含了完整的ORM组件。
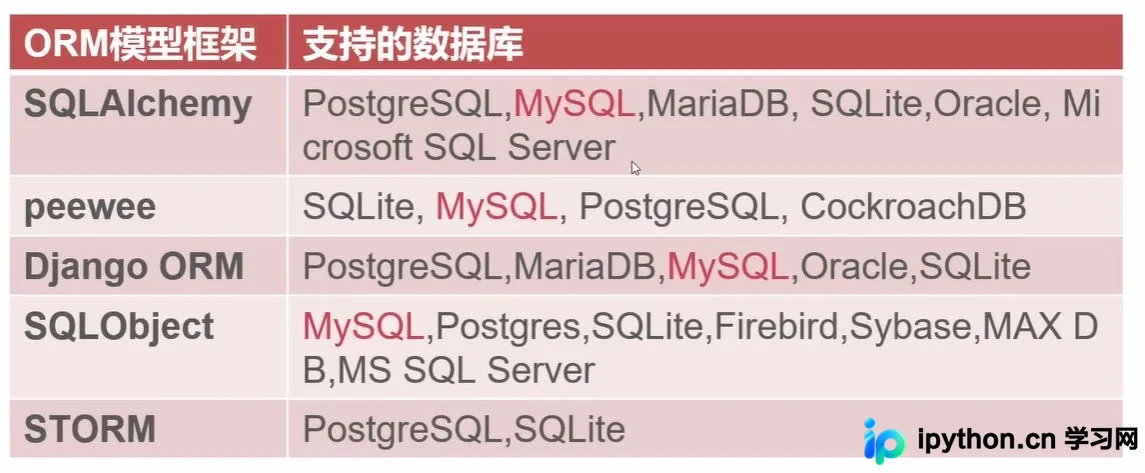
环境准备与安装
首先需要通过pip安装SQLAlchemy库。推荐使用指定版本以确保兼容性,例如:
pip install SQLAlchemy==1.4.17安装完成后,可通过以下代码验证安装情况及版本号:
import sqlalchemy
print(sqlalchemy.__version__)
开始连接数据库
使用create_engine函数建立数据库引擎,这是所有数据库操作的基础。SQLAlchemy支持“延迟连接”机制,即只有在执行实际查询或写入操作时才会真正建立物理网络连接。
第1步:初始化引擎
入口:代码模块顶部。动作:调用create_engine传入连接字符串。
from sqlalchemy import create_engine

# 构建 MySQL 连接 URL
# 格式:dialect+driver://username:password@host:port/database[?parameters]
engine = create_engine(
    'mysql://root:@127.0.0.1:3306/school?charset=utf8',
    echo=True,      # 开启日志输出,调试时非常有用
    future=True     # 启用 SQLAlchemy 2.0 风格 API
)
参数说明:
- URL:指定数据库类型(mysql)、连接器、用户名、密码、主机地址和端口。
- echo:布尔值,设为True时会打印所有生成的SQL语句,便于排查问题。
- future:布尔值,建议启用以遵循最新的API规范。
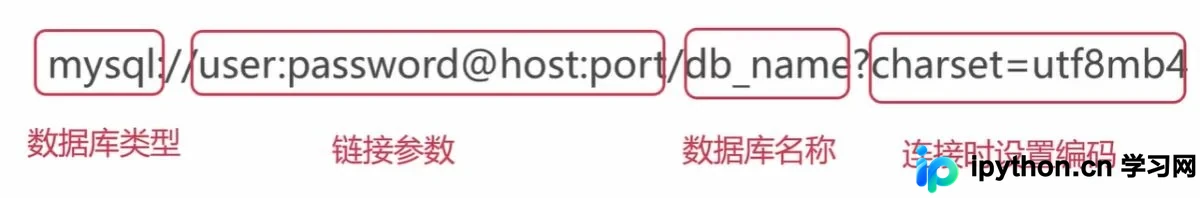
第2步:处理含特殊字符的密码
若数据库密码包含特殊字符(如%、&等),直接拼接进URL可能导致解析错误。此时应使用urllib.parse.quote_plus对密码进行URL编码。
from urllib.parse import quote_plus

# 假设密码为 mima%&&&mima
raw_password = "mima%&&&mima"
encoded_password = quote_plus(raw_password)

# 将编码后的密码填入连接字符串
url = f"mysql://root:{encoded_password}@127.0.0.1:3306/school?charset=utf8"
engine = create_engine(url, echo=True, future=True)
声明ORM模型基类
在使用SQLAlchemy的ORM功能前,需要创建一个基类。这个基类是所有后续数据库模型类的父类,负责管理元数据(Metadata)。
from sqlalchemy.orm import declarative_base

# 声明ORM模型基类
Base = declarative_base()
实现ORM模型类
ORM模型类通常继承自上述创建的Base。每个类对应数据库中的一张表,类属性对应表的列。
第3步:定义学生信息表模型
入口:定义新文件或使用现有模块。动作:创建继承自Base的类,并定义列属性。
from sqlalchemy import Column, Integer, String, DateTime

class Student(Base):
    """学生信息表"""
    __tablename__ = 'student'  # 指定数据库表名

    id = Column(Integer, primary_key=True, name='id')          # 主键
    stu_no = Column(Integer, nullable=False, comment='学号')   # 非空字段
    stu_name = Column(String(16), nullable=False, comment='姓名') # 变长字符串
    created_at = Column(DateTime)                              # 时间戳
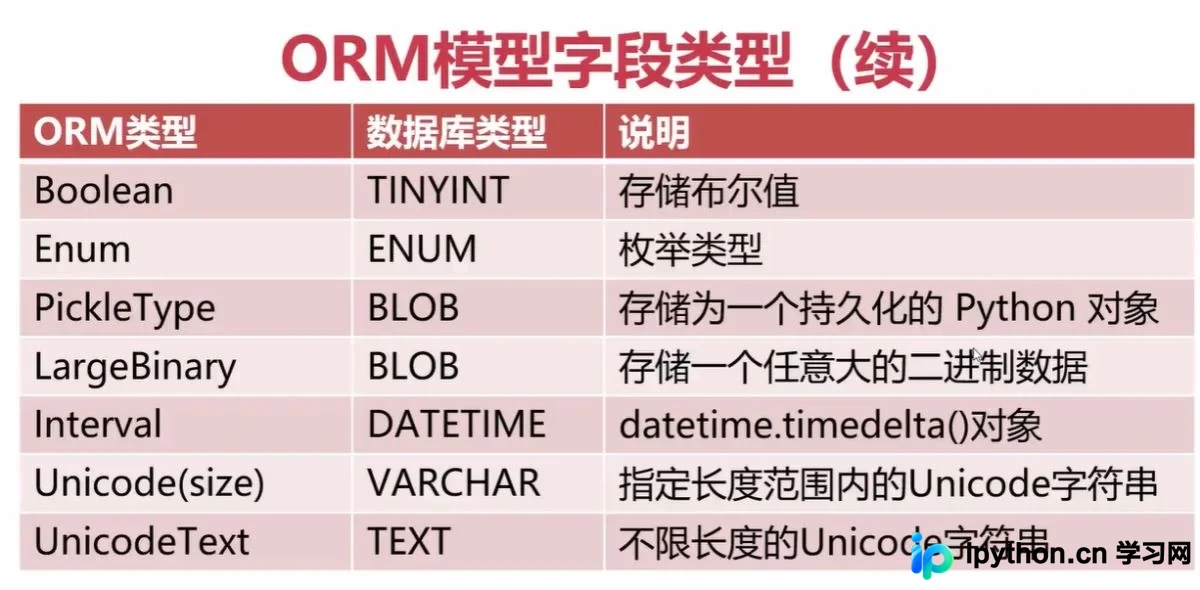
注意事项:
- 在同步表结构之前,必须确保MySQL数据库中已经创建了目标数据库(如示例中的
school库),否则操作会失败。 - 常见字段类型包括:
Integer(整型)、String(字符串)、DateTime(日期时间)等。
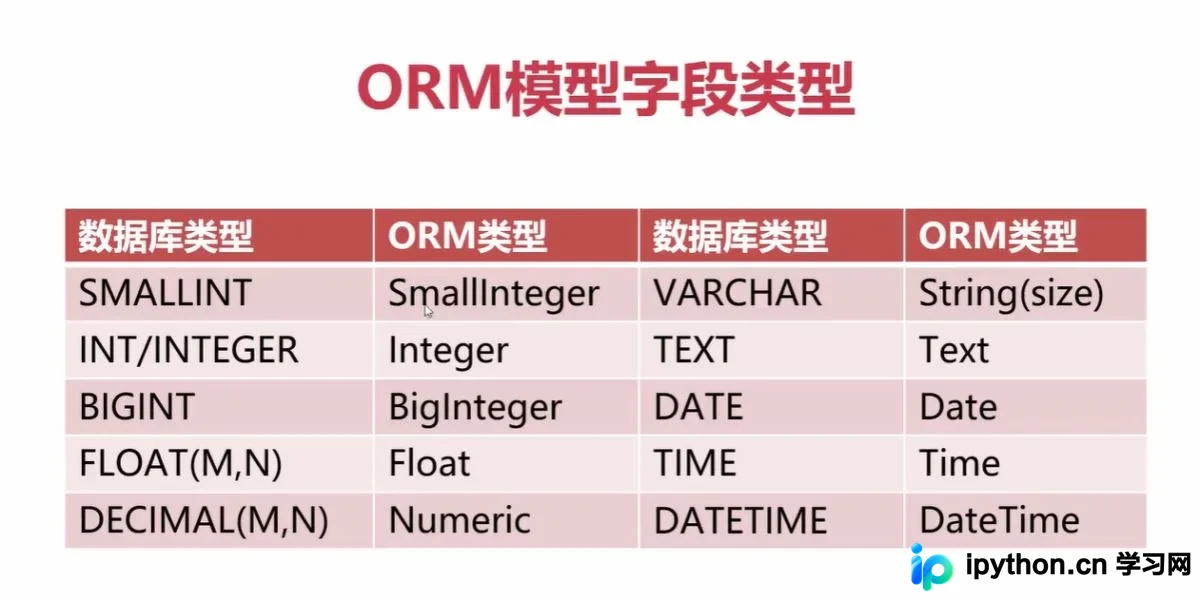
同步数据库表
完成模型定义后,需要将Python类的结构同步到物理数据库中。
第4步:创建或删除表
入口:调用metadata方法。动作:使用create_all生成表,或使用drop_all删除表。
# 从之前的导入中获取 engine 和 Base
from orm_connect_example import Base, engine

# 创建表(若不存在则创建)
Base.metadata.create_all(engine)

# 删除所有已创建的表(谨慎使用!)
# Base.metadata.drop_all(engine)
完整代码示例
以下是整合上述步骤的完整参考代码:
from sqlalchemy import create_engine, Column, Integer, String, DateTime
from sqlalchemy.orm import declarative_base

# 第一步:准备数据库连接
# 注意:请根据实际情况修改 IP、端口、数据库名及密码
engine = create_engine(
    'mysql://root:@10.72.100.1:8081/test_database_1?charset=utf8',
    echo=True
)

# 第二步:声明ORM模型的基类
Base = declarative_base()

# 第三步:实现ORM模型类
class Student(Base):
    """学生信息表"""
    __tablename__ = 'student'

    id = Column(Integer, primary_key=True, name='id')
    stu_no = Column(Integer, nullable=False, comment='学号')
    stu_name = Column(String(16), nullable=False, comment='姓名')
    created_at = Column(DateTime)

# 第四步:同步数据库表
def sync_tables():
    """同步数据库表结构"""
    print("正在创建/检查表...")
    Base.metadata.create_all(bind=engine)
    # Base.metadata.drop_all(bind=engine)  # 如需重置,可取消注释此行

if __name__ == '__main__':
    sync_tables()
以上就是Python SQLAlchemy ORM操作MySQL数据库的详细流程。通过这一套标准动作,你可以快速建立起应用程序与数据库之间的稳定连接。更多关于数据库高级用法及ORM查询优化的资料,请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















