MySQL事务并发问题与隔离级别详解:MVCC和行锁算法原理
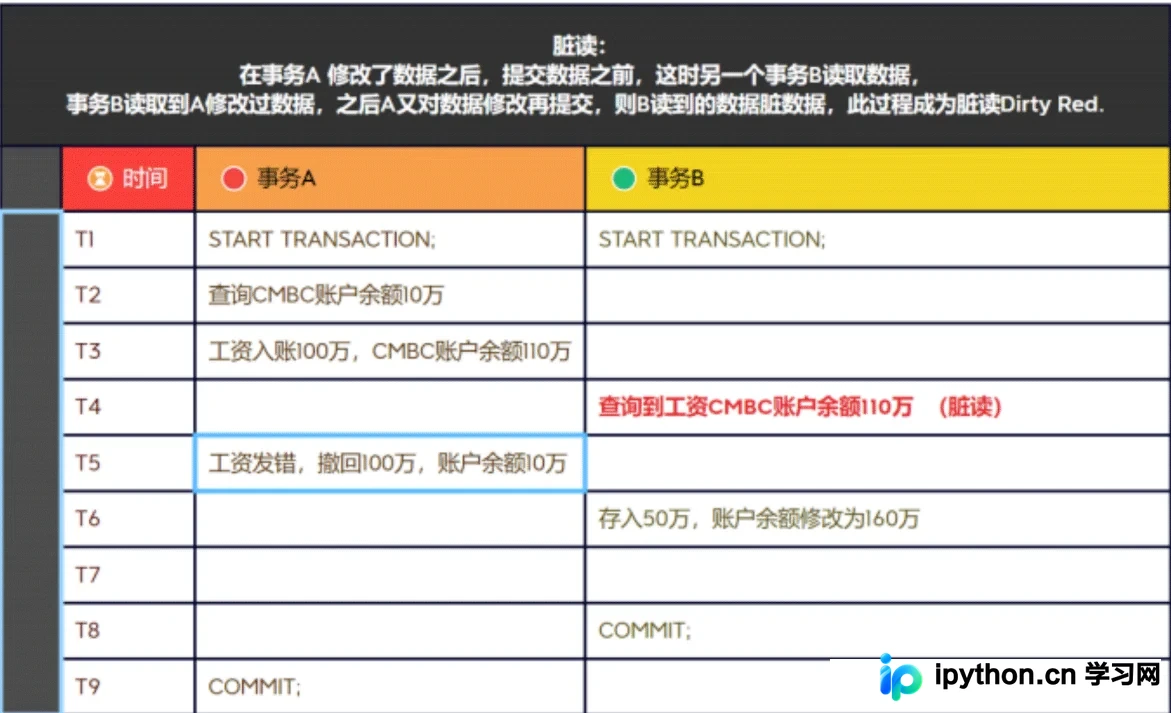
深入解析MySQL InnoDB引擎如何处理事务并发产生的脏读、不可重复读和幻读问题。文章详细阐述了SQL标准的四种事务隔离级别,重点剖析了MVCC(多版本并发控制)如何通过undo log版本链和read view快照在RC与RR级别下协同工作,同时讲解了基于索引的行锁机制及Record、Gap、Next-Key三种锁算法如何解决幻读及死锁问题。
2026-10-15
0



深入解析MySQL InnoDB引擎如何处理事务并发产生的脏读、不可重复读和幻读问题。文章详细阐述了SQL标准的四种事务隔离级别,重点剖析了MVCC(多版本并发控制)如何通过undo log版本链和read view快照在RC与RR级别下协同工作,同时讲解了基于索引的行锁机制及Record、Gap、Next-Key三种锁算法如何解决幻读及死锁问题。
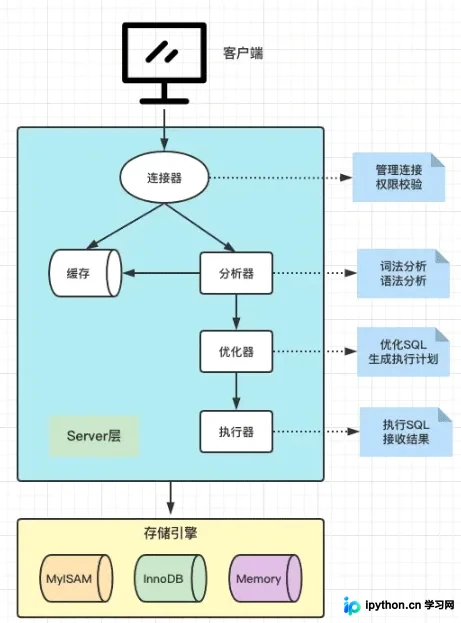
深入解析 MySQL 分层架构设计,揭示 Server 层(连接器、查询缓存、分析器、优化器、执行器)与存储引擎层的交互原理。了解 SQL 语句在每一层的具体处理逻辑,明确连接管理、语法校验、执行计划生成及最终数据返回的完整链路,帮助开发者跳出碎片化优化,建立系统性的底层认知。
本文解析MySQL中回表现象的原理。对比聚簇索引与非聚簇索引(二级索引)在叶子节点存储数据的区别,解释为何使用非主键索引查询时需要额外通过主键值检索完整数据。结合B+树特性说明回表机制,并提供利用覆盖索引消除回表的优化方案。
本文深入解析MySQL中删除数据的三种核心命令:DELETE、TRUNCATE和DROP。通过对比执行效率、空间释放、事务回滚及自增ID重置等关键特性,帮助用户根据业务场景选择合适的数据清理方案,避免误操作导致不可逆后果。
本文总结使用Go语言操作MySQL的核心步骤。通过引入go-sql-driver/mysql和jmoiron/sqlx,实现数据库连接、参数配置及基础增删改查操作,并提供关键注意事项以优化并发性能。
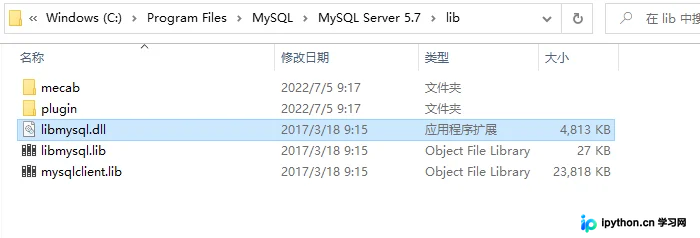
本文详细讲解如何在Qt项目中成功连接MySQL数据库并进行数据操作。内容涵盖将libmysql.dll驱动文件正确放置到Qt bin目录以解决连接失败问题,以及通过QSqlDatabase建立连接。同时深入演示了QSqlQuery的基本用法,包括单条语句执行、使用addBindValue与bindValue实现高效的批量数据处理,以及基于索引和列名的数据查询方法,提供完整的C++代码片段辅助实战开发。
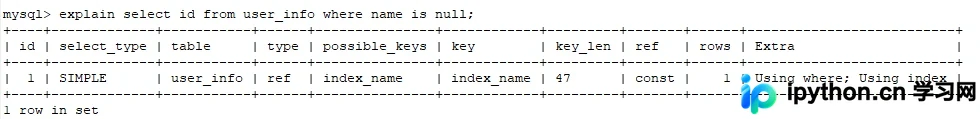
许多开发者误以为 MySQL 中 WHERE name IS NULL 会导致索引失效,实则不然。本文通过 innodb_ruby 工具与二进制文件分析,揭示 NULL 值在 B+ 树中的存储位置;并通过案例复现证明,所谓“索引失效”通常是由于条件匹配行数过多(如 >20%)导致回表成本高于全表扫描,由 Optimizer 主动放弃索引所致。
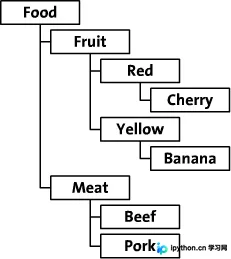
在关系型数据库中存储树形结构通常面临查询效率与数据冗余的权衡。本文对比两种主流方案:直观的邻接表模型适合小规模数据,而基于前序遍历的扩展预排序遍历树(左右值编码)通过数字区间优化了深层递归查询。文章详细解析了左右值模型的SQL CRUD操作逻辑及存储过程实现,帮助开发者根据业务场景选择最佳存储策略。
针对每日增量插入的大规模 MySQL 数据表,直接 ALTER TABLE 分区资源消耗过大。本文分享通过新建同名分区表、使用 mysqldump 导出导入数据进行无锁迁移的方案。该方案将主键调整为联合主键以符合分区要求,并在低资源占用下完成200万级数据平滑迁移,实现查询秒开。
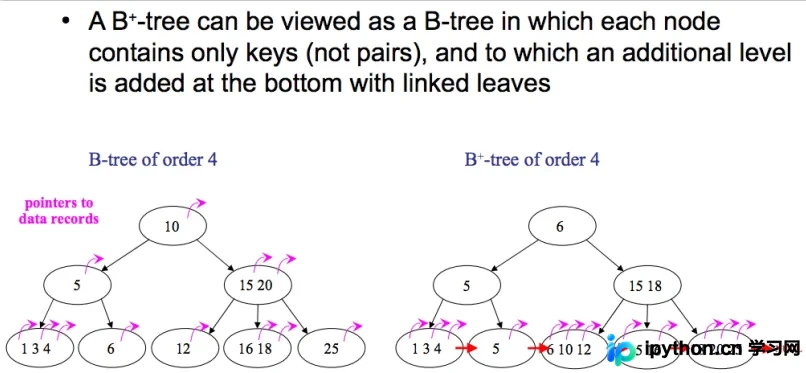
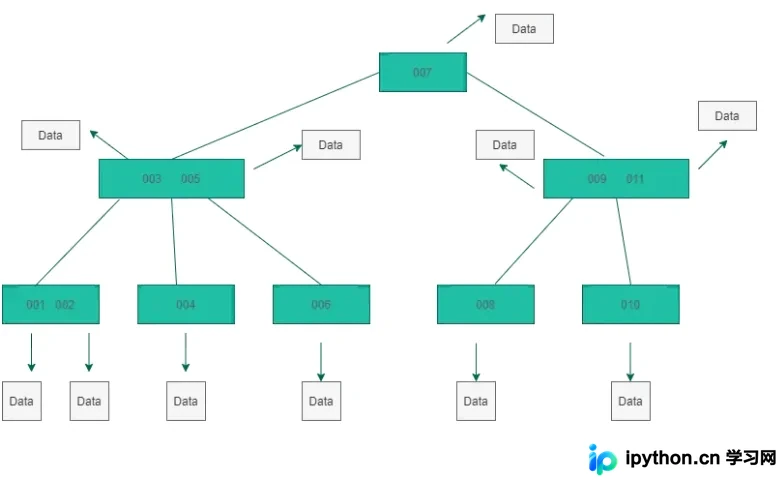
深入解析MySQL索引的底层数据结构,对比B树与B+树差异,阐明InnoDB中聚簇索引与非聚簇索引(二级索引)的实现机制。涵盖回表查询、覆盖索引优化及哈希索引适用场景,帮助理解数据库高效查询的原理。
在 MySQL 中使用 NOT IN 进行子查询时,若子查询结果包含 NULL 值,最终查询将返回空结果。这是因为 NOT IN 底层等价于多个 != 条件的 AND 组合,而任何值与 NULL 的比较结果均为 NULL(视为 FALSE)。本文详解其底层逻辑,并提供过滤 NULL 或改用 NOT EXISTS 的可靠解决方案。
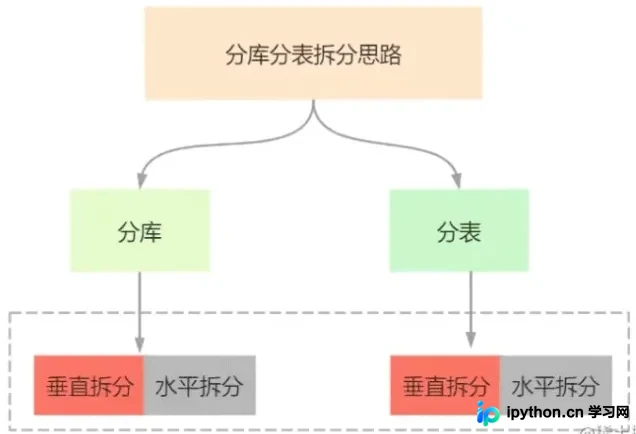
面对高并发和数据量增长,MySQL 分库分表是提升性能的关键手段。本文详细解析垂直拆分与水平拆分的逻辑、优缺点及适用场景,对比 ShardingSphere 与 MyCAT 等主流中间件的直连与代理层差异,并提供分布式事务、全局 ID 及跨库 Join 等核心问题的处理思路,帮助开发者根据业务特性选择最佳架构方案。