


MySQL IS NULL 会索引失效?深度解析 InnoDB 索引结构与优化器决策

很多开发者认为在 MySQL 中使用 IS NULL、IS NOT NULL 或 != 会导致索引失效并引发全表扫描,这其实是一个常见的误解。本文将深入 MySQL InnoDB 引擎内部,结合源码级工具与执行计划追踪,还原索引处理 NULL 值的真实逻辑,并解释优化器何时会真正选择全表扫描。
核心结论:IS NULL 本身不影响索引可用性
MySQL 官方文档明确指出:MySQL can perform the same optimization on col_name IS NULL that it can use for col_name = constant_value. 这意味着 IS NULL 和等值查询一样,完全可以使用索引进行快速查找。
导致“看似索引失效”的真正原因通常是回表成本过高。当 SQL 条件筛选出的数据量占总数据比例较大时(经验阈值约为 20%),MySQL 优化器会计算发现:通过二级索引定位主键后,再进行回表查询的数据页读取次数太多,总成本高于直接遍历全表。此时,优化器才会主动选择放弃索引,采用全表扫描。
案例验证:基础数据下的索引表现
首先构建一张测试表 user_info,包含自增主键、普通索引字段 name 以及冗余字段 age。
CREATE TABLE `user_info` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `name` varchar(11) DEFAULT NULL,
  `age` int(4) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `index_name` (`name`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO `user_info` (`id`, `name`, `age`) VALUES
('1', 'tom', '18'),
('2', null, '19'),
('3', 'cat', '20');
在上述少量数据下执行 SELECT * FROM user_info WHERE name IS NULL; 和 SELECT * FROM user_info WHERE name IS NOT NULL;,查看 EXPLAIN 结果:
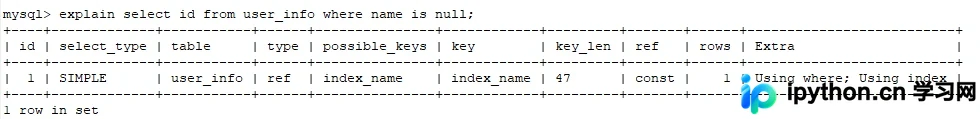
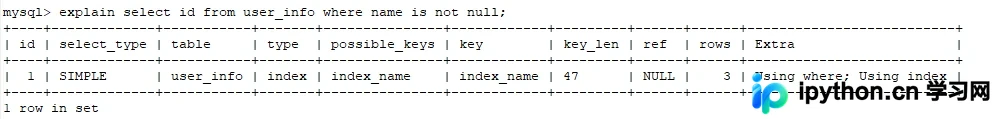
可以观察到,即便使用了 IS NULL 和 IS NOT NULL,两行语句均使用了 index_name 索引,type 为 ref 或 range,并未出现全表扫描。
原理剖析:NULL 在索引树中的位置
为了理解为什么能用到索引,我们需要探究 NULL 值在 InnoDB B+ 树叶子节点是如何存储的。这里使用两种方式进行验证:工具解析与二进制文件分析。
使用 innodb_ruby 工具解析
安装并使用强大的 MySQL 底层分析工具 innodb_ruby 直接读取 .ibd 文件。
# 安装依赖
yum install -y rubygems ruby-devel
gem install innodb_ruby

# 解析表的主键索引(此处仅展示关键输出)
innodb_space -s /usr/soft/mysql-5.6.31/data -T test/user_info -I PRIMARY index-recurse
解析 index_name 普通索引结构的输出如下:
$ innodb_space -s /usr/soft/mysql-5.6.31/data -T test/user_info -I index_name index-recurse
ROOT NODE #4: 3 records, 38 bytes
  RECORD: (name=:NULL) → (id=2)
  RECORD: (name="cat") → (id=3)
RECORD: (name="tom") → (id=1)关键发现:NULL 值确实被存储在索引树中。且在排序规则中,NULL 被处理为最小的值,位于索引链表的最左侧(B+ 树的最左端叶子节点)。
从二进制文件看索引记录
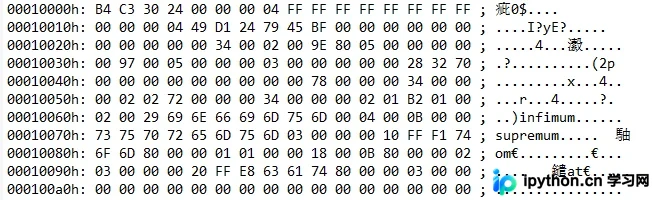
直接使用编辑器(如 UltraEdit)打开 user_info.ibd 文件,定位到对应的索引页数据页,可以看到索引记录的物理存储结构。展开其中几段关键字节:
- ID 为 2 的记录(对应 name=NULL):其字段值部分为空,紧随其后的是主键 ID
0x00 00 00 02。 - 双向链表指针:InnoDB 的叶子节点通过双向指针串联。ID 为 2 的记录头信息中包含指向前驱节点(最小记录 infimum)和后继节点(ID 为 3 的记录)的偏移量。
这证实了索引记录是通过指针以索引值排序串联在一起的,而 NULL 因其被定义为最小值,稳居索引起始位置。因此,优化器可以通过二分查找快速定位到最左侧,进而找到所有 NULL 值记录。
误区揭秘:为何会产生“索引失效”的错觉?
既然 NULL 存入了索引,为何大家常觉得 IS NOT NULL 会失效?
根本原因在于统计信息与成本估算。当表中存在大量非 NULL 数据时,WHERE name IS NOT NULL 可能覆盖了表中 80%~90% 的行。InnoDB 优化器在计算执行计划时,发现:
- 使用索引需要先从二级索引查出主键;
- 然后根据这些主键去聚簇索引(主键索引)中逐个取完整数据(即“回表”);
- 由于回表操作随机读取数据页较多,IO 成本激增。
当预估的回表总成本超过全表顺序扫描的成本时,优化器就会决定“不使用索引”。这不是索引功能本身的缺陷,而是基于成本的理性决策。
实验复现:大数量下的索引失效
为了直观看到这一过程,我们向表中插入 1000 条非 NULL 记录,使总行数达到 1003 行。此时,IS NULL 仅命中 1 行,而 IS NOT NULL 需返回 1002 行。
-- 批量插入 1000 条数据
DELIMITER //
CREATE PROCEDURE init_user_info()
BEGIN
	DECLARE indexNo INT;
	SET indexNo = 0;
	WHILE indexNo < 1000 DO
		START TRANSACTION;
		insert into user_info(name,age) values (concat(floor(rand()*1000000000)),floor(rand()*100));
		SET indexNo = indexNo + 1;
	COMMIT;
END WHILE;
END //
DELIMITER ;
CALL init_user_info();
现象观察:
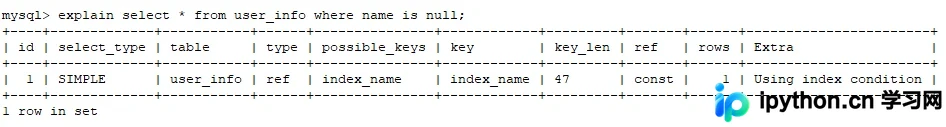
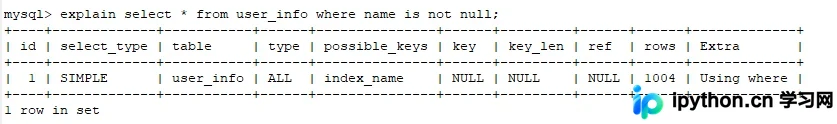
name IS NULL:命中 1 行,远低于 20% 临界值,正常走索引。name IS NOT NULL:命中 1002 行,覆盖率超 99%,触发全表扫描。
终极诊断:Optimizer Trace
我们可以通过 MySQL 5.6+ 提供的优化器追踪功能,清晰地看到优化器在做选择时的成本对比。
SET optimizer_trace="enabled=on";
EXPLAIN SELECT * FROM user_info WHERE name IS NOT NULL;
SELECT * FROM INFORMATION_SCHEMA.OPTIMIZER_TRACE;
在输出的 JSON 追踪日志中,重点关注 range_scan_alternatives 部分:
{
    "range_analysis": {
        "table_scan": {
            "rows": 1004,
            "cost": 206.9   // 全表扫描成本较低
        },
        "analyzing_range_alternatives": {
            "range_scan_alternatives": [
                {
                    "index": "index_name",
                    "ranges": ["NULL < name"],
                    "rows": 1002,
                    "cost": 1203.4, // 索引+回表成本极高
                    "chosen": false,
                    "cause": "cost"   // 因为成本原因被舍弃
                }
            ]
        }
    }
}
结果显示,全表扫描成本仅为 206.9,而走索引预计耗时 1203.4。正是这个巨大的成本差异,导致了最终的“索引失效”现象。
总结
MySQL 中的 IS NULL 并不会破坏索引的有效性,NULL 值会被作为最小值存入 B+ 树中供快速检索。所谓的“索引失效”,本质是 MySQL 优化器在面对高覆盖率条件(如 IS NOT NULL 且非空数据占绝大多数)时,基于回表 IO 成本过高而做出的最优路径选择。
在实际开发与调优中,如果遇到这类情况,不要盲目怀疑索引机制,可尝试通过 EXPLAIN 或 optimizer_trace 分析具体成本构成。若必须强制使用索引(例如业务对延迟极度敏感且愿意承担额外 IO),可在 SQL 末尾添加 FORCE INDEX。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















