


MySQL 分库分表方案解析:垂直/水平拆分与中间件选型

随着业务规模扩大,单机 MySQL 面临 TPS 瓶颈与存储上限。通过分库分表可显著降低单节点压力。本文将从数据库层面解析垂直拆分(按业务库/字段)与水平拆分(取模/范围哈希),并对比 ShardingSphere 等 JDBC 直连层与 MyCAT 等 Proxy 代理层的优劣势,涵盖扩容维护、分布式事务及全局 ID 生成等关键落地问题。
一、为什么需要分库分表
在电商大促或社交网络爆发期,系统流量呈指数级增长,传统“一主多从”的 MySQL 架构往往触及性能天花板。当单表数据量达到千万甚至亿级时,磁盘 I/O、连接数限制以及索引失效都会导致查询和写入性能急剧下降。此时,必须对数据库进行切分优化:
- 连接数耗尽: 单库无法承载所有业务连接,需通过分库分散负载。
- 单表过大: 即使经过查询优化,过大的表仍会导致扫描效率低下,需将数据物理隔离到不同表中。
二、什么是分库分表
分库分表是对关系型数据库数据存储和访问机制的一种补充策略,旨在解决单体数据库的性能与容量极限。
- 分库(Horizontal/Vertical Database Sharding): 将一个逻辑上的大数据库拆分为多个物理上独立的数据库。应用层根据路由规则访问特定的物理库。
- 分表(Table Sharding): 将一个大表的数据打散存储到多个结构相同的物理表中。操作时只需定位到具体的物理表即可。
三、分库分表的几种核心方式
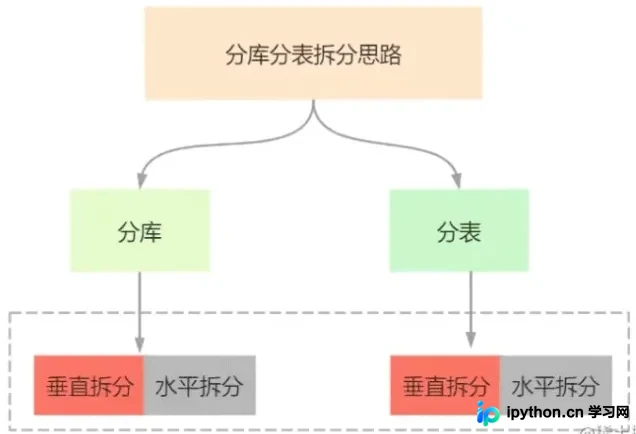
第1步:实施数据库与表的垂直拆分
(1) 数据库垂直拆分:按业务线解耦
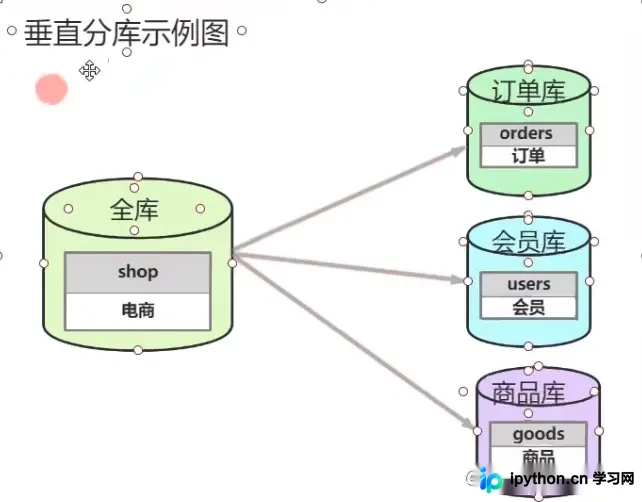
根据业务模块将数据分布到不同的物理库中。例如在电商系统中,将订单、会员、商品分别拆分为“订单库”、“会员库”和“商品库”。这样可以将不同业务类型的读写压力分散到不同的数据库实例上。
(2) 表垂直拆分:冷热字段分离
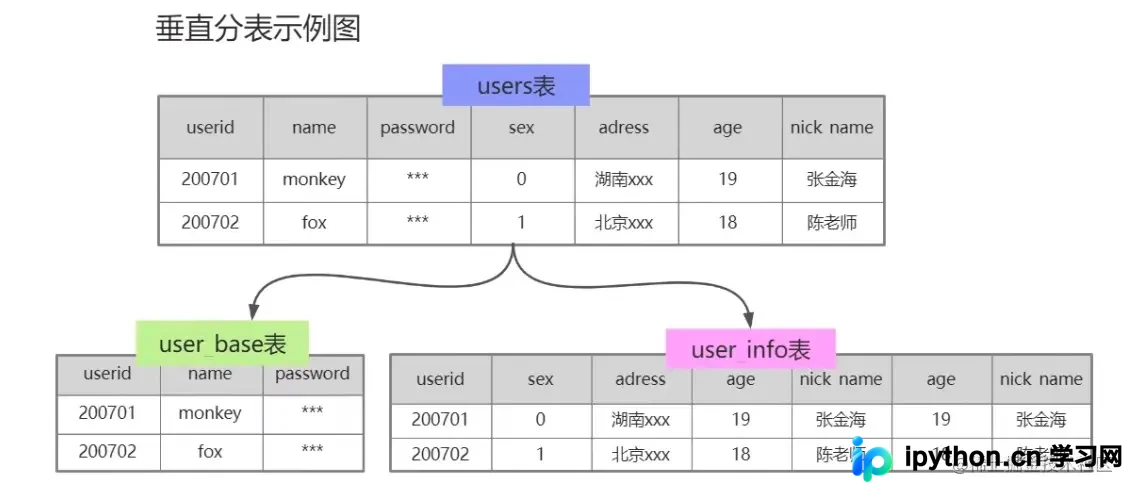
将同一个业务表中访问频率低、体积大的列分离出来。例如,将 user 表拆分为 user_base(存储登录状态、账号密码等高频访问小字段)和 user_info(存储昵称、简介等低频访问大字段)。这有助于减小主表的内存占用,提升热点数据的查询速度。
- 特点: 拆分后的库/表结构各不相同;每个库/表至少保留一个公共关联列(如 ID);各库/表数据的并集构成完整的全量数据。
- 优点: 业务边界清晰,便于独立部署和维护;减少单表字段带来的行宽问题。
- 缺点: 无法解决单表数据量过大的问题;部分跨业务关联的
JOIN查询被禁止,需在应用层(如 Java/Python)通过接口调用组装数据,增加了开发复杂度。
第2步:实施数据库与表的水平拆分
(1) 数据库水平拆分
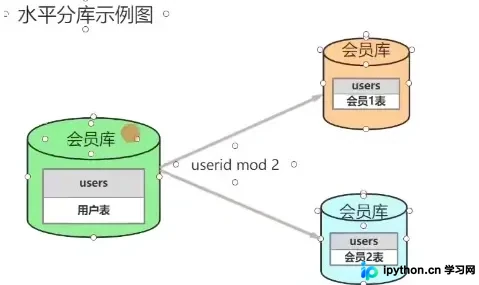
将同一业务的数据按照特定规则分配到多个结构相同的库中。常用策略包括:
- 取模法: 例如以
userId % N为路由依据。若拆分为两库,偶数用户去库A,奇数用户去库B;或者尾号 0-5 去库A,6-9 去库B。 - 其他策略: 也可基于地域、时间片等进行硬编码分配。
(2) 表水平拆分
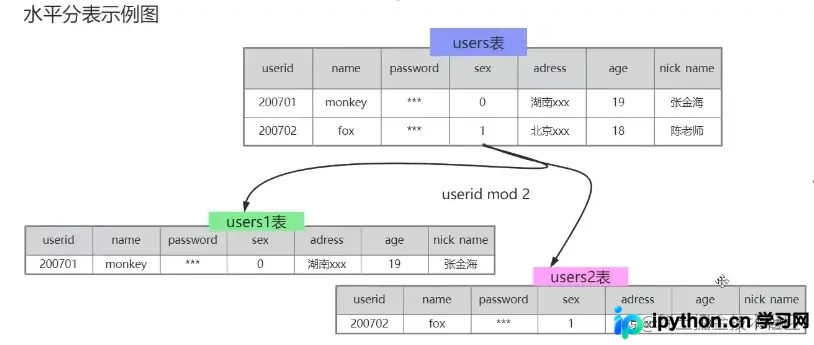
将大表拆分为多个结构一致的子表。仍以 users 表为例,拆分为 users_0 到 users_N。根据 userId 的哈希值或取模结果,将数据均匀分布到各个子表中,确保每个子表的数据量保持在可控范围内。
水平拆分的路由策略详解:
- Hash 分发: 优点是数据分布均匀,请求压力均衡;缺点是扩容困难,新增库后需要迁移大量历史数据以维持平衡。
- Range(范围)分片: 通常按时间范围划分(如按月建库)。优点是扩容简单,直接添加新库即可;缺点是容易形成“热点”,大部分流量集中在最新数据的库中,而历史库负载极低,造成资源浪费。
- 特点: 拆分后的库/表结构完全一致;每个库/表的数据互斥且不重叠;各库/表数据的并集等于全量数据。
- 优点: 有效解决了单表数据量瓶颈;提高了系统的并发写入能力;结构相同意味着代码改造相对标准化。
- 缺点: 运维难度极大,涉及复杂的数据迁移;分片键(Sharding Key)的选择至关重要,选错会导致大量数据倾斜或跨分片查询;分布式事务一致性难以保证。
四、分库分表带来的挑战
引入分库分表后,架构复杂度显著上升,主要面临以下问题:
- 分布式事务: 跨库操作的原子性如何保证?需引入 TCC、Saga 或本地消息表等方案。
- 跨库 JOIN: 关系型数据库的原生
JOIN功能失效,需在应用层完成数据关联。 - 全局唯一 ID: 数据库自增 ID 在多库环境下会冲突,需使用雪花算法(Snowflake)或 UUID 生成器。
- 开发与运维成本: 程序员需掌握分片逻辑,DBA 需具备数据迁移和扩容经验。
五、分库分表中间件选型
实现分库分表通常有两种路径:JDBC 直连层和 Proxy 代理层。目前主流的开源框架包括 ShardingSphere、TDDL 和 MyCAT。
第3步:评估 JDBC 直连层(如 ShardingSphere)
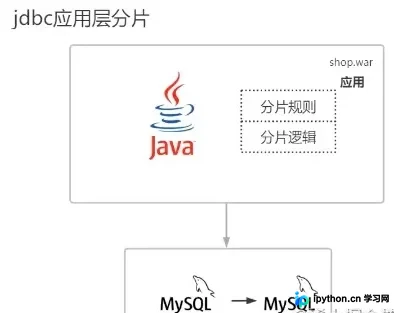
JDBC 直连层(也称应用层代理)将分片逻辑作为 Java 依赖包(JAR/WAR)嵌入到应用中。运行时分片逻辑在 JVM 内存中进行计算:
- 优势: 性能极高,无网络跳转损耗;支持多种数据库方言(MySQL、Oracle 等);社区活跃,Spring Boot 集成度高(如 ShardingSphere-JDBC)。
- 劣势: 仅支持 Java 语言生态;由于分片逻辑耦合在应用代码中,升级中间件需重新发布服务。
第4步:评估 Proxy 代理层(如 MyCAT)
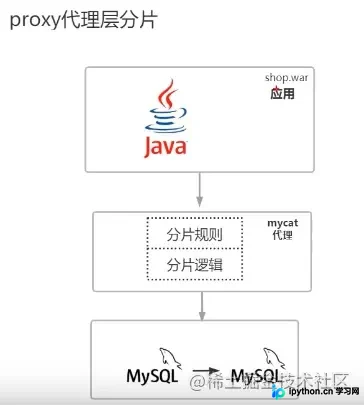
Proxy 层独立于应用服务器运行,像一个透明的 MySQL 网关。应用端像连接普通 MySQL 一样连接 Proxy,由 Proxy 负责解析 SQL 并完成分片路由:
- 优势: 语言无关性(支持 PHP、Go、Python 等任意语言);应用端零感知,无需修改业务代码,只需修改连接地址;便于统一管控分片规则。
- 劣势: 增加了一次网络 IO,略有延迟;对非标准 SQL 的支持可能不如 JDBC 层完善;MyCAT 近年来活跃度有所下降,部分新项目更倾向于使用 ShardingSphere-Proxy。
对比总结
| 维度 | JDBC 直连层 (ShardingSphere-JDBC) | Proxy 代理层 (MyCAT/ShardingSphere-Proxy) |
|---|---|---|
| 性能 | 高(内存操作) | 中等(存在网络跳转) |
| 语言支持 | 仅限 Java | 跨语言(通用 JDBC) |
| 部署维护 | 随应用打包,升级需发版 | 独立部署,集中配置 |
| 数据库兼容性 | 强(支持多引擎) | 弱(通常绑定 MySQL 协议) |
以上就是 MySQL 分库分表的几种方式的详细内容,更多关于 MySQL 数据库优化和高可用架构的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















