Python实现微博移动端动态图片爬取实战
本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
2026-10-16
0



本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
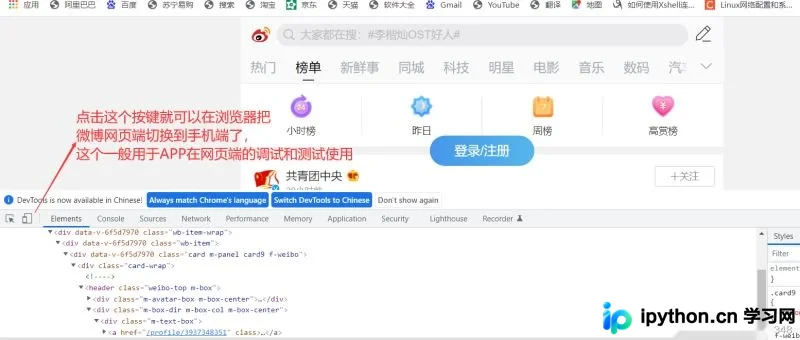
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
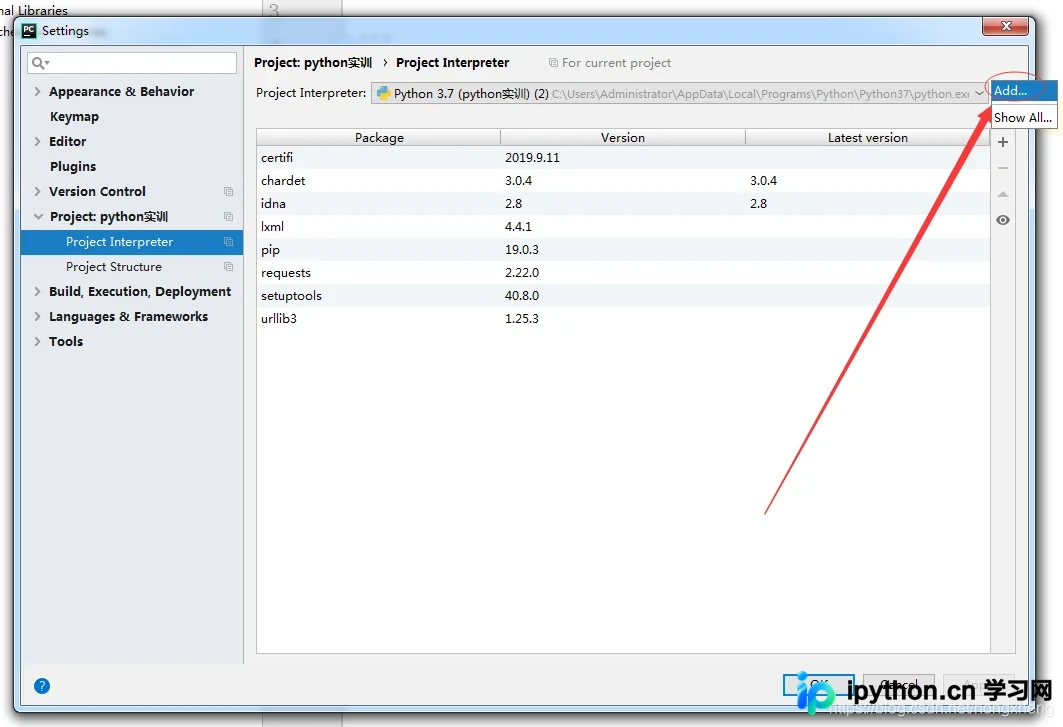
本文详解PyCharm中etree与lxml模块标红问题的两种常见原因及解决方法。首先解决解释器路径不匹配导致的红线,其次通过指定版本下载whl文件并pip安装修复库引用错误,帮助开发者快速恢复代码正常提示。
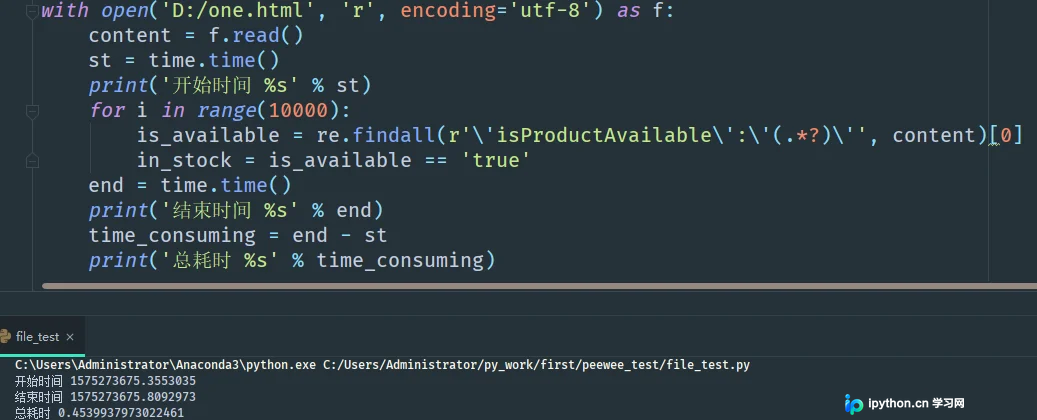
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
本文详解Python中IndexError: list index out of range错误的成因与解决方案。当XPath定位不到数据导致列表为空时,直接索引会触发此异常。通过引入try-except异常捕获机制,可将未定位到的元素赋值为None,从而避免程序崩溃,确保爬虫脚本稳定运行。
本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个在线个性签名生成工具。通过模拟HTTP请求获取签名网站接口数据,解析返回的图片链接,并在GUI界面中展示及保存生成的签名图片,实现从用户输入到结果展示的完整流程。
本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。
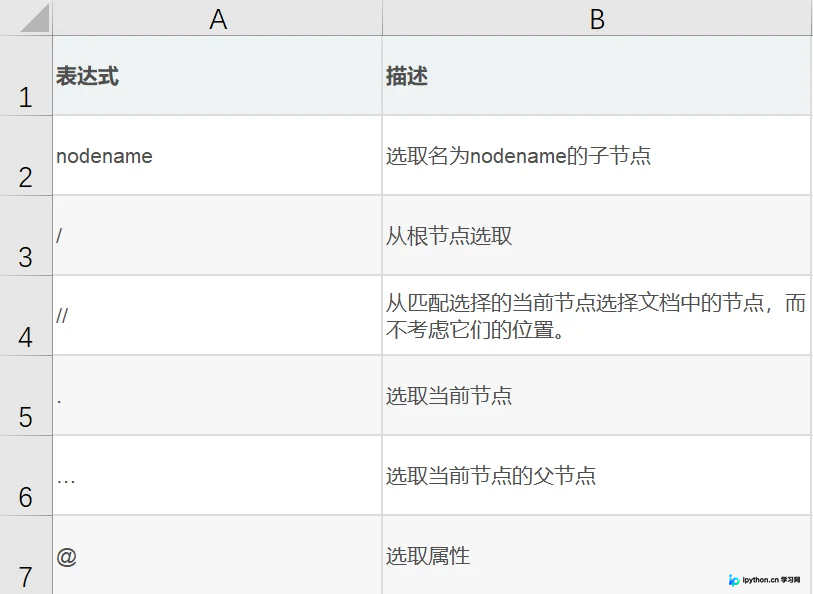
本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
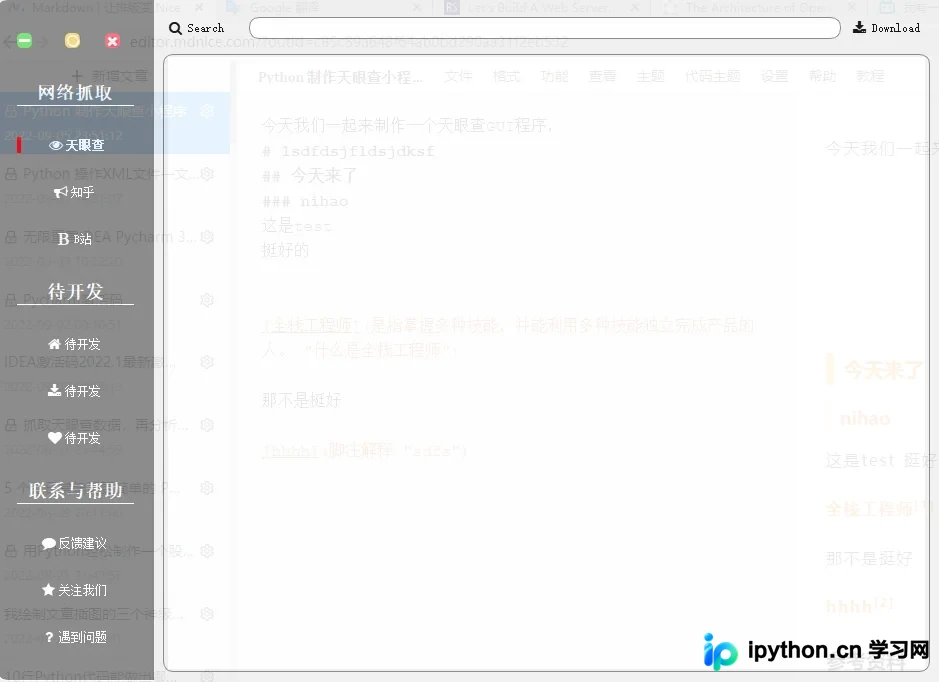
本文详细介绍如何使用Python和PyQt5框架开发一个包含天眼查查询功能的桌面GUI程序。文章涵盖了界面布局设计、样式美化以及通过抓包获取小程序API接口的核心步骤。重点解析了如何构造请求头、处理Authorization令牌及调用API获取公司数据,并展示了将结果集成至GUI组件的完整代码实现。
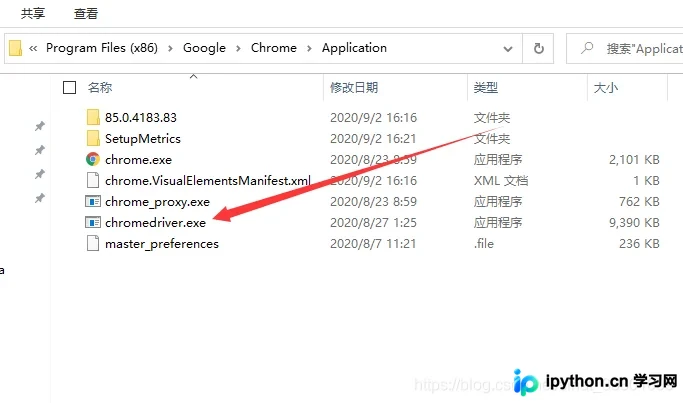
本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。
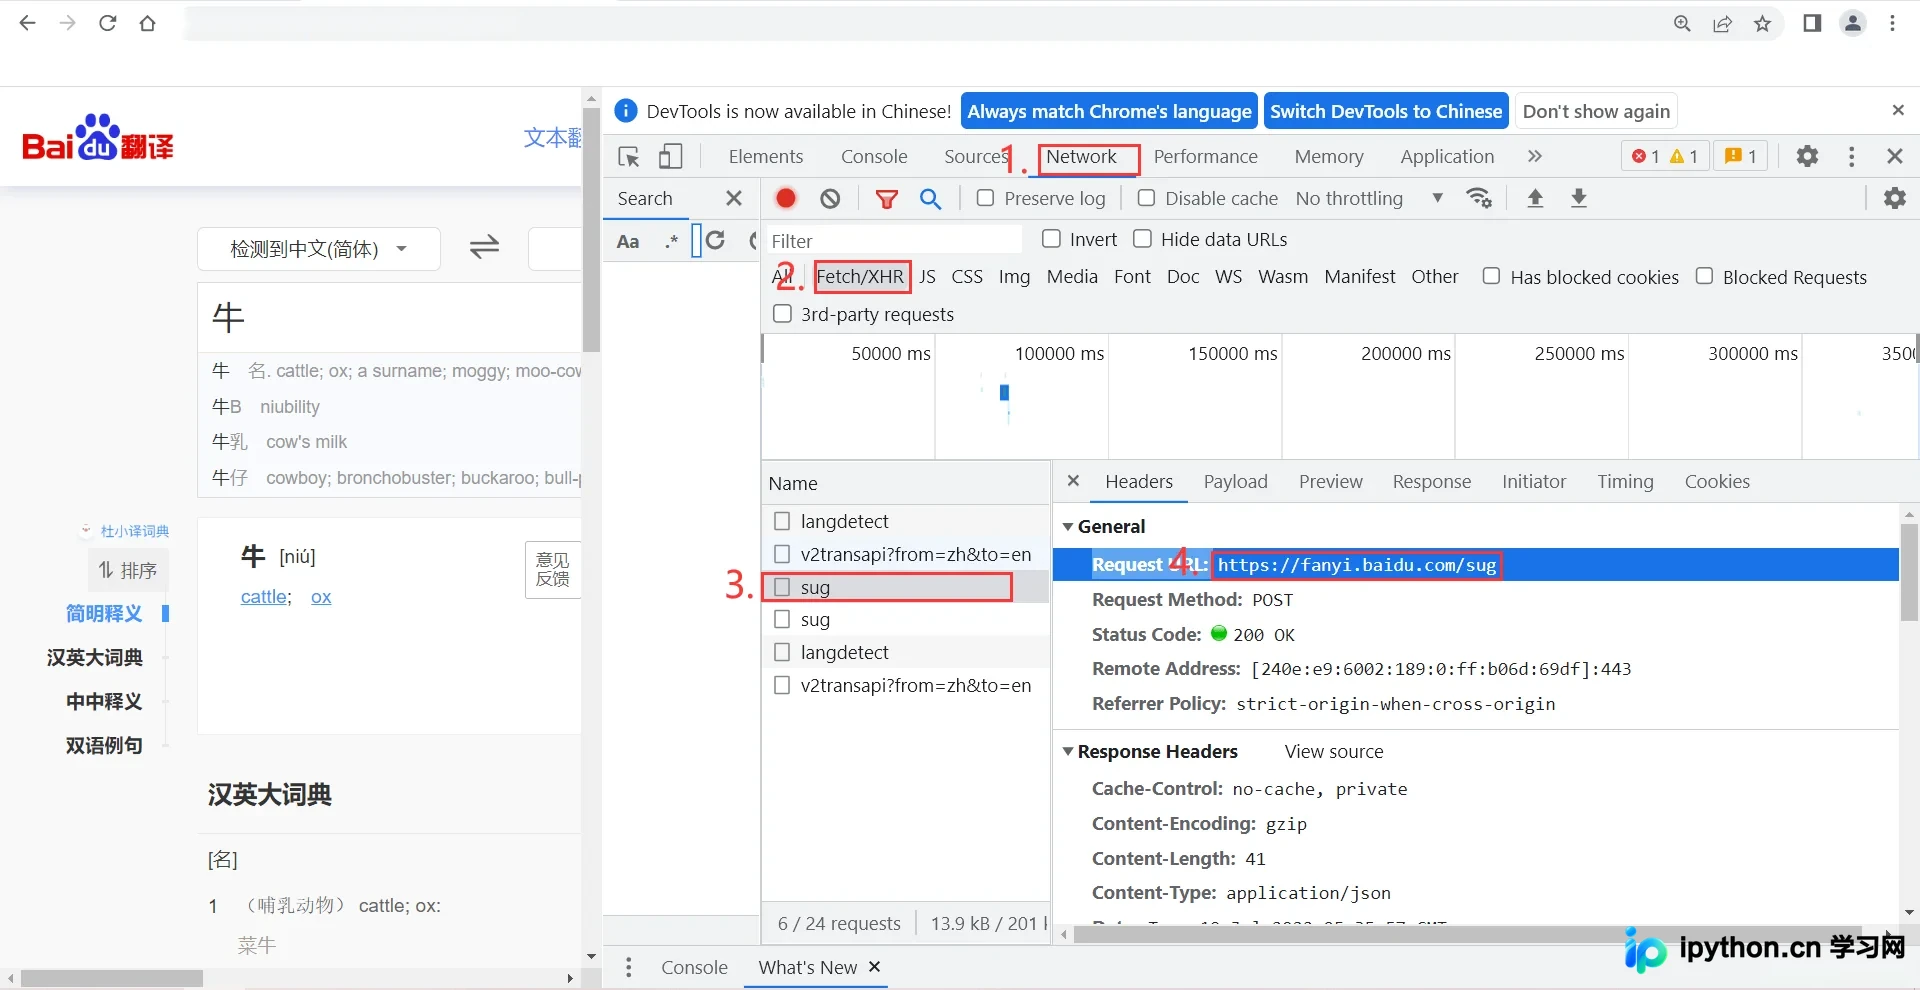
本文详细讲解如何利用Python的requests库对接百度翻译网页接口。通过F12开发者工具分析网络请求,获取SUG接口的URL、Headers及Data参数。文章提供了从导入库、构建请求到解析JSON响应数据的完整代码示例,并演示了如何将功能封装为函数以实现交互式翻译程序,适合Python初学者学习网络请求与数据处理。
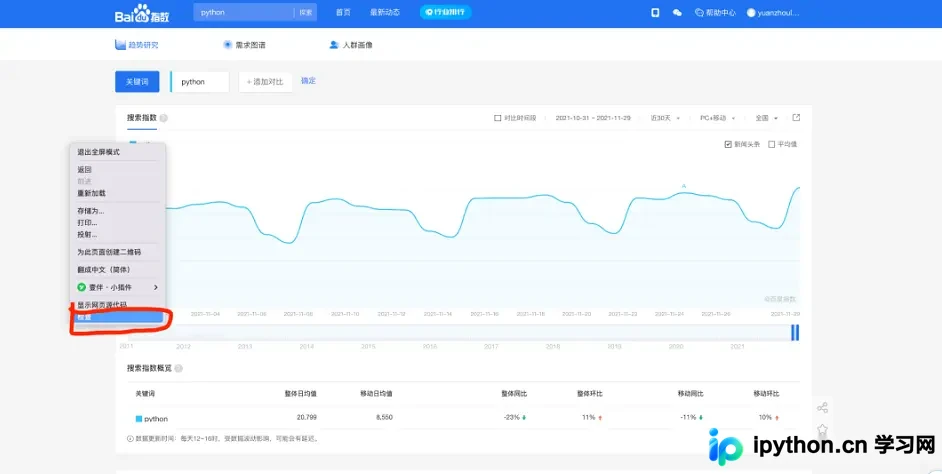
本文介绍如何使用Python脚本获取百度指数数据。通过提取登录Cookie,利用自定义类解析API返回的加密数据,生成Pandas DataFrame。文章包含获取Cookie的步骤、核心代码示例、数据保存为CSV的方法,以及使用Plotly进行时间序列可视化的完整流程,帮助开发者便捷地获取并分析关键词热度趋势。