


Python lxml库Xpath语法实战指南

本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
一、Xpath概述
1、Xpath简介
Xpath(XML Path Language)是一门用于在XML文档中定位信息的语言,支持对元素和属性进行遍历操作。它通过定义路径表达式,帮助开发者在XML文档结构中导航并定位特定节点。
XPath基于XML的树状数据结构,提供了在树形结构中查找节点的能力。最初,XPath旨在作为XPointer与XSL之间的一种通用语法模型,但随后迅速被开发者采纳为一种轻量级的查询语言,并在各类场景中得到了广泛应用。
2、 Xpath的安装
Xpath只是 lxml 库中的一个模块,想要使用 Xpath 那么就需要安装 lxml 库
pip install lxml
二、Xpath的常用规则
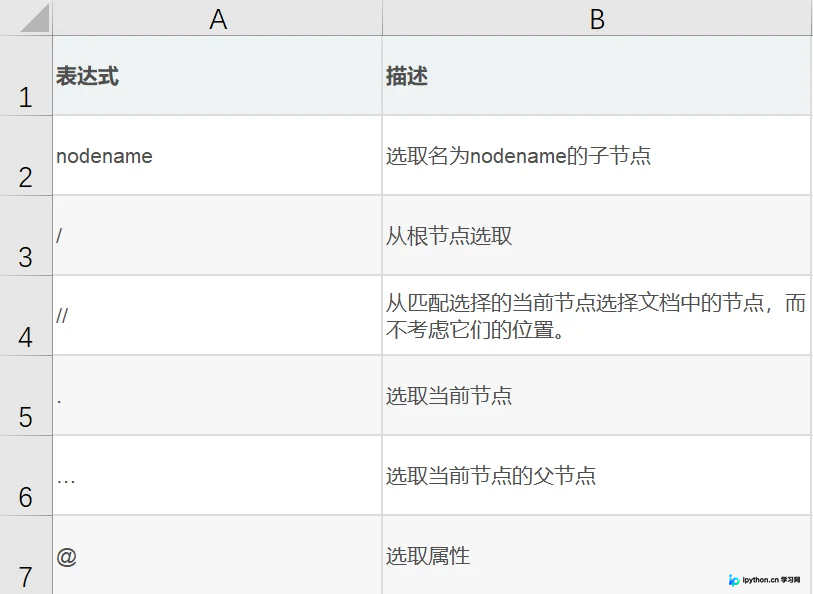
1、路径查找
Xpath 的主要语法
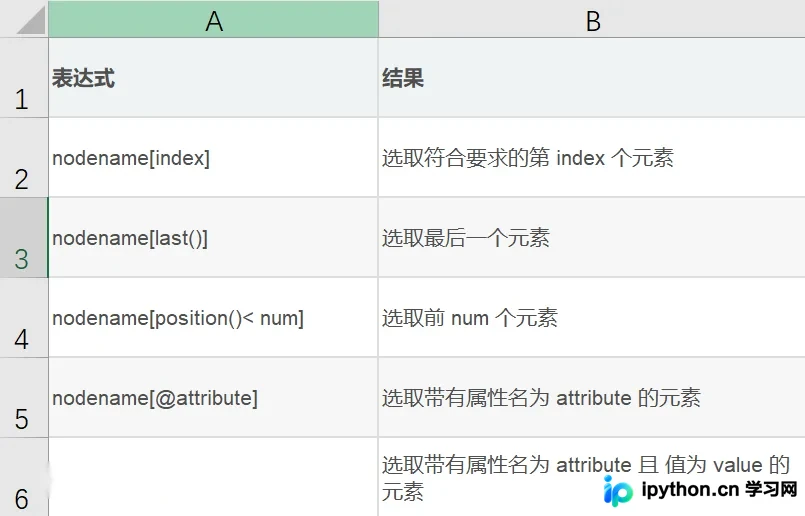
2、节点查找
查找节点的一些语法
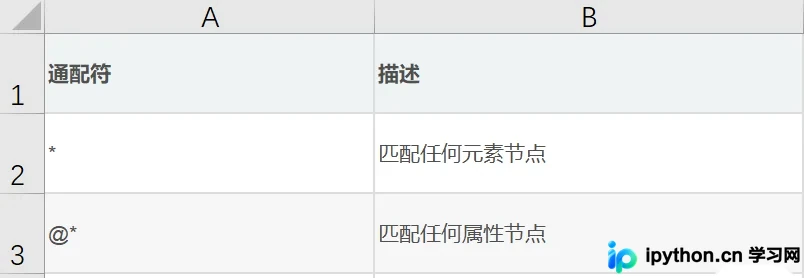
3、未知节点
当匹配过程中遇到路径不确定的情况时,需要使用匹配未知节点的语法。针对此类场景,XPath提供了相应的通配符或灵活匹配策略。
4、获取节点中的文本
通过属性方法可以获取属性内的内容,但是位于节点之间的内容无法获取到,这个时候就可以通过 text() 与 string() 方法来获得其中的文本。
通过 text() 获取某个节点中的文本
In [1]: page.xpath('//li/a[3]/text()')
Out[1]: ['霸道总裁爱上我', '斗罗大陆']
#通过 text() 属性可以很轻松的获取标签之间的文本。
通过 string() 获取某个节点中的文本
In [1]: page.xpath('string(//li[1]/a[3])')
Out[1]: '霸道总裁爱上我'
5、选取多个路径
需要同时查找多个条件时可以通过在路径表达式中使用管道符("|"),选取若干个路径
In [1]: page.xpath('XXXXXXX | XXXXXXXtext()') Out[1]: ['']
总结
到此这篇关于Python操作lxml库实战之Xpath篇的文章就介绍到这了,更多相关Python操作lxml库Xpath篇内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















