Python利用Selenium构建代理IP池访问网站完整教程
本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。
10-16
4




本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。
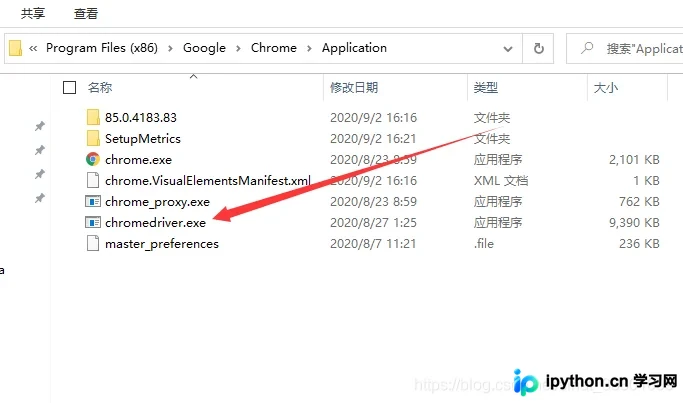
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。
本文介绍如何使用Python脚本自动抓取免费代理IP并验证其可用性。针对网站IP频率限制(如每小时1000条),通过切换代理IP突破限制,将40天的采集时间大幅缩短。脚本包含获取代理列表和测试代理有效性的核心功能,帮助开发者高效解决爬虫被封禁问题。
本文详细总结Python爬虫突破反爬虫机制的核心技术。内容涵盖构建合理的HTTP请求头、Cookie管理、访问延迟控制及代理IP使用。深入解析验证码(简单识别与人工打码)、IP封禁、滑动验证、防盗链关联上下文、JS运算及WebFont等常见反爬策略的应对方案,帮助开发者提升数据采集成功率。
本文介绍Python爬虫使用HTTP代理的必要性及作用,包括提升访问速度、隐藏真实IP以及突破IP限制。同时详细解析了FTP、HTTP、SSL/TLS、SOCKS等常见代理类型的功能与端口,为开发者提供实用的代理配置参考。
本文详细介绍Python爬虫中动态代理IP的切换方法及urllib2超时参数的设置技巧。通过示例代码展示如何构建代理处理器、定期更换IP以规避频率限制,并讲解timeout参数在应对响应缓慢网站时的应用,旨在帮助开发者提升爬虫稳定性与成功率。
本文介绍使用Python编写脚本从指定网站批量爬取高清原图壁纸的方法。通过构建代理IP池以规避反爬机制,利用urllib库进行HTTP请求,并结合正则表达式解析页面结构,实现图片的自动识别与保存。代码包含完整的代理获取、验证及下载逻辑,适合Python初学者参考学习网络爬虫基础技术。
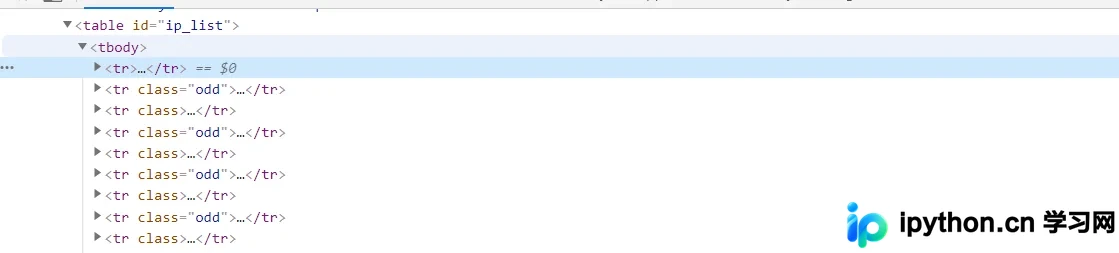
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
本文介绍使用Python爬取免费代理IP网站数据并生成JSON文件的方法。通过lxml模块提取IP和端口,利用requests库向百度发起请求以验证代理可用性,并将有效IP及耗时写入文件。代码包含分页抓取、延时处理及异常捕获,旨在为小型爬虫项目提供低成本的动态IP解决方案。
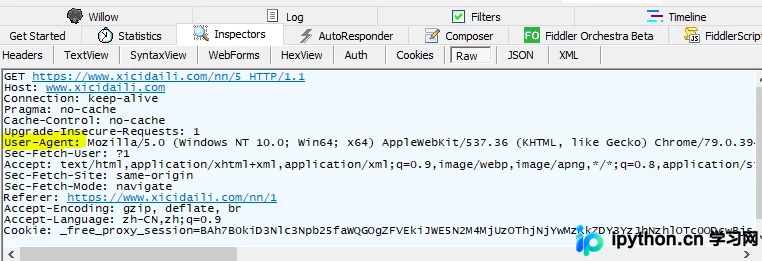
本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。
本文介绍使用Python爬取免费代理IP并验证其可用性的完整流程。通过Requests获取网页源码,利用BeautifulSoup解析提取IP与端口,再向百度发起带代理的请求测试状态码。代码支持自定义页数遍历,最终输出所有有效IP列表,解决手动测试效率低下的问题。
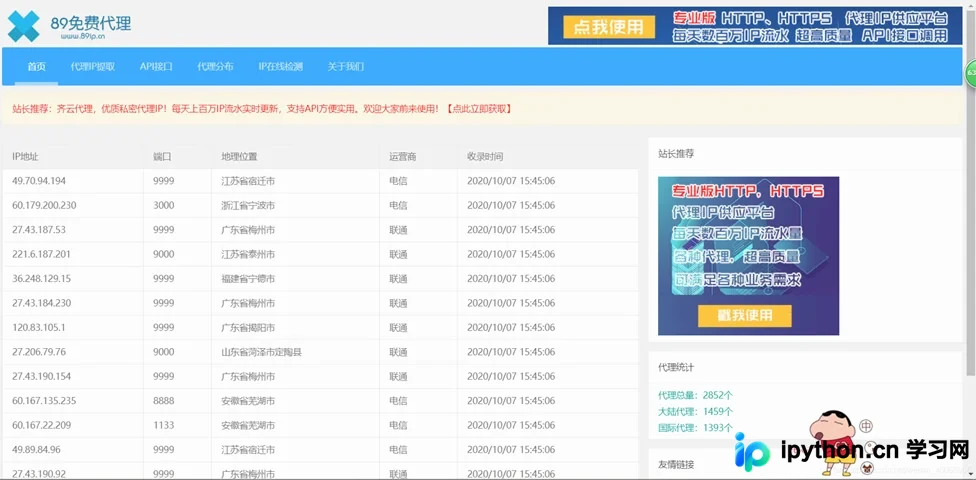
本文提供使用Python requests库构建代理IP池的完整示例代码。内容涵盖从网站抓取代理IP、验证可用性、保存至本地文件以及通过函数获取可用代理的全过程,旨在解决爬虫过程中IP被封禁的问题,为数据库抓取任务提供稳定的网络环境支持。



