解决Pandas生成Excel时的sheet问题的方法总结
本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
2026-10-15
0



本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
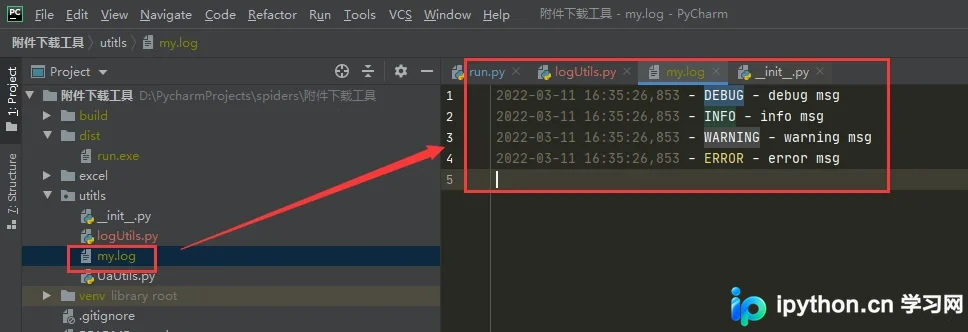
本文介绍如何使用Python和pandas编写命令行脚本处理Excel文件。内容包括封装logging日志模块、接收操作目录、检测并读取唯一Excel文件、自动备份、异常处理、动态添加列以及进度展示与阶段保存等实用技巧,帮助开发者高效完成数据批量处理任务。
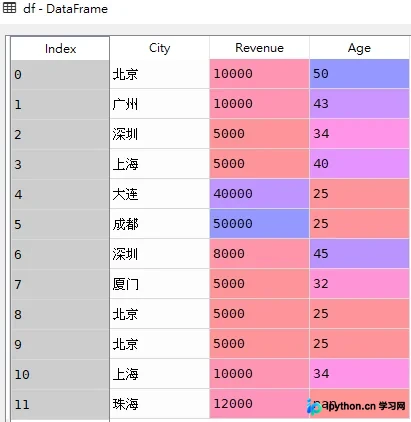
本文详细介绍Pandas库中value_counts()方法的使用。该函数用于统计Series或DataFrame指定列中各值的出现频次,返回排序后的Series。文章解析了sort、ascending、normalize、bins及dropna等关键参数的具体作用,并通过包含城市、营收及年龄数据的DataFrame示例,演示了降序、升序、标准化占比计算以及NaN值处理等实际应用场景。
本文详解pandas核心数据结构Series与DataFrame的创建、索引及排序操作,并介绍numpy高效存取硬盘数据的二进制文件格式。涵盖np.save与np.load的使用,以及np.savez保存多个未压缩数据的方法,帮助开发者掌握Python数据分析与存储的基础技能。
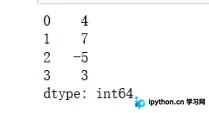
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵,isnull().any()如何识别含缺失值的列,以及isnull().sum()如何统计每列缺失值数量。结合代码示例与结果分析,帮助开发者快速掌握缺失值检测技巧。
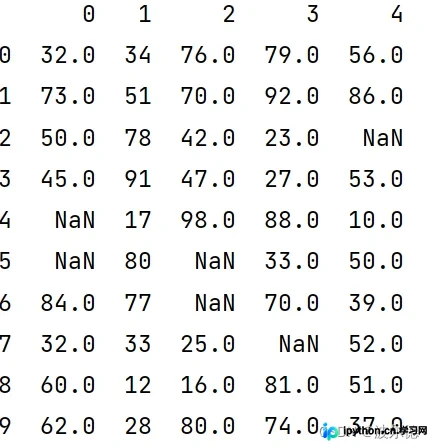
本文详解Pandas中8个常用的set_option配置,涵盖最大行数、列数、列宽、浮点精度、数字格式化及绘图后端等设置。通过调整display相关参数,可优化交互式数据展示效果,提升数据分析效率。
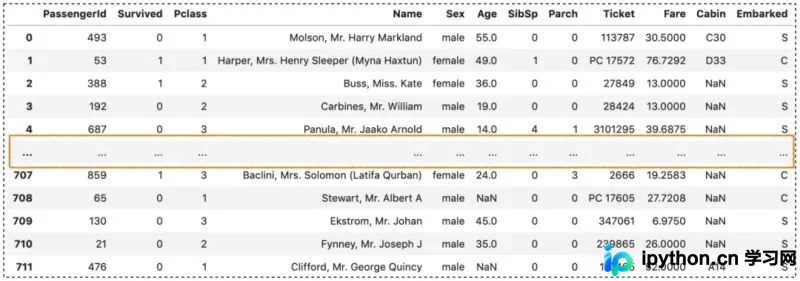
本文详细介绍在 pandas 中如何对 DataFrame 进行列和行的增删改查。涵盖通过直接赋值、assign、insert 方法添加新列,利用 concat 进行水平或垂直连接,以及使用 append 添加行的技巧。同时讲解如何根据条件筛选特定列和行,修改列值及处理缺失数据,提供完整代码示例。
本文详解如何利用Python的Pandas库高效处理包含多个Sheet的Excel文件。通过sheet_name=None参数一次性读取所有工作表,遍历字典对象进行数据清洗(如新增列),并使用ExcelWriter将处理后的多份数据批量写入新Excel文件的对应Sheet中,实现自动化数据处理流程。
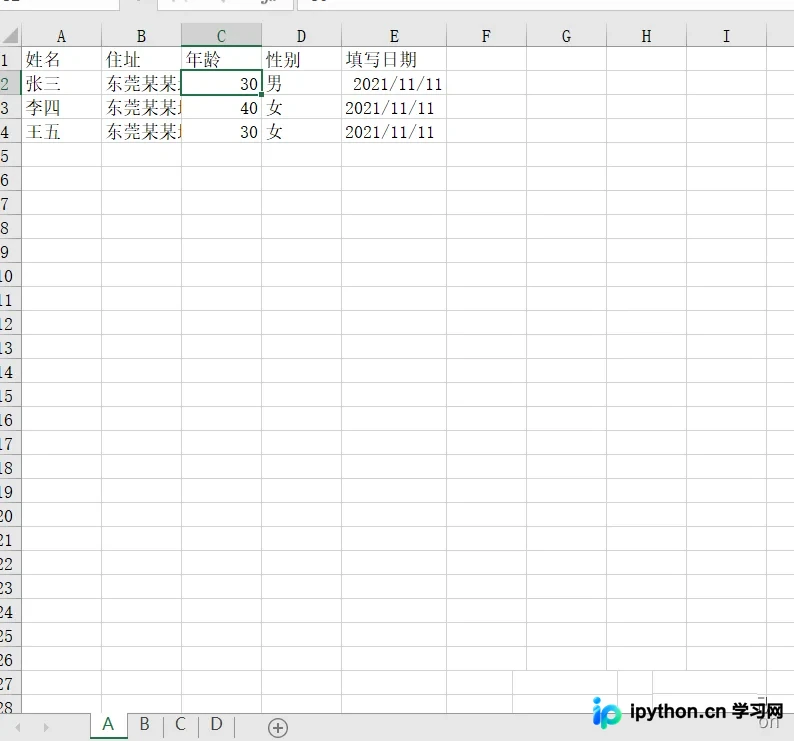
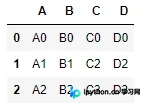
本文详解Python Pandas中合并数据的五个核心函数:join基于索引横向拼接,merge基于键值连接,concat支持横纵双向拼接,append用于纵向追加,combine通过自定义函数按列组合。文章提供各函数的适用场景、参数说明及代码示例,帮助开发者高效处理DataFrame数据整合。
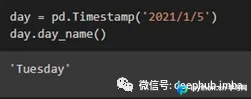
本文详解Pandas中处理时间序列的7个核心函数,涵盖日期名称查询、算术计算、时区转换及数据切片等操作。通过具体代码示例,展示如何利用Timestamp、Timedelta和offsets等工具高效管理金融、零售等领域的时间数据,帮助开发者快速掌握时间序列分析技巧。
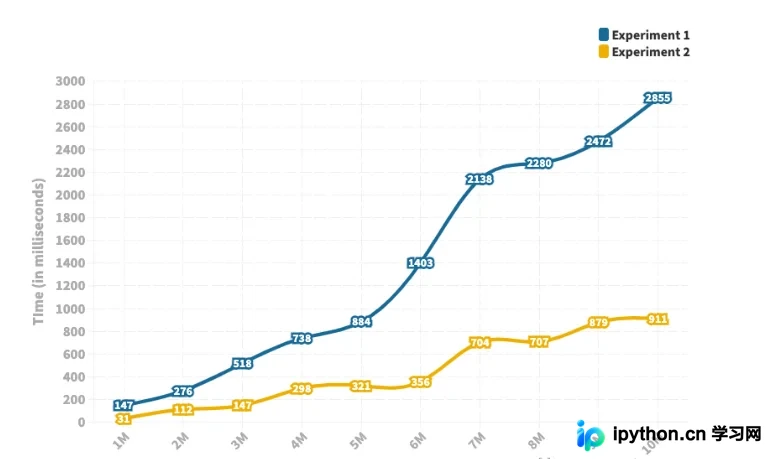
本文深入对比Pandas中Merge、Join和Concat三种数据合并方法的执行效率。通过从100万至1000万行的实验数据发现,Join操作在处理大规模数据时耗时显著低于Merge,且随数据量增长线性增加的速度更慢。建议处理海量数据时优先使用Join以提升性能。
本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。