


Python Pandas合并数据:join、merge、concat、append与combine详解

本文详解Python Pandas中合并数据的五个核心函数:join基于索引横向拼接,merge基于键值连接,concat支持横纵双向拼接,append用于纵向追加,combine通过自定义函数按列组合。文章提供各函数的适用场景、参数说明及代码示例,帮助开发者高效处理DataFrame数据整合。
日前在技术交流群中,有开发者提及在阿里面试时遇到的关于Pandas使用的考题,其中一道经典问题是:Pandas中合并数据的五种方法。
借此机会,本文系统梳理Pandas中用于合并数据的五个关键函数。为聚焦核心用法,具体细节建议参考Pandas官方文档,此处仅做功能性盘点。
- join:主要基于索引进行横向拼接。
- merge:主要基于指定列(键)进行横向拼接。
- concat:支持横向与纵向两种维度的拼接操作。
- append:主要用于数据的纵向追加。
- combine:通过传入聚合函数,将两个DataFrame按列进行组合。
join
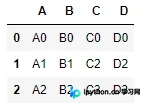
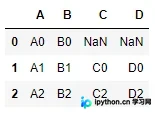
join函数基于索引执行横向拼接。当两个DataFrame索引完全一致时,直接进行横向合并;若索引不一致,缺失部分将填充为NaN值。
索引一致的情况
x = pd.DataFrame({'A': ['A0', 'A1', 'A2'],
                     'B': ['B0', 'B1', 'B2']},
                    index=[0, 1, 2])
y = pd.DataFrame({'C': ['C0', 'C2', 'C3'],
                      'D': ['D0', 'D2', 'D3']},
                    index=[0, 1, 2])
x.join(y)
运行结果如下:
索引不一致的情况
x = pd.DataFrame({'A': ['A0', 'A1', 'A2'],
                     'B': ['B0', 'B1', 'B2']},
                    index=[0, 1, 2])
y = pd.DataFrame({'C': ['C0', 'C2', 'C3'],
                      'D': ['D0', 'D2', 'D3']},
                    index=[1, 2, 3])
x.join(y)
运行结果如下:
merge
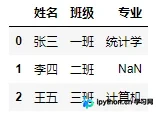
merge函数基于指定列进行横向拼接,其逻辑类似于关系型数据库的连接操作,可根据一个或多个键将不同的DataFrame连接起来。典型应用场景包括:针对同一主键存在两张不同字表的场景,通过主键将数据整合至一张表中。
该函数支持指定how参数以控制连接方式,可选值包括inner(内连接)、left(左连接)、right(右连接)和outer(全连接),默认值为inner。
x = pd.DataFrame({'姓名': ['张三', '李四', '王五'],
                     '班级': ['一班', '二班', '三班']})
y = pd.DataFrame({'专业': ['统计学', '计算机', '绘画'],
                      '班级': ['一班', '三班', '四班']})

pd.merge(x,y,how="left")
运行结果如下:
concat
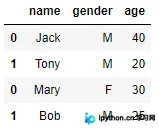
concat函数功能灵活,既可用于横向拼接,也可用于纵向拼接。
纵向拼接示例
x = pd.DataFrame([['Jack','M',40],['Tony','M',20]], columns=['name','gender','age'])
y = pd.DataFrame([['Mary','F',30],['Bob','M',25]], columns=['name','gender','age'])
z = pd.concat([x,y],axis=0)
z
运行结果如下:
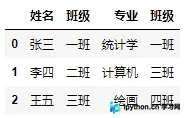
横向拼接示例
x = pd.DataFrame({'姓名': ['张三', '李四', '王五'],
                     '班级': ['一班', '二班', '三班']})
y = pd.DataFrame({'专业': ['统计学', '计算机', '绘画'],
                      '班级': ['一班', '三班', '四班']})
z = pd.concat([x,y],axis=1)
z
运行结果如下:
append
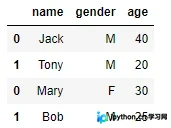
append函数主要用于数据的纵向追加操作。
x = pd.DataFrame([['Jack','M',40],['Tony','M',20]], columns=['name','gender','age'])
y = pd.DataFrame([['Mary','F',30],['Bob','M',25]], columns=['name','gender','age'])
x.append(y)
运行结果如下:
combine
combine函数允许通过传入自定义函数,将两个DataFrame按列进行组合处理。
x = pd.DataFrame({"A":[3,4],"B":[1,4]})
y = pd.DataFrame({"A":[1,2],"B":[5,6]})
x.combine(y,lambda a,b:np.where(a>b,a,b))
运行结果如下:
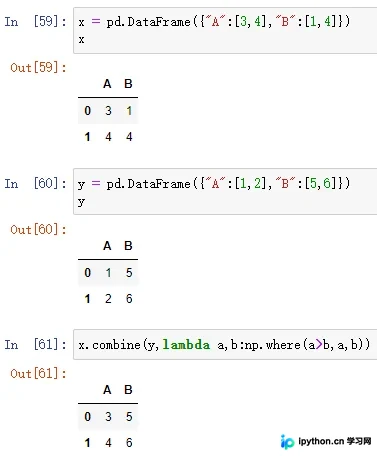
注:上述示例中,combine函数用于返回对应位置上的最大值。
至此,关于Python Pandas中合并数据的五个函数详解已介绍完毕。如需了解更多Pandas合并数据相关内容,建议查阅本站往期文章或继续阅读后续相关教程,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















