Python正则表达式匹配字符串开头并提取内容的方法
本文介绍如何在Python中使用正则表达式匹配以特定关键词开头的字符串。通过re.compile定义模式,利用finditer遍历匹配项并提取内容。示例展示了匹配成功与失败的情况,并提供了在线测试工具链接供参考。



本文介绍如何在Python中使用正则表达式匹配以特定关键词开头的字符串。通过re.compile定义模式,利用finditer遍历匹配项并提取内容。示例展示了匹配成功与失败的情况,并提供了在线测试工具链接供参考。
本文深入解析Python中正则表达式精准匹配时间格式的方法。通过对比基础匹配与严格范围校验,详细拆解时、分、秒的正则逻辑,并提供完整代码示例及在线测试工具推荐,帮助开发者避免无效时间格式匹配,提升数据处理的准确性。
本文介绍如何利用 Python 正则表达式精准匹配字符串中的 HTTP 及 HTTPS 链接。通过编译特定模式,可有效识别包含特殊字符、百分号编码及子域名的 URL。示例代码展示了从文本中提取短链接的全过程,为网络爬虫和数据清洗提供实用参考。
本文介绍在Python中使用正则表达式匹配以https?://开头、以jpg/png/jpeg结尾的字符串,并排除空格及引号等干扰字符的方法。通过实例演示从基础表达式到优化表达式的过程,展示如何利用[^ ",]排除特定字符,实现精准匹配。
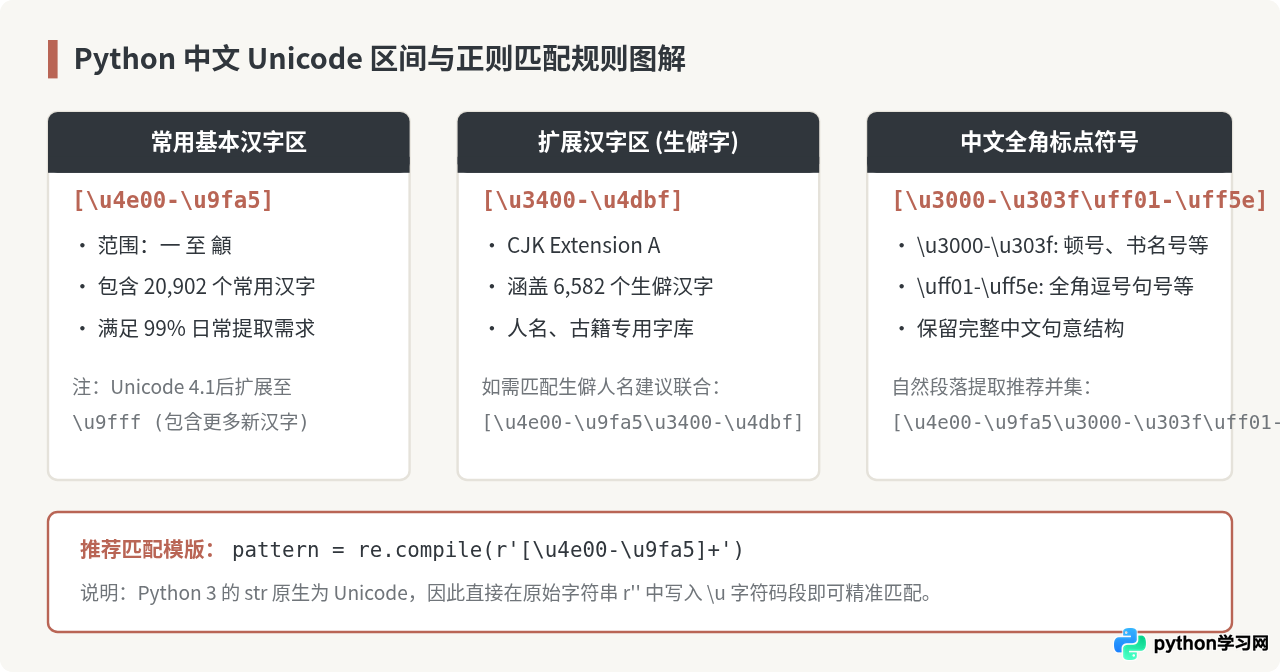
深入分析Python中re.compile预编译对正则表达式匹配性能的实际影响,结合re模块内部缓存机制、高频循环测试与底层开销拆解,提供清晰的使用建议与选型指南。
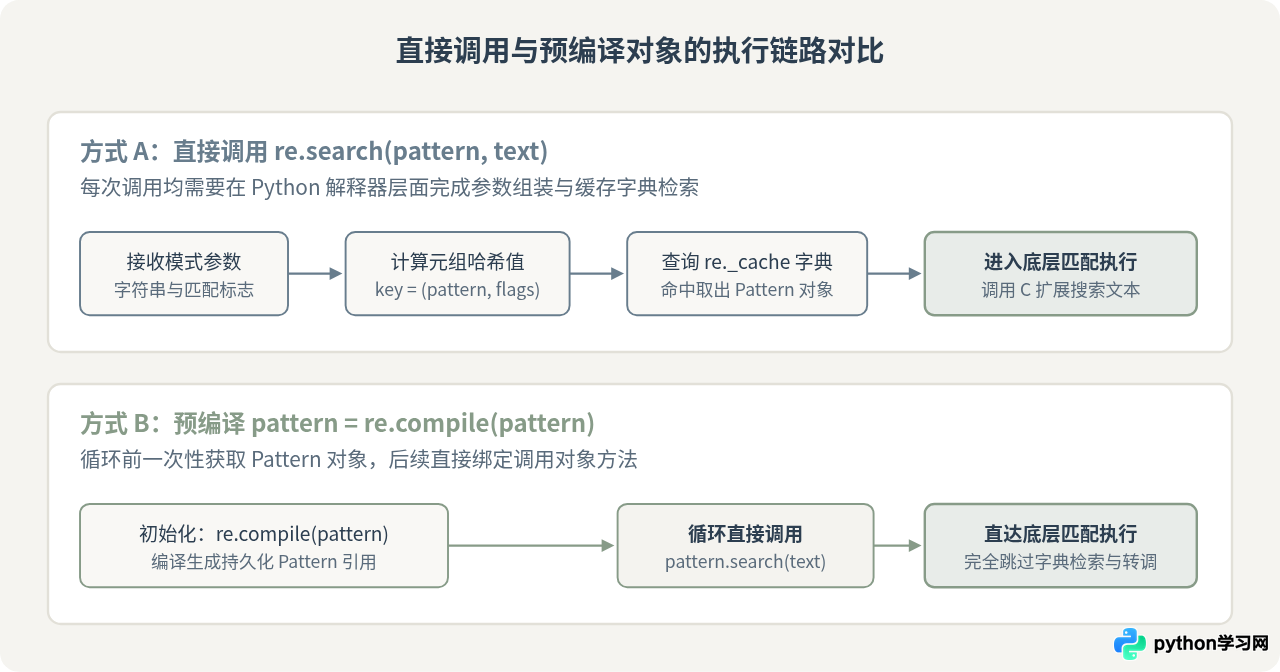
系统介绍在Python中使用re正则表达式模块匹配中文汉字与标点、处理跨行文本与换行符、以及安全转义与清洗特殊字符的具体方法和代码示例。
本文介绍如何使用Python的re模块匹配两个指定短语之间的字符。通过open读取文件,利用re.findall配合非贪婪模式.*?提取目标内容,并遍历打印结果。
本文介绍如何使用Python正则表达式匹配整数和小数。通过\d+匹配一次或多次数字,可获取整数列表;针对小数匹配,结果返回字符串类型。文章包含具体代码示例与结果分析,帮助开发者快速掌握相关技巧。