


有声书长文本怎么批量生成AI配音?效率优化与分段处理指南
针对有声书等长文本场景,本文介绍通过建立可追踪的分段流程来优化AI配音生成效率。重点涵盖书稿整理、段落划分、异步批处理任务管理、读音表固定及合并前的验收标准,旨在减少返工并确保音频质量。
有声书长文本生成AI配音,关键不是把整本书一次塞进输入框,而是建立能定位、复听和补做的分段流程。先用一章确认音色、读音及输出格式,再处理全书,可以减少错误扩散后的返工。确保原始稿件清洁,避免页眉脚注混入,是保证批量生成质量的第一步。
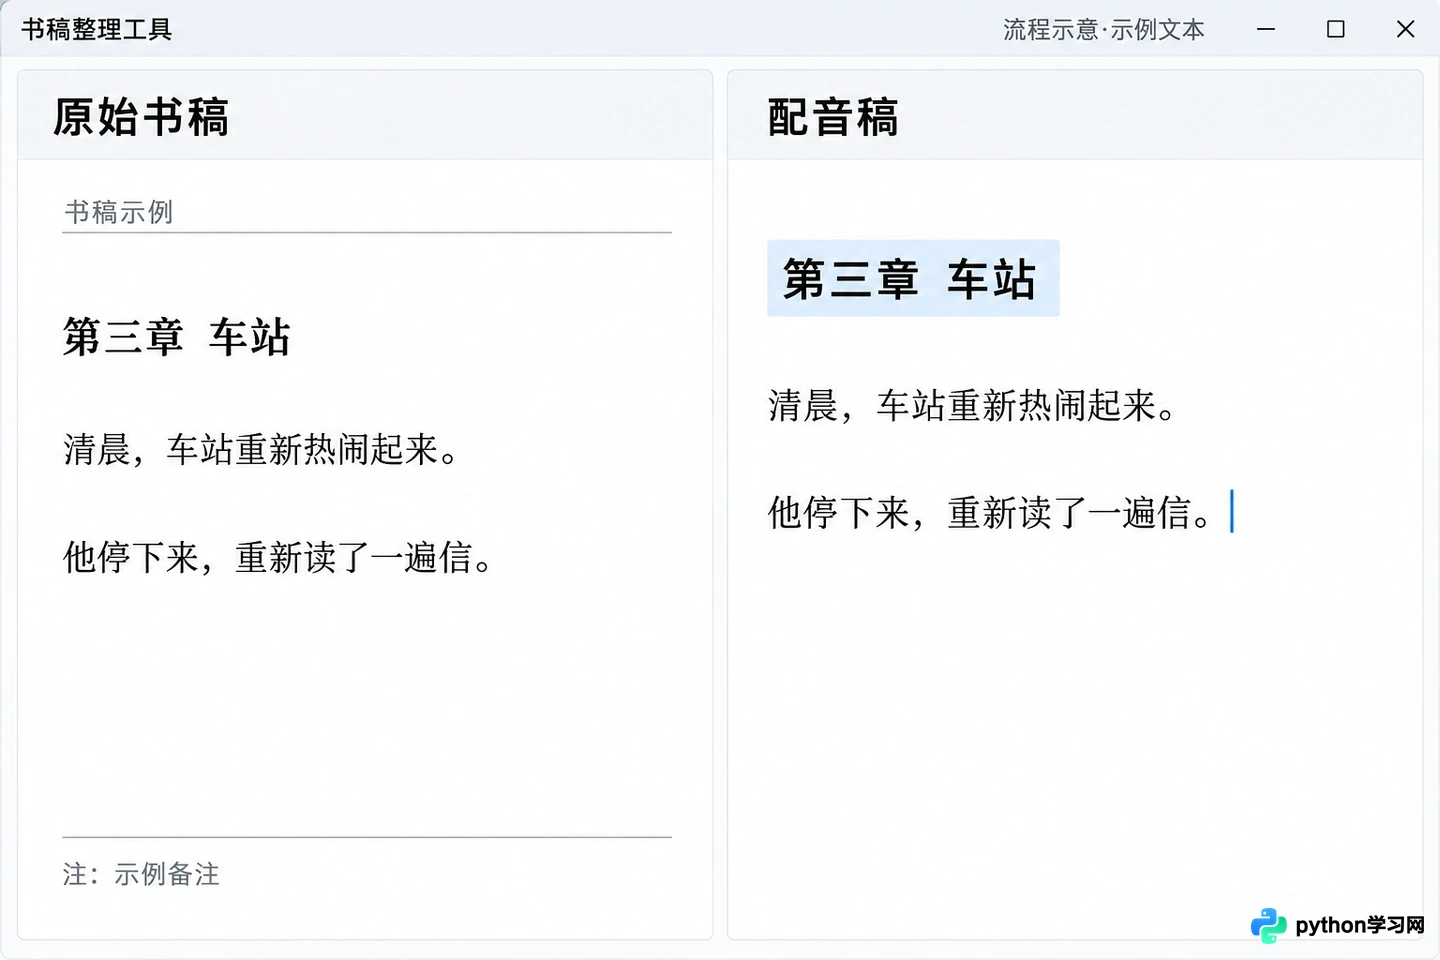
展示去除页眉脚注并按语义分段的书稿文本界面
先把书稿整理成可追踪的段落
保留一份不可覆盖的原始稿,另外建立配音稿。检查目录、页眉、页脚、脚注和分页符,避免它们混入正文朗读。扫描稿或PDF转换文本要抽查阅读顺序,尤其是双栏内容和跨页句子;输入已经错乱,批量生成只会更快地产生错误音频。
先按章节拆,再按完整语义段落划分生成单元。不要在引号未闭合、人物一句话中间或数字与单位之间硬切。每段长度既要小于所用服务的输入限制,也要方便复听和局部修改。没有适用于全部模型的固定字数,先用样章验证,再确定本书的分段尺度。
给每段稳定编号,例如“ch003_seg012”,并记录所属章节、文本版本、音色、参数、任务编号、输出文件与验收结果。文件名可以沿用段落编号,但文本修改后应保存新的版本记录,避免新旧音频混用。
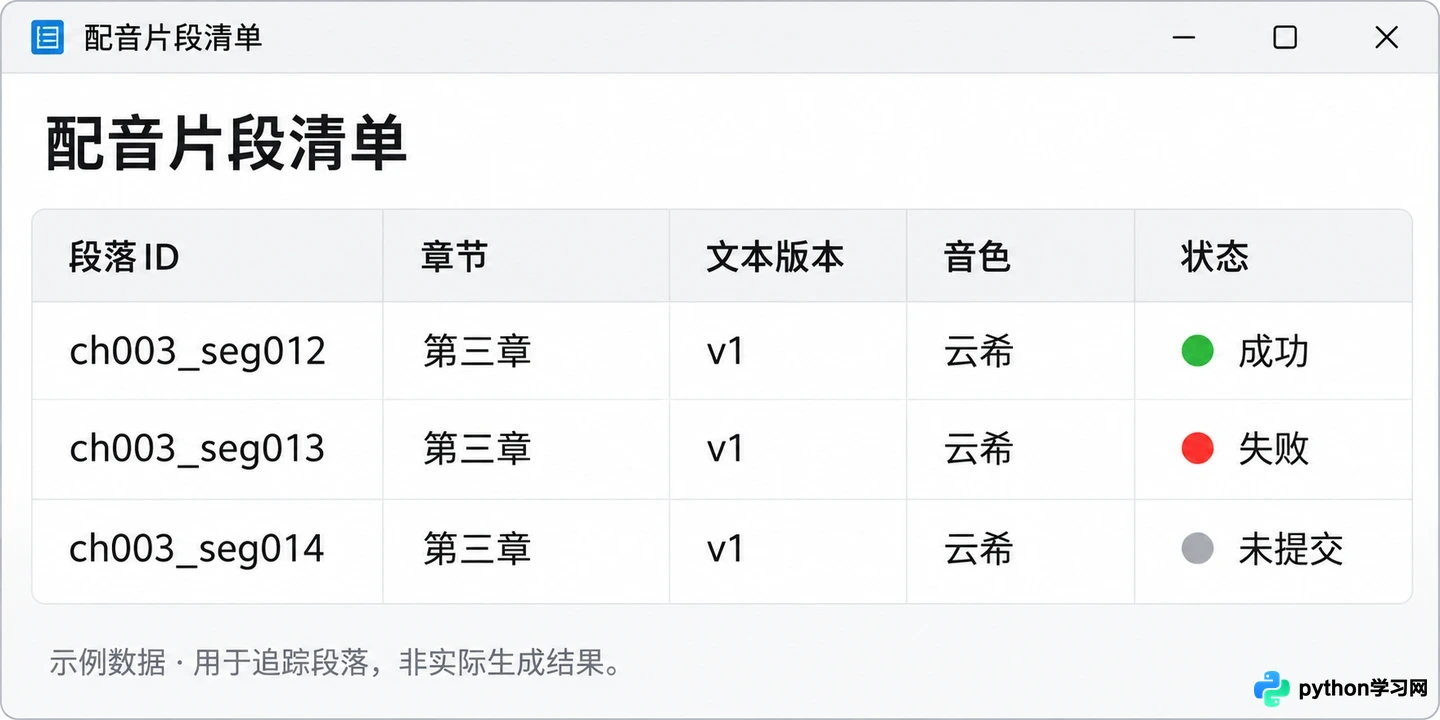
显示包含章节、段落编号、音色参数及状态记录的表格界面
选择长文本流程,不把提交成功当成生成完成
微软Azure语音服务的Batch synthesis API支持异步处理较大量文本,官方说明其可用于有声书等长音频场景。其工作方式是提交任务、查询状态,成功后再下载结果,而非提交时立即获得成品音频。具体地区、账户资格和输入限制应按当前官方文档核对。
如果使用网页创作工具,则先确认有没有章节或项目管理、局部重新生成和导出能力;不要凭“支持长文本”的宣传推断可以一次处理整本书。没有批量入口时,也可以按编号逐段生成,保留完整记录,不能用不受支持的操作冒充官方批处理。
批处理的价值是减少手动重复和便于跟踪,并不保证任何负载下都更快。先跑小批,确认每段都能对上原稿,再按服务允许的额度和并发处理后续内容。将成功结果及时保存到自己的项目目录,不把临时下载地址当作永久档案。
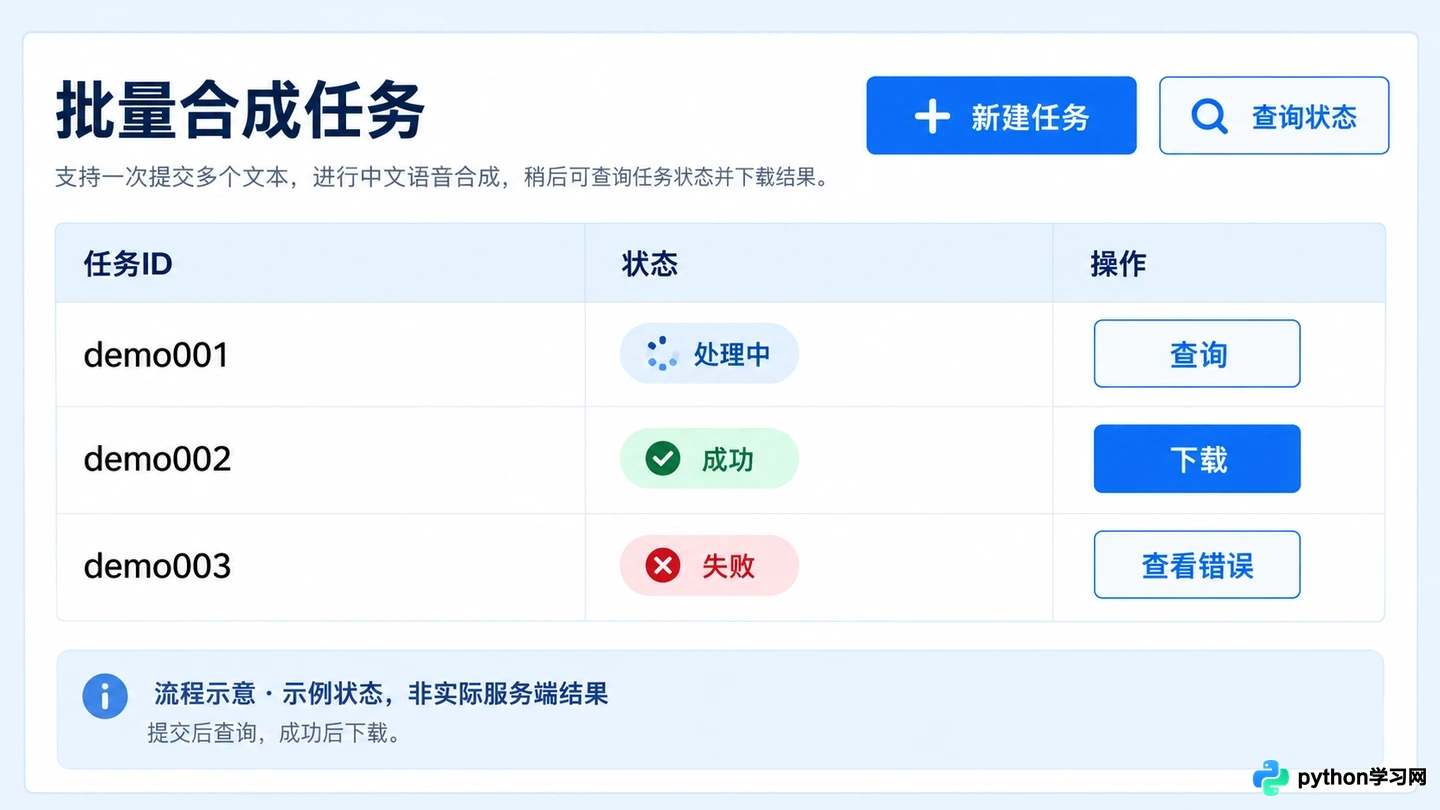
展示提交长文本任务后查询处理状态的后台管理面板
效率优化先减少返工,再考虑增加并发
固定音色、模型和基本参数,建立人名、地名、缩写及多音字的读音表。先听样章中的关键词和长句,确认处理方法之后再批量推进。换音色或模型时重新抽样,不假设同一套读音标记在所有工具里都有效。
任务记录至少区分未提交、处理中、成功、失败和结果待确认。网络超时只说明当前没有收到明确结果,不一定说明服务未接收任务。先用已有任务编号查状态,再决定下一步,避免重复提交带来重复计费和多份难以辨认的音频。
明确限流时按服务返回的要求等待,不能靠提高并发解决。对于已确认失败的段落,先记录错误并检查输入或配置;修正后只补做该段。保存成功片段,比每次整章重跑更容易控制成本,也便于发现重复段和漏段。
合并之前先验收顺序和衔接
下载完成不等于可以直接发布。逐段对照正文检查漏读、重复、错读及句子截断,章节开头、结尾和人物对话处尤其需要复听。长书可分批交接,但抽查不能代替最终的完整试听。
合并时统一音频规格,按段落编号排序,并检查相邻片段的停顿、响度和语速衔接。编号最好固定宽度,避免文件按字符串排序时把第十段放在第二段之前。压缩编码反复转换可能引入损失,尽量保留一套高质量中间文件,再按最终平台要求导出。
另外保留书稿和声音的使用授权记录,确认平台条款及发布要求。完成后的项目应包含版本明确的配音稿、片段清单、已验收音频与整章成品;下次改一个段落时,才能知道替换哪一段,而不是重新寻找整本书的生成现场。
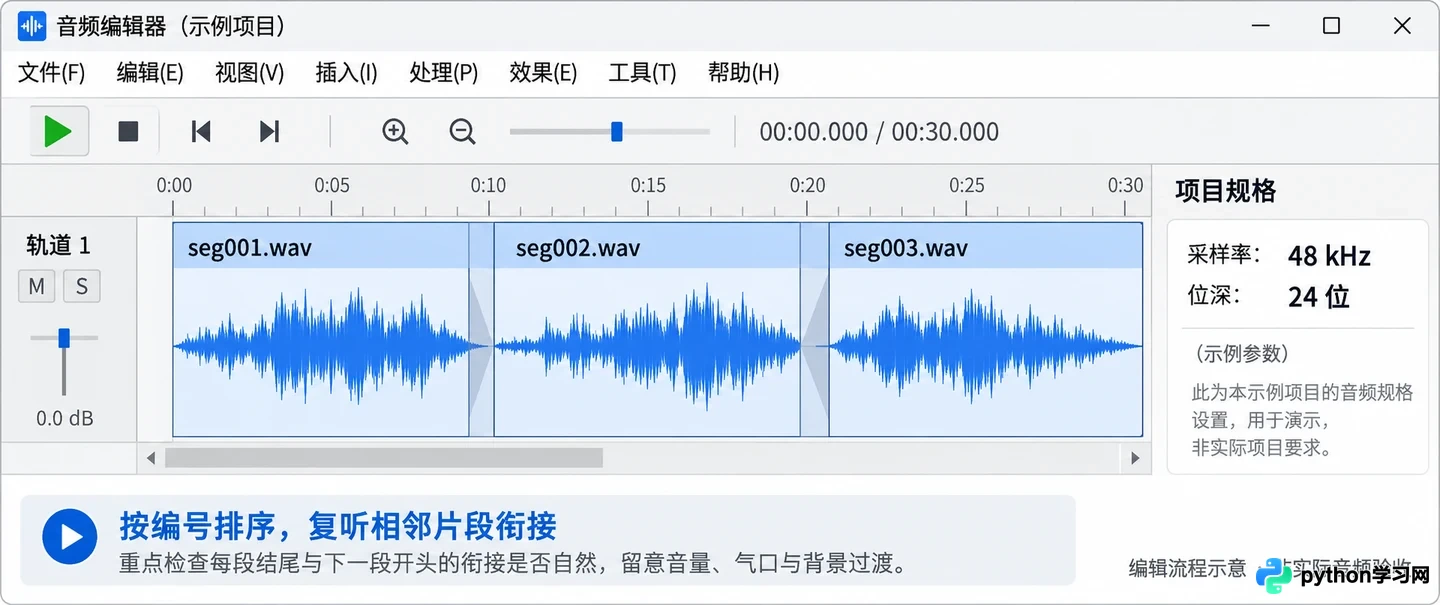
显示按编号排序的音频片段波形及合并预览界面
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















