


Python正则匹配中文、换行符及特殊字符的处理方法
系统介绍在Python中使用re正则表达式模块匹配中文汉字与标点、处理跨行文本与换行符、以及安全转义与清洗特殊字符的具体方法和代码示例。
在 Python 中使用 re 模块进行文本清洗与爬虫解析时,中文字符匹配的核心在于利用 Unicode 编码区间(常用 [\u4e00-\u9fa5]),换行符处理依赖 re.DOTALL(简写为 re.S)或全字符集 [\s\S],而特殊字符匹配的关键则是区分静态转义与动态变量使用的 re.escape()。本文通过明确的语法规则、完整代码示例与排坑清单,系统梳理这三类高频需求的落地解法。
一、匹配中文字符的实用方法与字符集范围
Python 3 原生采用 Unicode 编码,字符串中的每一个中文字符都对应特定的十六进制数值码位。使用正则表达式提取中文,本质上就是定义字符组 [...] 并在其中限定合法的 Unicode 码位区间。
日常开发中最基础也是最常用的是 CJK 基本汉字区间:[\u4e00-\u9fa5]。该区间收录了从“一”(\u4e00)到“龥”(\u9fa5)共 20,902 个汉字,足以覆盖 99% 以上的标准现代汉语词汇提取任务。
import re

text = "用户ID: 10842,姓名:李明华,地址:北京市朝阳区(非VIP用户)。"

# 1. 仅提取连续的汉字
chinese_words = re.findall(r'[\u4e00-\u9fa5]+', text)
print("提取的纯汉字词列表:", chinese_words)
# 示例输出:['用户', '姓名', '李明华', '地址', '北京市朝阳区', '非', '用户']

# 2. 清洗非汉字字符,仅保留中文纯文本
clean_text = "".join(chinese_words)
print("拼接纯汉字内容:", clean_text)
# 示例输出:用户姓名李明华地址北京市朝阳区非用户
在实际业务场景中,仅匹配 [\u4e00-\u9fa5] 常常会遗漏中文标点符号(如书名号《》、顿号、全角逗号句号)或特殊生僻字(如人名中的“䶮”、“堃”等)。为此,我们需要根据场景扩充字符集范围:
- CJK 扩展 A 区汉字(生僻字):编码区间为
[\u3400-\u4dbf],涵盖古籍与现代人名中多出的 6,582 个字; - 中文标点符号(全角标点):主要分布在 CJK 标点符号区
[\u3000-\u303f](包含全角空格、顿号、书名号、破折号)以及半角/全角字符形式区[\uff01-\uff5e](包含全角“!”,“?”,“,”,“。”等)。
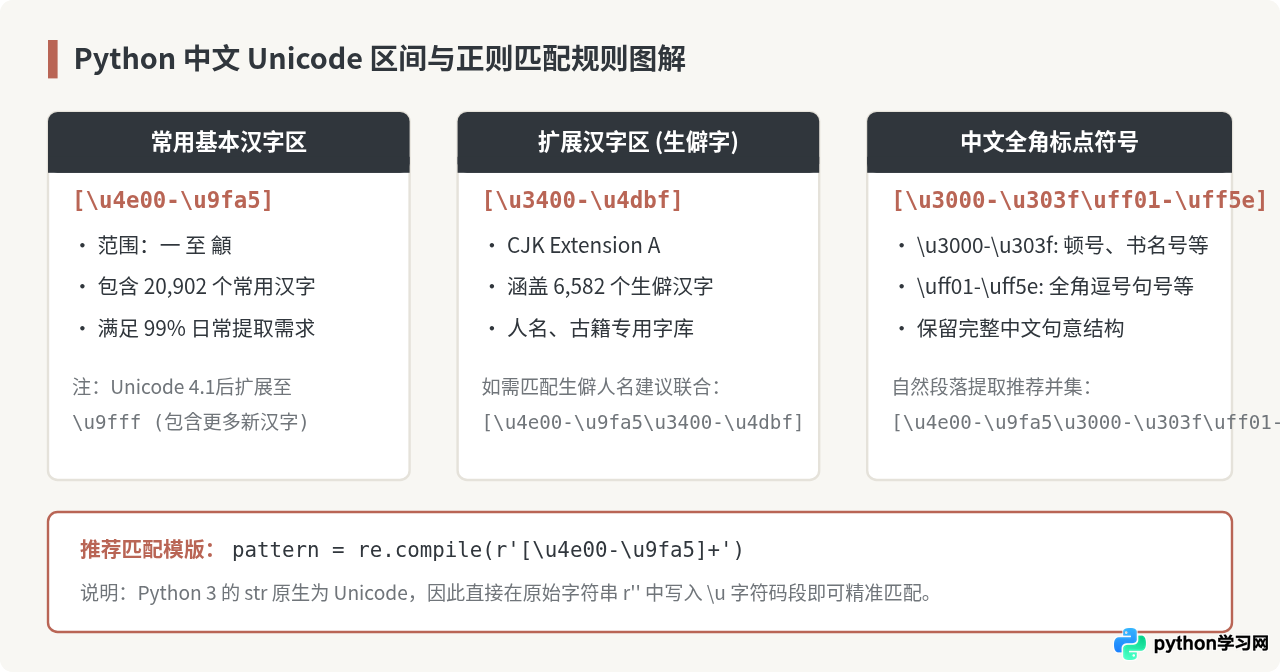
如果要提取一段包含标点符号的完整自然语句,只需把标点符号区间并入中括号中:
# 包含汉字与全角中文标点的完整句子提取
sentence_pattern = r'[\u4e00-\u9fa5\u3000-\u303f\uff01-\uff5e]+'
result = re.findall(sentence_pattern, "《深入Python》是一本好书,值得精读!")
print("完整中文句子片段:", result)
# 示例输出:['《深入Python》是一本好书,值得精读!']
二、跨行匹配与换行符处理技巧
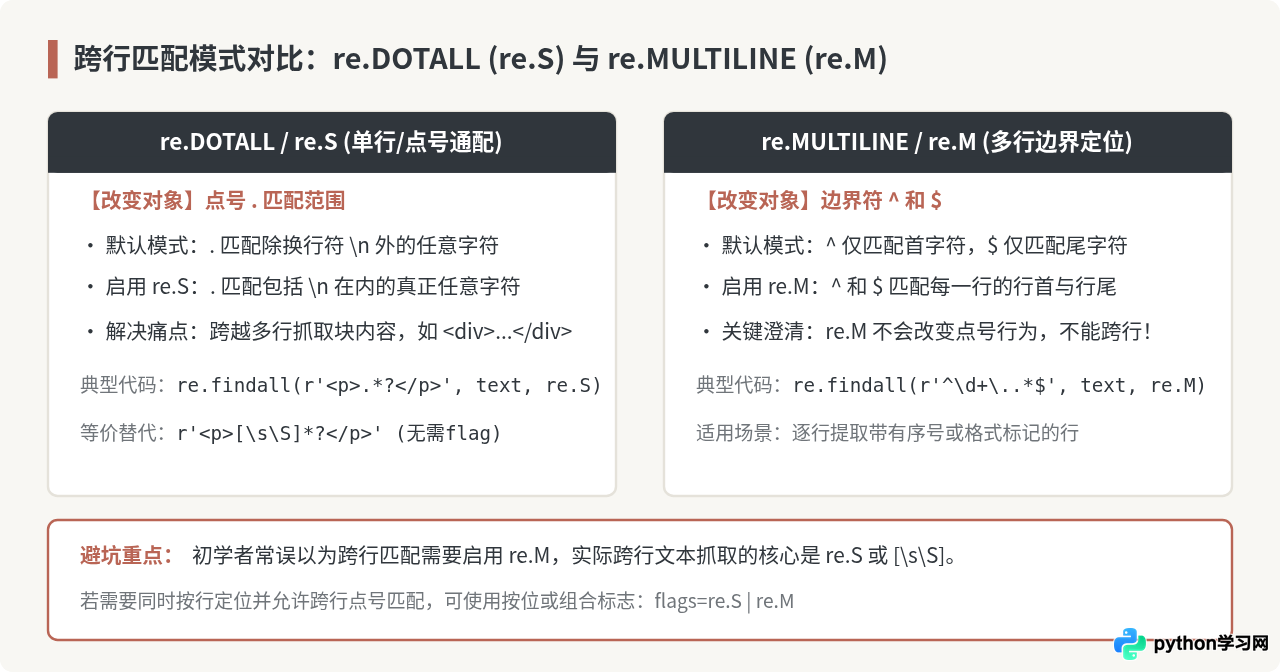
在处理多行文本、抓取网页 HTML 块或解析日志时,开发者常遇到点号 . 无法抓取到预期内容的问题。原因在于正则表达式规范中,元字符点号 . 默认匹配除换行符(\n 或 \r\n)之外的任意单个字符。
解决跨行匹配主要有两种标准做法:
方法 1:使用 re.DOTALL(即 re.S)标志
给匹配函数传入标志参数 flags=re.DOTALL 或简写 flags=re.S。此时点号 . 的匹配边界被扩展至包含换行符在内的真正“全字符”。
html_content = """<div class="content">
    <p>这是第一段正文</p>
    <p>这是第二段跨行正文</p>
</div>"""

# 默认模式下匹配失败(返回空列表),因为中间存在换行符
res_default = re.findall(r'<div class="content">.*?</div>', html_content)
print("默认匹配结果数量:", len(res_default))  # 输出 0

# 开启 re.S 后跨行匹配成功
res_dotall = re.findall(r'<div class="content">.*?</div>', html_content, re.S)
print("开启 re.S 结果数量:", len(res_dotall))  # 输出 1
方法 2:使用字符集并集 [\s\S] 无标志跨行
由于 \s 匹配所有空白字符(包括空格、制表符 \t、换行符 \n 和 \r),而 \S 匹配所有非空白字符,两者的合集 [\s\S] 能够无条件覆盖世界上所有的单个字符,无需显式声明 re.S。
# 使用 [\s\S]*? 进行非贪婪跨行匹配
res_set = re.findall(r'<div class="content">[\s\S]*?</div>', html_content)
print("使用 [\\s\\S] 匹配成功:", bool(res_set)) # 输出 Truere.S 改变的是点号 . 的匹配范围,使其能吞噬换行符;而 re.M 改变的是行首 ^ 和行尾 $ 的定位锚点,使其能够匹配每一行的行首与行尾。re.M 本身并不会赋予点号跨行能力!
三、特殊字符与元字符的精准转义与清洗
在正则表达式中,存在一组保留作为语法控制的元字符:. * + ? ^ $ { } [ ] ( ) | \。如果我们需要在待匹配文本中寻找这些字符本身的字面值,就必须进行正确的转义。
1. 静态字符串与原始字符串 r"..."
在 Python 源码中书写正则表达式时,必须始终使用原生字符串前缀 r"..."。如果不加 r,Python 字符串解释器本身会先执行一次反斜杠转义,导致传给正则引擎的斜杠数量折半,容易产生 re.error 或静默匹配错误。
# 匹配数学表达式中的加号和括号
calc_str = "计算公式:(a + b) * 2.5 = result"

# 正确写法:前缀 r 配合单个反斜杠转义
pat = r'\([a-z]\s\+\s[a-z]\)'
print("匹配结果:", re.findall(pat, calc_str))  # 输出:['(a + b)']
2. 动态变量与 re.escape() 的绝对防御
如果待匹配的目标关键词来自外部输入(如前端用户提交的搜索词、配置文件读取的关键词),绝不能使用简单的字符串格式化拼接成正则,否则用户输入中的 ?、* 或未闭合的 ( 将直接触发语法解析崩溃,甚至造成 ReDoS 正则拒绝服务攻击。
Python 提供了 re.escape() 函数,能够自动为字符串中的所有正则元字符添加转义反斜杠:
user_keyword = "C++ (v2.0) [测试版]?"

# 动态安全转义
safe_keyword = re.escape(user_keyword)
print("转义后的安全模式串:", safe_keyword)
# 示例输出:C\+\+\ \(v2\.0\)\ \[测试版\]\?

# 构造动态查询
doc = "本次升级包含:C++ (v2.0) [测试版]? 全部更新项。"
match_res = re.search(safe_keyword, doc)
if match_res:
    print("精准定位到关键词:", match_res.group(0))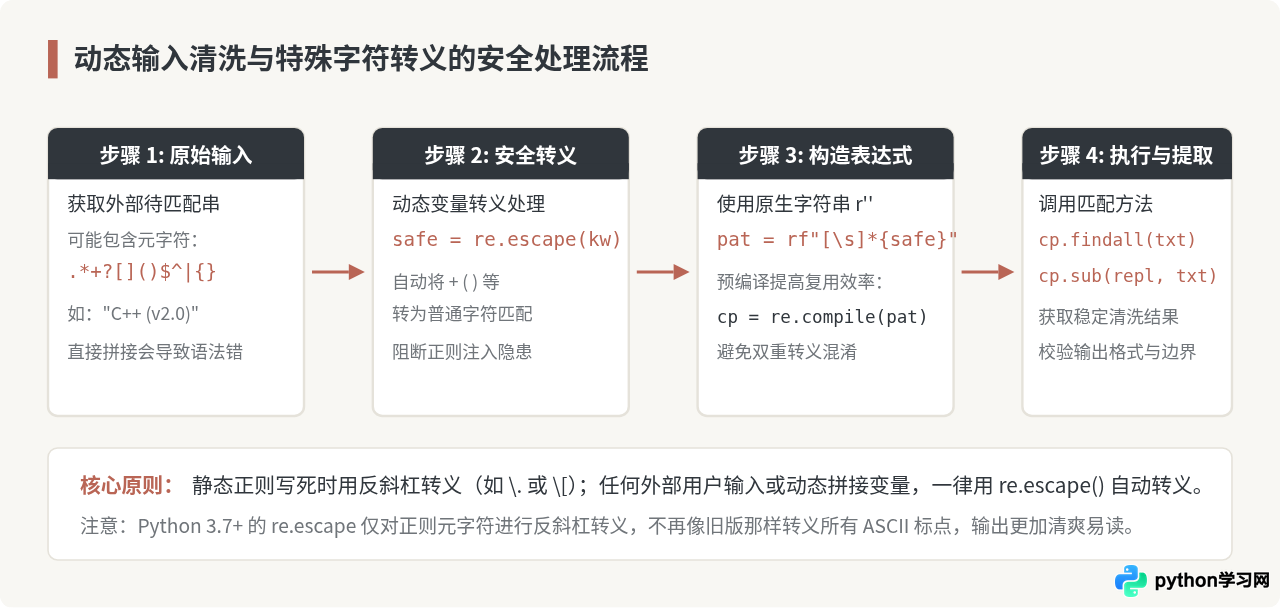
四、综合实战案例:清洗杂乱混合文本
在实际文本预处理工程中,上述三个需求往往是交织在一起的:原始文本包含网页残留标签、不可见的制表符与多余换行符、特殊符号以及中英文混合内容。
下面是一个工业级文本清洗管道的参考实现:
import re

raw_dirty_data = """
<div class="post-item">
    <h4>【技术快报】Python 3.12 正式发布!</h4>
    <p>新特性包括:更清晰的错误回溯、
       性能提升约 5%~10% (官方评估);</p>
    <span>价格: $0.00 | 联系: service@python.org</span>
</div>
"""

def clean_mixed_content(html_text: str) -> str:
    # 步骤 1:利用 re.S 跨行剥离所有 HTML 标签
    no_html = re.sub(r'<[\s\S]*?>', '', html_text)

    # 步骤 2:规整多余的换行符与连续空白字符(替换为单个空格或换行)
    normalized_spaces = re.sub(r'[\r\n\t]+', '\n', no_html)

    # 步骤 3:按行清洗并去除行首行尾空白
    lines = [line.strip() for line in normalized_spaces.split('\n') if line.strip()]

    return "\n".join(lines)

clean_result = clean_mixed_content(raw_dirty_data)
print("=== 清洗后的规整文本 ===")
print(clean_result)
示例输出:
=== 清洗后的规整文本 ===
【技术快报】Python 3.12 正式发布!
新特性包括:更清晰的错误回溯、
性能提升约 5%~10% (官方评估);
价格: $0.00 | 联系: service@python.org
五、总结与高频排错决策指南
为方便在调试正则匹配异常时快速定位根因,我们将中文匹配、换行符跨行与特殊字符处理的核心考量整理为排错决策树:
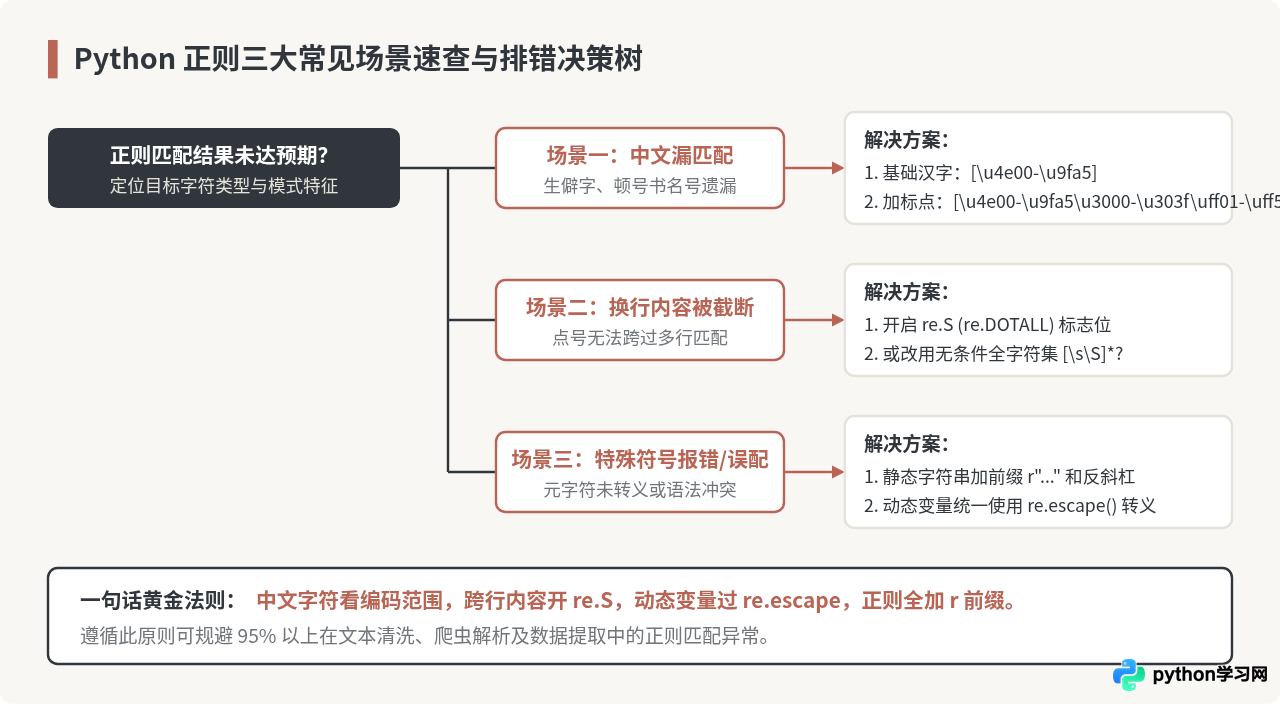
最后,在频繁调用或大批量数据循环处理时,推荐使用 re.compile() 将正则模式提前编译为模式对象,以消除重复解析表达式的运行时开销。熟练结合字符区间、匹配标志与安全转义函数,便能从容应对各类复杂文本清洗任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















